oracle 一次undo坏块案例
一、背景概述
2021-02-10 9:00
工程师接到客户电话,数据库delete数据一直卡住。
2021-02-10 10:00
客户提供堡垒机远程方式,美创工程师登录操作系统,发现数据库异常卡顿,后台有大量等待事件,磁盘io已经达到峰值
2021-02-11 23:00
数据库重新起停时间需要2小时以上,且磁盘io一直处于写满状态,且再最后一次启动数据库后,undo出现坏块,需要客户进行排查磁盘是否损坏
2021-02-19 09:00
接到客户通知,磁盘修复成功。美创工程师重新连入数据库,修复坏块,重新打开数据库
二、本次问题的细节
undo段坏块处理
在磁盘修复成功后,美创工程师重新启动数据库,但是smon进程监控到#116数据文件存在坏块,也就是undo段仍然存在坏块,无法进行回滚,为了保持数据库的一致性,smon进程直接关闭数据库了

需要新建undotbs2表空间替换掉已经坏掉的undotbs1表空间。但是数据库只有在open的状态下才能创建新的undo表空间。
为了防止SMON进程再次检测到坏块关闭数据库,美创工程师将有坏块的#116数据文件进行offline drop处理。
startup mount
alter database datafile 116 offline drop;
打开数据库,创建新的undo表空间,并设置为默认表空间
create undo tablespace undotbs2 datafile '/oradata/ETL/UNDOTBS2.dbf' size 1G autoextend on;
alter system set undo_tablespace=undotbs2 scope=both;
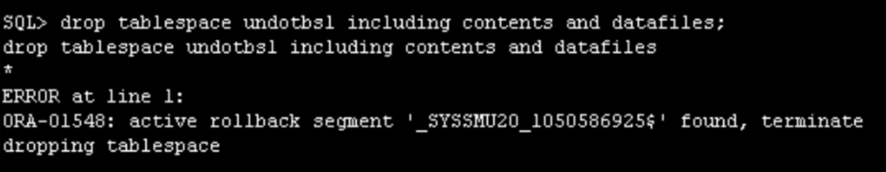
删除旧的表空间,但是原undo表空间仍然存在活跃的undo段
drop tablespace undotbs1 including contents and datafiles;
查询相关视图,获取所有原undo表空间仍活跃的undo段
select status,segment_name from dba_rollback_segs where status not in ('OFFLINE') and tablespace_name='UNDOTBS1';
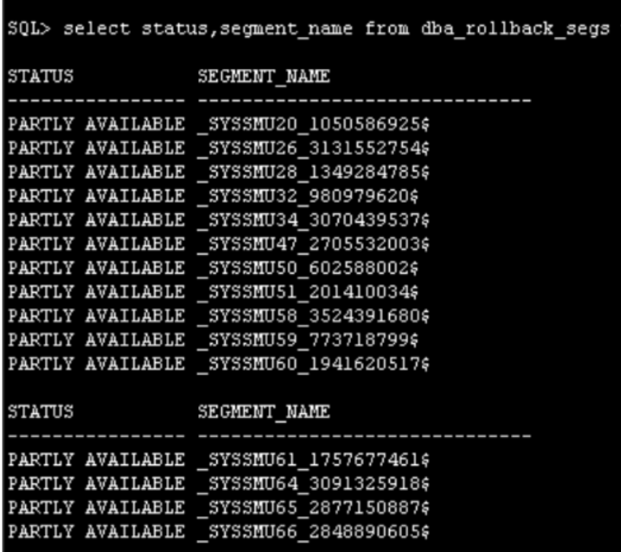
添加隐含参数至pfile参数文件中,跳过以上查出的所有undo段
*._allow_resetlogs_corruption=true
#._allow_terminal_recovery_corruption=true
*._corrupted_rollback_segments=(_SYSSMU10_1197734989$,_SYSSMU20_1050586925$,_SYSSMU26_3131552754$
,_SYSSMU28_1349284785$,_SYSSMU32_980979620$,_SYSSMU34_3070439537$,_SYSSMU47_2705532003$,
_SYSSMU50_602588002$,_SYSSMU51_201410034$,_SYSSMU58_3524391680$,_SYSSMU59_773718799$,
_SYSSMU60_1941620517$,_SYSSMU61_1757677461$,_SYSSMU64_3091325918$,_SYSSMU65_2877150887$,
_SYSSMU66_2848890605$)
关闭数据库,以修改后的pfile文件进行启动数据库
startup pfile=/oracle/product/11.2.0/db_1/dbs/initETL.ora;
删除旧的表空间及其的所有数据,成功!
drop tablespace undotbs1 including contents and datafiles;
至此,新的undo表空间替换成功!数据库正常运行!
注意:将参数文件中添加的隐含参数注释掉,重新启动数据库
三、总结和建议
1 、确认数据库存储存在故障后,最好不要再对数据库进行读写或者启停操作,避免发生数据文件损坏。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/69980685/viewspace-3002725/ ,如需转载,请注明出处,否则将追究法律责任。

