长事务与子事务
前言
今天生产中又碰到了一起子事务相关的性能问题,很早之前翻译了一篇,但不足以解释今天发生的问题,特翻译此篇,基本差不多能解释今天的现象,长事务,DBkiller!
消除PostgreSQL子事务
自去年 6 月以来,我们注意到 GitLab.com 上的数据库会神秘地停顿几分钟,这导致了用户在此期间看到 500个错误。经过数周的艰苦调查,我们终于找到了造成这种情况的原因:当一个长事务正在进行时,通过 SAVEPOINT SQL查询启动子事务可能会对数据库副本造成严重破坏。因此发起了一场我们最近完成的竞赛,以消除我们代码中的所有SAVEPOINT查询。以下是发生的事情、我们如何发现问题以及我们采取了哪些措施来解决它
症状开始
6 月 24 日,我们注意到我们的 CI/CD runners 服务报告了高错误率
快速调查显示,用于检索CI/CD构建数据的数据库查询出现了超时现象,未处理的构建积压文件以很高的速度增长。
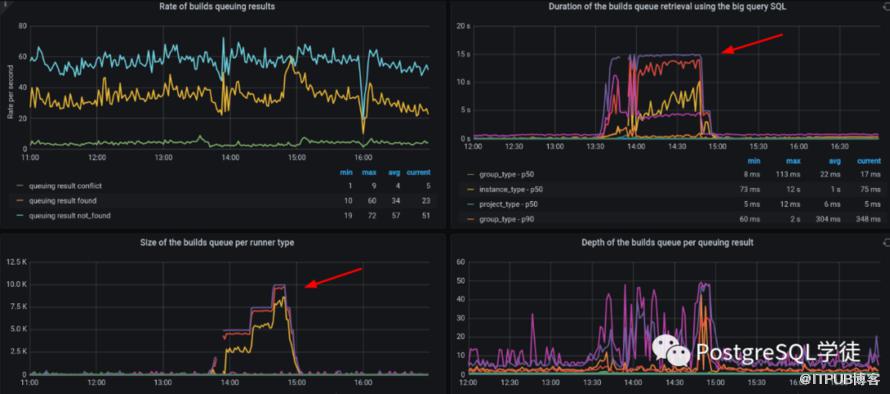
我们的监控还显示,一些SQL查询正在等待PostgreSQL轻量级锁(LWLocks)。
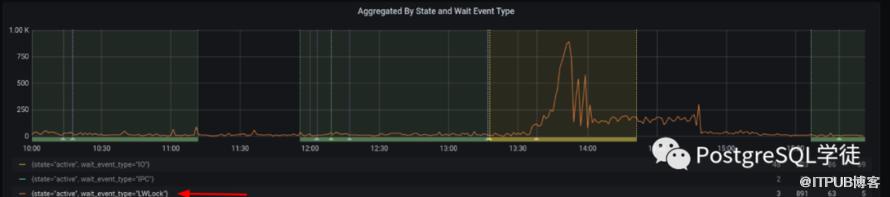
在接下来的几个星期里,我们经历了几次这样的偶发事件。我们惊讶地发现,这些性能下降是如此突然,而且恢复正常的速度又是如此之快
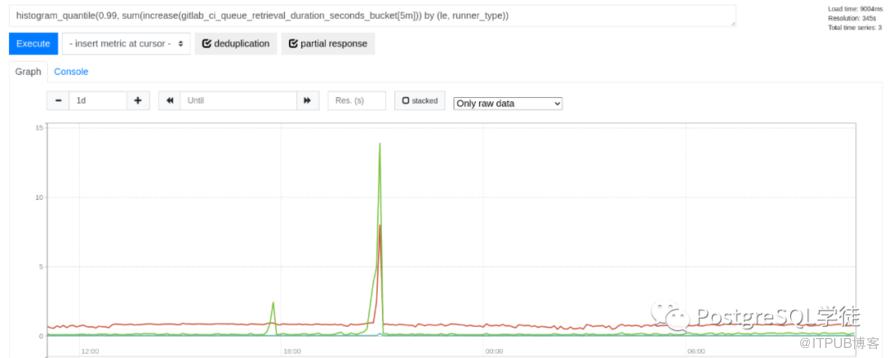
停滞的数据库查询
为了了解更多,我们扩展了我们的可观察性工具,从pg_stat_activity中采样更多的数据。在PostgreSQL中,pg_stat_activity虚拟表包含了系统中所有数据库连接的列表以及它们正在等待的事件,例如来自客户端的SQL查询。我们观察到一个一致的点:查询正在等待SubtransControlLock。下面显示了被暂停的url或作业的图表
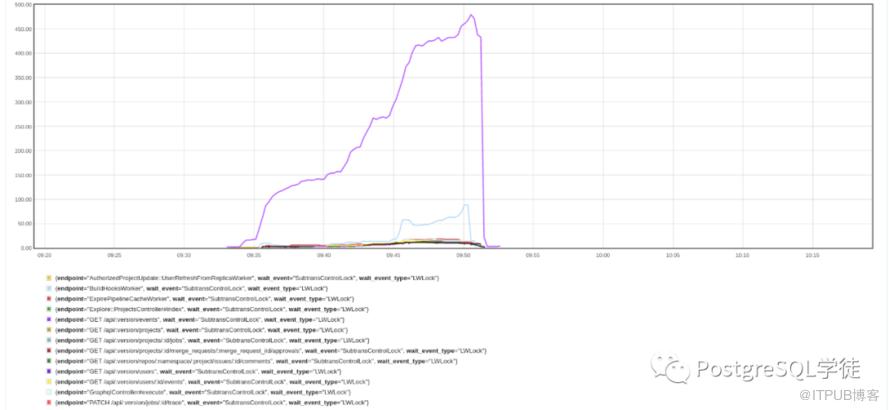
紫色线条显示了被SubtransControlLock锁住的事务的采样数量,这个POST /api/v4/jobs/request endpoint用于GitLab和处理CI/CD作业的GitLab Runners之间的内部通信。
虽然这个端点受到的影响最大,但整个数据库集群似乎也受到了影响,因为许多其他无关的查询都超时了。
同样的情况会随机出现。一个星期过去了,没有发生任何事件,然后它就会出现15分钟,然后消失几天。我们是在追赶尼斯湖水怪吗?
让我们把这些停滞不前的查询称为 "尼斯湖水怪",以示有趣。
什么是savepoint
要理解SubtransControlLock(PostgreSQL 13将其重命名为SubtransSLRU),我们首先必须理解PostgreSQL中的子事务是如何工作的。在PostgreSQL中,事务可以通过BEGIN语句启动,子事务可以通过后续的SAVEPOINT语句启动。当一个事务或子事务需要一个事务ID时,通常在客户端修改数据之前,PostgreSQL会为每个事务分配一个事务ID(简称XID)。
为什么需要使用savepoint
例如,假设您正在运行一个在线商店,有一个客户下了订单。在完成订单之前,系统需要确保存在该用户的信用卡帐户。在Rails中,常见的模式是为订单启动一个事务,并调用find或create by。例如
Order.transaction do
  begin
    CreditAccount.transaction(requires_new: true) do
      CreditAccount.find_or_create_by(customer_id: customer.id)
  rescue ActiveRecord::RecordNotUnique
    retry
  end
  # Fulfill the order
  # ...
end如果在同一时间下了两个订单,您不希望创建重复的帐户导致其中一个订单失败。相反,你会希望系统说,"噢,刚创建了一个帐户;我用这个"。这就是子事务派上用场的地方:require new: true告诉Rails,如果应用程序已经在一个事务中,就启动一个新的子事务。上面的代码转换成几个SQL调用,看起来像这样
--- Start a transaction
BEGIN
SAVEPOINT active_record_1
--- Look up the account
SELECT * FROM credit_accounts WHERE customer_id = 1
--- Insert the account; this may fail due to a duplicate constraint
INSERT INTO credit_accounts (customer_id) VALUES (1)
--- Abort this by rolling back
ROLLBACK TO active_record_1
--- Retry here: Start a new subtransaction
SAVEPOINT active_record_2
--- Find the newly-created account
SELECT * FROM credit_accounts WHERE customer_id = 1
--- Save the data
RELEASE SAVEPOINT active_record_2
COMMIT在上面第7行,如果已经创建了客户帐户,并且数据库唯一约束将防止重复条目,那么INSERT可能会失败。如果没有第一个SAVEPOINT和ROLLBACK块,整个事务将会失败。使用该子事务,事务可以优雅地重试并查找现有帐户
什么是SubtransControlLock?
正如我们前面提到的,尼斯湖水怪在随机时间发生,并等待SubtransControlLock的查询。SubtransControlLock表示该查询正在等待PostgreSQL将子事务数据从磁盘加载到共享内存中。
为什么需要这些数据?例如,当客户端运行SELECT时,PostgreSQL需要确定行(称为元组)的每个版本是否在当前事务中实际可见。可能一个元组已经被删除,或者还没有被另一个事务提交。由于只有顶层事务才能实际提交数据,PostgreSQL需要将子事务ID (subXID)映射到其父事务ID。
subXID到父事务ID的映射存储在磁盘的pg_subtrans目录中。由于从磁盘读取很慢,PostgreSQL在每个后端进程的前面添加了一个简单的最近最少使用(SLRU)缓存。如果已经缓存了所需的页面,则查找速度很快。但是,根据 Laurenz Albe在博客中所写,如果给定事务中活动子事务的数量超过 64,PostgreSQL 可能需要从磁盘读取,条件术语叫做suboverflow。把它想象成你吃了太多赛百味三明治的感觉。subboverflows(这是一个词吗?)会降低性能,因为正如Laurenz所说,"其他事务必须更新pg_subtrans来注册子事务,您可以在perf的输出中看到它们如何与reader争夺轻量级锁"。
寻找嵌套的子事务
Laurenz的博客文章指出,我们可能在一个事务中使用了太多的子事务。起初,我们怀疑我们可能会在一些昂贵的后台工作中这样做,比如项目导出或导入。然而,尽管我们在这些作业中确实看到了大量的SAVEPOINT调用,但在本地测试中并没有看到不寻常的嵌套程度。
为了分离原因,我们首先添加了Prometheus指标,以按模型作为Prometheus指标跟踪子事务。这就得到了如下的图表

虽然这有助于查看子事务随时间变化的速率,但我们没有看到在数据库停滞前后出现任何明显的峰值。尽管如此,仍有可能发生suboverflow。为了查看是否发生了这种情况,我们对应用程序进行了检测,以跟踪子事务并在给定事务中检测到超过 32 个 SAVEPOINT 调用时记录日志。Rails 使应用程序可以通过 ActiveSupport 通知订阅其所有 SQL 查询。我们的工具看起来像这样,为了讨论的目的进行了简化:
ActiveSupport::Notifications.subscribe('sql.active_record') do |event|
  sql = event.payload.dig(:sql).to_s
  connection = event.payload[:connection]
  manager = connection&.transaction_manager

  context = manager.transaction_context
  return if context.nil?

  if sql.start_with?('BEGIN')
    context.set_depth(0)
  elsif cmd.start_with?('SAVEPOINT', 'EXCEPTION')
    context.increment_savepoints
  elsif cmd.start_with?('ROLLBACK TO SAVEPOINT')
    context.increment_rollbacks
  elsif cmd.start_with?('RELEASE SAVEPOINT')
    context.increment_releases
  elsif sql.start_with?('COMMIT', 'ROLLBACK')
    context.finish_transaction
  end
end这段代码查找启动事务和子事务的关键SQL命令,并在事务和子事务发生时增加计数器。在COMMIT之后,我们记录一个JSON消息,其中包含了反向跟踪以及SAVEPOINT和RELEASE调用的数量。例如
{
  "sql": "/*application:web,correlation_id:01FEBFH1YTMSFEEHS57FA8C6JX,endpoint_id:POST /api/:version/projects/:id/merge_requests/:merge_request_iid/approve*/ BEGIN",
  "savepoints_count": 1,
  "savepoint_backtraces": [
    [
      "app/models/application_record.rb:75:in `block in safe_find_or_create_by'",
      "app/models/application_record.rb:75:in `safe_find_or_create_by'",
      "app/models/merge_request.rb:1859:in `ensure_metrics'",
      "ee/lib/analytics/merge_request_metrics_refresh.rb:11:in `block in execute'",
      "ee/lib/analytics/merge_request_metrics_refresh.rb:10:in `each'",
      "ee/lib/analytics/merge_request_metrics_refresh.rb:10:in `execute'",
      "ee/app/services/ee/merge_requests/approval_service.rb:57:in `calculate_approvals_metrics'",
      "ee/app/services/ee/merge_requests/approval_service.rb:45:in `block in create_event'",
      "ee/app/services/ee/merge_requests/approval_service.rb:43:in `create_event'",
      "app/services/merge_requests/approval_service.rb:13:in `execute'",
      "ee/app/services/ee/merge_requests/approval_service.rb:14:in `execute'",
      "lib/api/merge_request_approvals.rb:58:in `block (3 levels) in <class:MergeRequestApprovals>'",
    ]
  "rollbacks_count": 0,
  "releases_count": 1
}这个日志消息不仅包含通过savepoints_count保存的子事务的数量,而且还包含一个方便的backtrace,可以确定问题的确切来源。sql字段还包含 Marginalia comments,我们将这些注释添加到每个sql查询中。这些注释可以识别是哪个HTTP请求发起了SQL查询。
认真研究PostgreSQL
新的工具表明,虽然应用程序经常使用子事务,但它从未超过10个嵌套的SAVEPOINT调用。与此同时,Postgres.ai的创始人Nikolay Samokhvalov 进行了一系列测试,试图复现这个问题。当单个事务超过 64 个子事务时,他复制了 Laurenz 的结果,但这里并没有发生这种情况。
当数据库阻塞发生时,我们观察到了几种现象:
1.只有备库被影响了,主库没有被影响,保持正常2.在此期间有一个长时间运行的事务,通常与PostgreSQL的autovacuum有关。事务结束后,阻塞很快停止。
这有什么关系呢?在分析PostgreSQL源代码时,高级支持工程师Catalin Irimie提出了一个有趣的问题,使我们在理解上取得了突破
Does this mean that, having subtransactions spanning more than 32 cache pages, concurrently, would trigger the exclusive SubtransControlLock because we still end up reading them from the disk?
这是否意味着,有超过32个缓存页的子事务,同时进行,会触发独占的SubtransControlLock,因为我们最终还是要从磁盘上读取它们?
在备库重现问题
为了回答这个问题,Nikolay立即修改了他的测试,使其包含备库和长事务。一天之内,他又出现了这个问题
上图显示,交易率稳定在每秒36万笔(TPS)左右。在主库上启动长事务之前,一切都很正常。然后,备库的交易率突然暴跌至5万TPS。取消长事务后,迅速恢复正常。
这里发生了什么?
Nikolay 在他的博客中将问题称为Subtrans SLRU overflow。在繁忙的数据库中,子事务日志的大小可能会增长得如此之大,以至于工作集不再适合内存。这会导致大量缓存miss,进而导致大量磁盘 I/O 和 CPU,因为 PostgreSQL 疯狂地尝试从磁盘加载数据以跟上所有查找。
如前所述,子事务缓存保存了subXID到父事务ID的映射关系。当PostgreSQL需要查找subXID时,它计算这个ID将位于哪个内存页面,然后在内存页面中进行线性搜索。如果页面不在缓存中,它会逐出一个页面并将所需的页面加载到内存中。下图显示了子事务SLRU的内存布局。
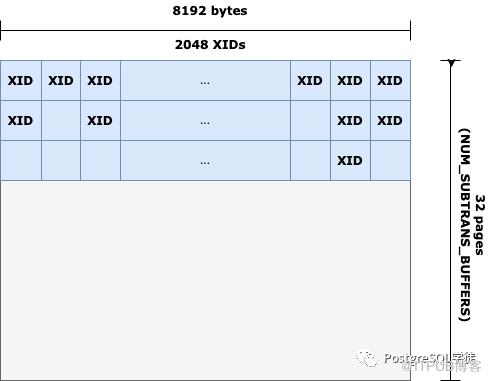
默认情况下,每个 SLRU 页面是一个 8K的缓冲块,包含 4 字节的父事务ID。这意味着每个页面可以存储 8192/4 = 2048 个事务 ID。请注意,每页可能会有间隙。PostgreSQL将根据需要缓存XID,因此单个XID可以占据整个页面。
总共有32个(NUM_SUBTRANS_BUFFERS)页面,这意味着最多可以在内存中存储65K个事务id。Nikolay演示了在一个繁忙的系统中,填满所有65K条目大约需要18秒。然后性能急剧下降,导致备库不可用。
令我们惊讶的是,我们的实验还证明,如果同时发生许多写操作,那么长事务期间的单个SAVEPOINT就可能引发这个问题。也就是说,仅仅减少SAVEPOINT的使用频率是不够的,我们必须彻底消灭它们。
为什么单个savepoint会导致问题?
要回答这个问题,我们需要了解当长事务正在运行时在一个查询中发生 SAVEPOINT 时会发生什么。
前面我们提到,PostgreSQL 需要决定特定行是否可见以支持称为多版本并发控制或简称 MVCC 的功能。它通过在每个元组中存储隐藏列 xmin 和 xmax 来做到这一点。
xmin 保存元组创建时的 XID,xmax 保存元组被标记为死时的 XID(如果该行仍然存在,则为 0)。此外,在事务开始时,PostgreSQL 在数据库快照中记录元数据。除此之外,此快照在其自己的 xmin 和 xmax 值中记录了最旧的 XID 和最新的 XID。
此元数据帮助 PostgreSQL 确定元组是否可见。例如,在 xmin 之前开始的已提交 XID 肯定是可见的,而在 xmax 之后的任何内容都是不可见的。
这与长事务有什么关系?
长事务通常情况下是不好的,因为它们会占用连接,但它们可能会在备库上导致细微的不同问题。在备库上,长事务期间的单个 SAVEPOINT会导致suboverflow。请记住,在我们有超过 64 个子事务的情况下,这会拖累性能。
从根本上说,问题的发生是因为副本在创建快照和检查元组可见性时的行为与主副本不同。下图说明了 PostgreSQL 中使用的一些数据结构的示例:
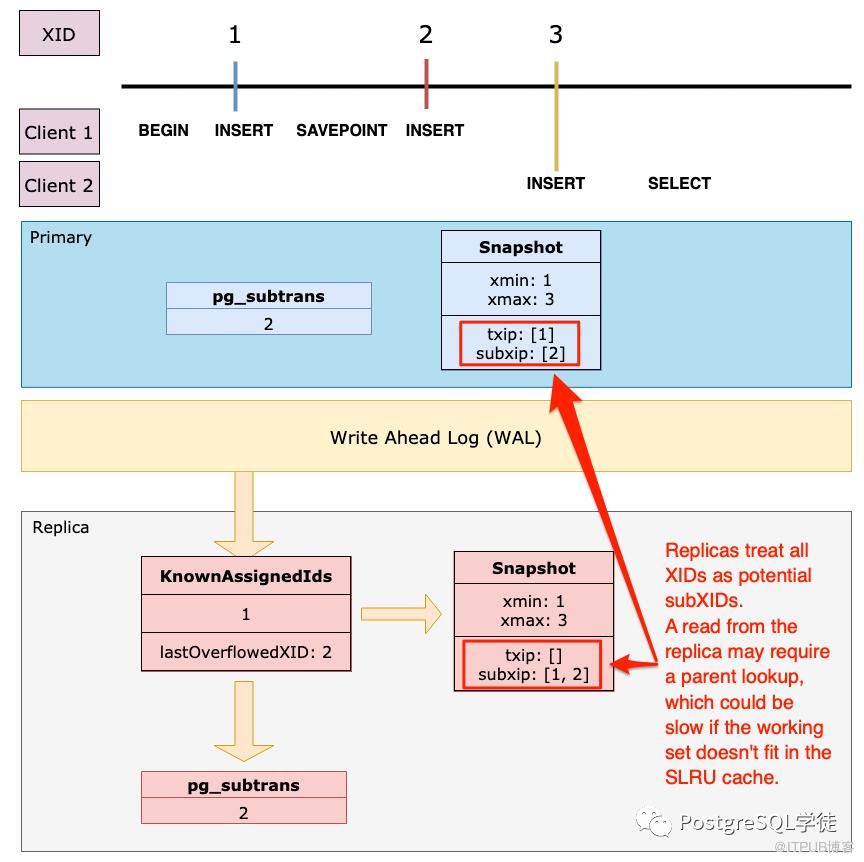
在这个图的顶部,我们可以看到xid在子事务的开始处增加:BEGIN之后的INSERT得到1,而SAVEPOINT中随后的INSERT得到2。另一个客户端在XID 3上执行INSERT和SELECT操作。在主库上,PostgreSQL将正在进行的事务存储在一个共享内存段中。进程数组(procarray)存储第一个连接的XID 1,数据库还将该信息写入pg_xact目录。XID 2存储在pg_subtrans目录中,映射到它的父目录XID 1。
如果在主库上发生读操作,生成的快照包含xmin为1,xmax为3。Txip持有一个正在进行的事务列表,而subxip持有一个正在运行的子事务列表。
但是,不管是procarray还是快照都不能直接与备库共享。备库从预写日志(WAL)中接收所需的所有数据。
每次回放WAL的一个条目,备库会生成一个名为KnownAssignedIds的共享数据结构。它包含主库上正在进行的所有事务。由于这个结构只能容纳有限数量的id,所以具有大量活动子事务的繁忙数据库可以很容易地填满这个缓冲区。PostgreSQL做了一个设计选择,将所有subxid从这个列表中剔除,并将它们存储在pg_subtrans目录中。
当在副本上生成快照时,请注意txip是如何为空的。PostgreSQL备库将所有xid视为子事务,并将它们扔到subxip桶中。这是可行的,因为如果XID有父XID,那么它就是子事务。否则,这是一个正常的交易。代码注释解释了基本原理。
然而,这意味着快照缺少subxid,这可能对MVCC不利。为了处理这个问题,备库也更新lastoverflowwedxid
 * When we throw away subXIDs from KnownAssignedXids, we need to keep track of
 * that, similarly to tracking overflow of a PGPROC's subxids array.  We do
 * that by remembering the lastOverflowedXID, ie the last thrown-away subXID.
 * As long as that is within the range of interesting XIDs, we have to assume
 * that subXIDs are missing from snapshots.  (Note that subXID overflow occurs
 * on primary when 65th subXID arrives, whereas on standby it occurs when 64th
 * subXID arrives - that is not an error.)
那么什么是"range of interesting XIDs",我们可以从下面的代码中窥见一二
if (TransactionIdPrecedesOrEquals(xmin, procArray->lastOverflowedXid))
suboverflowed = true;如果lastoverflowwedxid小于快照的xmin,这意味着所有的子事务已经完成,所以我们不需要检查子事务。但是,在我们的示例中:
1.由于事务,xmin为1。2.lastOverflowXid为2,因为存在SAVEPOINT。
这意味着这里的suboverflowed设置为 true,它告诉 PostgreSQL 每当需要检查 XID 时,检查它是否有父 XID。请记住,这会导致 PostgreSQL:
1.在 SLRU 缓存中查找父 XID 的 subXID。2.如果缓存中不存在,则从 pg_trans 获取数据。
在繁忙的系统中,请求的 XID 可能跨越不断增长的值范围,这很容易耗尽 SLRU 缓存中的 64K 条目。只要交易运行,这个范围就会继续增长,增加的速度取决于主节点上发生了多少更新。一旦事务终止,suboverflowed 状态就会设置为 false。
换句话说,我们已经复制了与我们在 64 个子事务中看到的相同的条件,只是使用了一个 SAVEPOINT 和一个长事务。
我们该怎么做才能摆脱尼斯湖水怪呢
有三个选项:
1.完全消除SAVEPOINT调用。2.消除所有长时间运行的事务。3.将Andrey Borodin的补丁应用到PostgreSQL,并增加子事务缓存。
我们选择了第一个选项,因为大多数使用的子事务可以相当容易地删除。我们采取了很多方法
1.在子事务之外执行更新。例如:1, 22.重写一个查询,使用INSERT或UPDATE语句,并使用ON CONFLICT子句来处理重复的约束冲突。示例:1, 2, 33.使用非原子的find_or_create_by。我们很少使用这种方法。例如:1
此外,我们在应用程序使用单个SAVEPOINT时添加了一个警报

这样做的附带好处是可以标记一个小错误。
为什么不消除所有的长事务?
在我们的数据库中,消除所有长时间运行的事务是不现实的,因为我们认为其中许多事务是通过数据库autovacuum发生的,但我们还不能重现这种情况。我们正在对表进行分区,并对数据库进行分片,但这比删除所有子事务要耗时得多。
那么补丁呢?
尽管我们测试了 Andrey 的 PostgreSQL 补丁,但我们对偏离官方 PostgreSQL 版本感到不舒服。此外,在升级过程中维护自定义补丁版本会给我们的基础架构团队增加显着的维护负担。我们的自我管理客户也不会受益,除非他们使用打过补丁的数据库。
Andrey 的补丁主要做两件事情:
1.允许管理员将 SLRU 大小更改为任何值。2.添加关联缓存。使其高效地使用大缓存值。
请记住,SLRU 缓存对所需页面进行线性搜索。当只有 32 个页面要搜索时,这很好用,但如果将缓存大小增加到 100 MB,搜索就会变得更加昂贵。关联缓存通过使用位掩码索引页面并使用与剩余位的偏移量来查找条目,从而使查找速度更快。这缓解了问题,因为事务需要长几个数量级才能导致问题。
Nikolay 证明,只要我们使用这些补丁将 SLRU 大小增加到 100 MB,SAVEPOINT 问题就会消失。凭借100 MB的缓存,PostgreSQL 可以缓存 2620 万个 ID (104857600/4),远远超过区区的 65K。这些补丁目前正在等待审核,但我们认为它们应该在 PostgreSQL 15 中得到高度优先考虑。
小结
自从删除了所有的SAVEPOINT查询,我们再也没有看到尼斯湖水怪抬起头来。如果你正在运行PostgreSQL的只读库,我们强烈建议你也删除所有的子事务,直到进一步通知。PostgreSQL是一个非常棒的数据库,它的注释良好的代码使人们能够理解它在不同配置下的局限性。我们要感谢GitLab社区在我们解决这个生产问题的过程中对我们的支持。我们还感谢 Nikolay Samokhvalov和 Catalin Irimie的支持,他们为了解我们的尼斯湖的情况作出了贡献
原文译自 https://about.gitlab.com/blog/2021/09/29/why-we-spent-the-last-month-eliminating-postgresql-subtransactions/#the-symptoms-begin
原文作者:PostgreSQL学徒;如有侵权,请联系管理员删除。

