子事务的危害
PostgreSQL Subtransactions Considered Harmful
本文讨论了什么是子事务,如何创建子事务,以及它们目前的使用范围有多广。接下来,我们试图了解为什么在那些经常和高负载系统打交道的PostgreSQL专家口中,子事务的名声不太好。我们大致描述了在使用子事务且负载持续增长的Postgres数据库中可能出现的四个问题。最后,我们讨论了PostgreSQL用户的短期和长期选择,他们愿意解决正在发生的或防止未来与子事务有关的问题。
什么是子事务
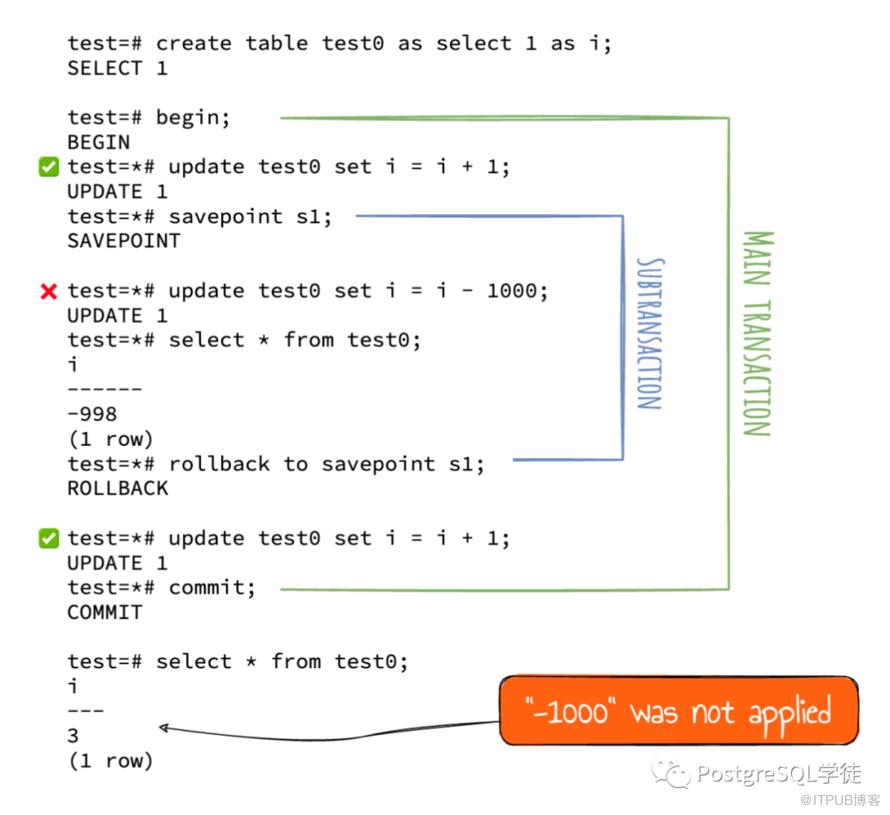
子事务,也被称为"嵌套事务",是在一个已经启动的事务范围内,由指令启动的事务(定义来自维基百科)。该特性允许用户回滚部分事务,这在许多情况下很有帮助:如果发生错误,只需重复更少的步骤来重试该操作
SQL标准定义了描述这种机制的两个基本指令:SAVEPOINT以及ROLLBACK语句的扩展,ROLLBACK TO SAVEPOINT
<savepoint statement> ::=
  SAVEPOINT <savepoint specifier>

<savepoint specifier> ::=
  <savepoint name>

<rollback statement> ::=
  ROLLBACK [ WORK ] [ AND [ NO ] CHAIN ] [ <savepoint clause> ]
<savepoint clause> ::=
TO SAVEPOINT <savepoint specifier>同时还定义了RELEASE SAVEPOINT,允许删除一个"active"的savepoint信息
<release savepoint statement> ::=
RELEASE SAVEPOINT <savepoint specifier>PostgreSQL从8.0开始支持嵌套事务(2004年6月的commit),与SQL标准相比,它支持的语法略有不同,允许在RELEASE和ROLLBACK语句中省略SAVEPOINT这个词
•SAVEPOINT savepoint_name (doc)•ROLLBACK [ WORK | TRANSACTION ] TO [ SAVEPOINT ] savepoint_name (doc)•RELEASE [ SAVEPOINT ] savepoint_name (doc)
下面是一个简单的演示
谁在使用子事务
可能,你也在用。
目前,大多数流行的ORMs和框架都原生支持嵌套事务。下面是一些例子:
•Django•SQLAlchemy•Ruby on Rails / Active Record•Sequel•Spring Framework•JOOQ•Yii 2.0•GORM•Sequelize (sometimes, in a weird form)
除了savepoints,还有一些其他的方式创建子事务
1.在 PL/pgSQL中的BEGIN / EXCEPTION WHEN .. / END代码块(官方文档对这一块并没有过多描述,例如在本文中,做了一些阐述 "PL/PgSQL Exception and XIDs")2.PL/Python代码中的plpy.subtransaction()
人们可能会认为,许多使用PL/pgSQL或PL/Python函数的应用程序都会使用子事务。运行基于 PostgREST, Supabase, Hasura等构建的API的系统可能有PL/pgSQL函数(包括触发器函数),里面会涉及到BEGIN / EXCEPTION WHEN . / END;在这种情况下,这些系统使用子事务。
问题1:事务增长
子事务的一个基本问题是,它们会增加全局事务ID,即XID。与普通事务一样,只有在涉及到一些修改动作的情况下才会发生,但如果有多个嵌套的子事务,则所有的子事务都被分配了自己的XID,即使在内部发生了单个修改——大多数情况都是这样。
让我们看看,在一个没有活动发生的数据库中
test=# create table test1(i int8);
CREATE TABLE

test=# begin;
BEGIN
test=*# select pg_current_xact_id(); -- use txid_current() in Postgres 12 or older
 pg_current_xact_id
--------------------
         1549100656
(1 row)

test=*# insert into test1 select 1;
INSERT 0 1
test=*# savepoint s1;
SAVEPOINT
test=*# insert into test1 select 2;
INSERT 0 1
test=*# savepoint s2;
SAVEPOINT
test=*# savepoint s3;
SAVEPOINT
test=*# insert into test1 select 3;
INSERT 0 1
test=*# commit;
COMMIT


test=# select pg_current_xact_id();
 pg_current_xact_id
--------------------
         1549100660
(1 row)

test=# select ctid, xmin, xmax, i from test1;
 ctid  |    xmin    | xmax | i
-------+------------+------+---
 (0,1) | 1549100656 |    0 | 1
 (0,2) | 1549100657 |    0 | 2
 (0,3) | 1549100659 |    0 | 3
(3 rows)在这个例子中,主事务ID是XID = 1549100656,额外的事务ID——1549100657, 1549100658, 1549100659,分别分配给了SAVEPOINTs s1、s2、s3所定义的子事务。所以,即便他们是在同一个事务中插入的,表中元组也有不同的xmin值(有关xmin的更多信息,参照 "5.5 System Columns")。注意XID=1549100658并没有用到xmin中,因为在savepoint s2;和savepoint s3;之间并没有元组被插入。
总的来说,使用了四个XID,而不是单个XID,就像在没有子事务的事务中一样。
这个例子清楚地展示了两个可能不太直观的事实
1.分配给子事务的XID在元组头中会使用到,因此会参与MVCC元组可见性检查,尽管在主事务提交之前,子事务的结果对其他事务是不可见的(在PostgreSQL中,支持的"最小"隔离级别是READ committed)。2.子事务会导致全局XID的增长(32位,需要特殊的维护操作,通常由autovacuum完成)。因此他会隐式增加事务ID回卷的风险:如果刚刚提到的维护动作因为某些原因滞后了,并且这个问题没有得到解决的话,那么系统可能会达到某个点,即事务ID回卷的保护机制会将实例置为单用户模式,从而导致很长一段的停机时间(看看流行的SaaS系统是如何因此而崩溃的例子:Sentry, Mailchimp)比方说,可能每秒有1000个写事务,但是如果它们都使用10个子事务,那么XID将每秒增加10000个。这可能不是用户所期望的——疲惫的autovacuum需要更频繁地在 "防止事务ID回卷"的模式下运行,如果子事务在每个事务内有 "本地 "ID,而不是 "浪费 "全局XID的话。
底线:在积极使用子事务和XID增长之间存在一种权衡。理解使用子事务的这种"代价"对于在高负载系统中避免类似的问题至关重要。
问题2:单个会话cache overflow
当我们开始深入研究PostgreSQL子事务的性能,使用谷歌,并阅读Cybertec关于PostgreSQL子事务性能的博客文章时,就很容易发现这个问题的细节。
每个会话的活动子事务数有一个阈值,超过该阈值会带来额外的性能损失:PGPROC_MAX_CACHED_SUBXIDS,默认为 64,只能在 Postgres 源代码中更改:
/*
 * Each backend advertises up to PGPROC_MAX_CACHED_SUBXIDS TransactionIds
 * for non-aborted subtransactions of its current top transaction.  These
 * have to be treated as running XIDs by other backends.
 *
 * We also keep track of whether the cache overflowed (ie, the transaction has
 * generated at least one subtransaction that didn't fit in the cache).
 * If none of the caches have overflowed, we can assume that an XID that's not
 * listed anywhere in the PGPROC array is not a running transaction.  Else we
 * have to look at pg_subtrans.
 */
#define PGPROC_MAX_CACHED_SUBXIDS 64    /* XXX guessed-at value */
Cybertec的Laurenz Albe在他的博客"PostgreSQL Subtransactions and performance"中很好地讨论了这个问题。
我们在这个GitLab issue中重现了这些基准测试,并详细记录了它们:https://gitlab.com/postgres-ai/postgresql-consulting/tests-and-benchmarks/-/issues/20。任何人都可以在任何机器上用任何PostgreSQL版本做同样的事情,并测量当超过阈值时的"惩罚"程度。
在同样的GitLab issue中,你可以找到下面的一些额外信息:
调整基准进行比较——我们没有删除 SAVEPOINT 命令,而是将它们替换为普通的SELECT命令。这样做是为了避免减少事务中的语句数量,因此RTTs 的数量是稳定的。这有助于我们确认,少量的子事务不会增加显著的开销——即使说,我们使用了其中的50个。然而,当我们超过 PGPROC_MAX_CACHED_SUBXIDS 阈值时,性能确实会下降:

如果我们运行RELEASE SAVEPOINT语句来保持活动子事务的数量低于PGPROC_MAX_CACHED_SUBXIDS,会发生什么?结果表示,当超过了PGPROC_MAX_CACHED_SUBXIDS定义的阈值时,性能不会发生下降,即使我们在每个事务中总共创建了100个子事务。
结论:使用子事务时,避免会话中的活动子事务超过 PGPROC_MAX_CACHED_SUBXIDS(默认为 64)。这应该是一种罕见的情况,但仍值得当心。ORM 用户可能希望在子事务嵌套深度太大的情况下实现日志记录或监视事件。
问题3:Multixact IDs的不当使用
Nelson Elhage在"Notes on some PostgreSQL implementation details"中调查了这个问题,这篇文章十分不错,强烈推荐阅读。值得注意的是,当您使用"google"搜索Postgres子事务性能时,要找到这篇文章相当困难,而且这种情况相当奇特,但仍然值得将其收纳在我们的目录中。
在这里,我们引用作者的观点简要概述这个问题。
那些在高负载系统中使用过SELECT ... FOR SHARE的读者可能知道它带来的性能风险。多个事务可以锁定同一行,使用所谓的Multixact ID和MultiXact存储。这种机制既方便又有帮助,但在大规模使用时,可能会出现可怕的性能问题。
关于MultiXact存储的一个有趣的事实是,条目是不可变的;如果一个新的事务锁定了一个已经锁定的行,则必须创建一个新的MultiXact ID,包含所有旧的事务ID和新ID。这意味着让N个进程同时锁定一行可能需要进行成倍的工作,因为每次都必须完整地复制事务id列表!这种行为通常没有问题,因为很多事务同时锁定同一行是很少见的,但这表明
SELECT FOR SHARE可能会导致灾难性的性能悬崖。
有经验的工程师知道这个问题,并尽量避免在重负载下使用SELECT ... FOR SHARE。还有一种机制,SELECT ... FOR UPDATE,当然,它有一些开销:锁定元组会立即使相应的页面成为脏页。然而,当人们需要在多个会话中处理大量的记录时,它是非常有用的——它有助于避免冲突,因此可以实现高吞吐量。直接的开销是值得付出的代价——最终,处理的结果是应用于锁定行的DELETE或UPDATE,所以元组应该是脏的。
但是,如果你将SELECT .. FOR UPDATE和子事务结合,情况会变得十分糟糕!
在负载下,我们看到对 Postgres 数据库的查询延迟急剧增加,吞吐量几乎下降到 0;数据库几乎完全锁定,并且在一段时间内几乎没有任何进展。在这些锁定期间,我们深入研究了 pg_stat_activity 和其他工具,并看到大量查询阻塞在一些明显相关的 wait_event/wait_event_type组合上:
•
LWLock:MultiXactMemberControlLock•LWLock:MultiXactOffsetControlLock•LWLock:multixact_member•LwLock:multixact_offset
然后,作者描述了引发性能问题的合成的病态工作负载,并提到需要付出很大的努力来确定问题
SELECT [some row] FOR UPDATE;
SAVEPOINT save;
UPDATE [the same row];
在这种情况下,他们使用的是Django;默认情况下,它使用子事务,因此解决方案是完全禁用它们
我们改变了内部的
transaction.atomic来传递savepoint=False,如果它已经在一个处于打开状态的事务中,它就会变成一个no-op,我们的问题立即消失了。
最后,作者提到了一位拥有Postgres专业知识的朋友的意见
子事务基本被诅咒了,把他们丢掉吧!
结论:尤其小心在那些包含子事务的事务中使用SELECT .. FOR UPDATE
问题4:Subtrans SLRU overflow
这个问题需要用更详细的形式来描述,因为我相信,越来越多的系统可能会遇到这个问题。这是最近在我们一个客户运行的高负载系统中观察到的(我希望他们很快能在另一篇博文中分享他们的经验;更新:这里便是"Why we spent the last month eliminating PostgreSQL subtransactions" (GitLab))。
主要的特征是:
1.在主库:使用到了子事务(即使很少使用它们,但也足够了),对一些记录进行更新(删除也可能是一个问题,尽管这需要再次检查);有一个正在运行的长事务;这里的"长"的确切含义取决于系统中 XID 的增长:比如说,如果你有 1k TPS 递增的 XID,那么问题可能会在几十秒后出现,所以"长" = "几十秒长",如果 你有 10k TPS,"长"可能意味着"几秒钟长"。所以在某些系统中,只是一个常规的慢查询可能会变成这样一个令人头疼的事务2.在备库:SELECT正在处理的相同元组被最近那些带有子事务的事务更改了
这个问题在这个GitLab issue中进行了分析并复现了 https://gitlab.com/postgres-ai/postgresql-consulting/tests-and-benchmarks/-/issues/21,在这里,我为那些没有时间阅读GitLab issue中提出的所有尝试的人提供一个简短的总结。
为了重现这个问题,我们需要至少两个PostgreSQL服务器,分别作为primary和hot standby。我们使用两个带有Ubuntu 20.04 和 PostgreSQL 14beta3的c5a.4xlarge类型的EC2实例(32GiB,16vCPU),其中PostgreSQL 14beta3安装了调整过的分支postgresql_cluster(一个由Vitaliy Kukharik开发和维护的方便的工具,用于自动安装PostgreSQL和各种附加组件,如Patroni)。为了从不同角度观察性能问题,我们使用了perf、Alexey Lesovsky 的 pgCenter、PostgresPro的pg_wait_sampling(其软件包可在PGDG官方Apt仓库中找到),以及一个优秀的监控工具Netdata,它允许导出监控仪表板,这样任何人都可以在之后探索所有的实验细节。
用于测试的数据库是一个标准的pgbench生成的数据库,其比例因子为1 (-s 1)。
在主库上,我运行了两种工作负载:
1.一个不变的事务流,包括3个SAVEPOINT和一个10,000行的UPDATE,使用pgbench和一个自定义的负载文件执行。echo "\\set id random(1, 10000)2.在另外一个单独的
begin;
savepoint s1;
savepoint s2;
savepoint s3;
update pgbench_accounts set aid = aid where aid = :id;
commit;" > updates_with_savepoints.sql
pgbench -rn -P2 -T3600 -c15 -j15 \
-f updates_with_savepoints.sql \
-M prepared \
test -U postgres \
2>&1 | ts | tee -a updates_with_savepoints.logpsql会话中,开启一个5分钟的事务,不做任何事情,除了获取一下下一个XID,然后休眠5分钟select txid_current(), pg_sleep_for('5 minutes') \watch 300
在备库,我使用pgbench,从10000 行中查询一行(与主库上正在更新的行相同)
echo "\\set id random(1, 10000)
select * from pgbench_accounts where aid = :id;" > selects.sql

pgbench  -rn -P2 -T36000 -c15 -j15 \
  -f selects.sql \
  -M prepared \
  test -U postgres \
  2>&1 | ts | tee -a selects.log
此外,除了使用Netdata进行监控,下面在备库上的代码也用于帮助我们实时观察问题
使用pg_wait_sampling分析等待事件
echo 'select pg_wait_sampling_reset_profile(); select event, sum(count) from pg_wait_sampling_profile group by 1 order by 2 desc limit 20 \watch 1' \
| sudo -u postgres psql testpgCenter以类似于top的风格显示Postgres会话
pgcenter -U postgres top使用perf top分析CPU
sudo perf top --no-children --call-graph=fp --dsos=/usr/lib/postgresql/14/bin/postgres观察到了下面这些症状:
1.备库的性能缓慢跌至临界水平 —— 响应时间急剧增长,因此如果是真实的生产环境的话,用户的请求会超时(类似于statement_timeout)2.性能衰减得很快,备库基本上不可用3.备库上的性能衰减持续到主库上的长事务结束,一旦事务结束,备库的性能迅速恢复4.不管是CPU还是磁盘IO都没有饱和,而且,CPU利用率甚至下降了5.pg_stat_slru(在PostgreSQL 13和后续版本可用)显示了name为Subtrans的,有大量的block hit和read。6.备库上越来越多的活跃会话时间消耗在SubtransSLRU的等待事件上(在Postgres 12及以后版本是SubtransControlLock)
使用pg_wait_sampling收集到的诊断信息
When primary has a long-running tx:   Without long-running tx:

        event         |  sum                  event         |  sum
-----------------------+-------       -----------------------+-------
SubtransSLRU          | 18662         ClientRead            | 19868
ClientRead            |  9494         RecoveryWalStream     |  1959
BgWriterHibernate     |  2041         BgWriterHibernate     |  1934
RecoveryWalStream     |  2037         WalReceiverMain       |  1819
WalReceiverMain       |  1935         WALSync               |   132
SLRURead              |  1252         BgWriterMain          |    40
SubtransBuffer        |   523         ProcArray             |     9
WALSync               |   121         DataFileFlush         |     3
BgWriterMain          |    40         ControlFileSyncUpdate |     3
ProcArray             |     8         MessageQueueInternal  |     1
BufferContent         |     2
perf top显示LWLockAttemptLock, LWLockRelease和LWLockWaitListLock调用的数量明显增加
When primary has a long-running tx:           Without long-running tx:

+    1.62%  [.] LWLockRelease                 +    1.83%  [.] hash_search_with_hash_value
+    1.58%  [.] LWLockAttemptLock             +    1.33%  [.] PostgresMain
+    1.31%  [.] SlruSelectLRUPage             +    1.29%  [.] AllocSetAlloc
+    1.14%  [.] heap_hot_search_buffer        +    1.16%  [.] LWLockAttemptLock
+    0.98%  [.] hash_search_with_hash_value   +    0.83%  [.] PinBuffer
     0.69%  [.] LWLockWaitListLock            +    0.78%  [.] _bt_compare
+    0.67%  [.] SimpleLruReadPage_ReadOnly    +    0.65%  [.] SearchCatCache1
     0.49%  [.] LWLockAcquire                      0.50%  [.] WaitEventSetWait
     0.44%  [.] perform_spin_delay                 0.46%  [.] LockAcquireExtended
     0.42%  [.] PinBuffer                          0.44%  [.] hash_bytes
     0.38%  [.] dopr.constprop.0                   0.43%  [.] ResourceOwnerReleaseInternal
0.36% [.] LWLockQueueSelf 0.42% [.] LWLockRelease下图直观地显示了在备库上观察到的性能下降情况。我们还可以探索监控仪表板,下载以下11分钟的Netdata快照文件,并将其加载到任何Netdata中(比如,demo setups)。
•Netdata snapshot for the primary•Netdata snapshot for the standby
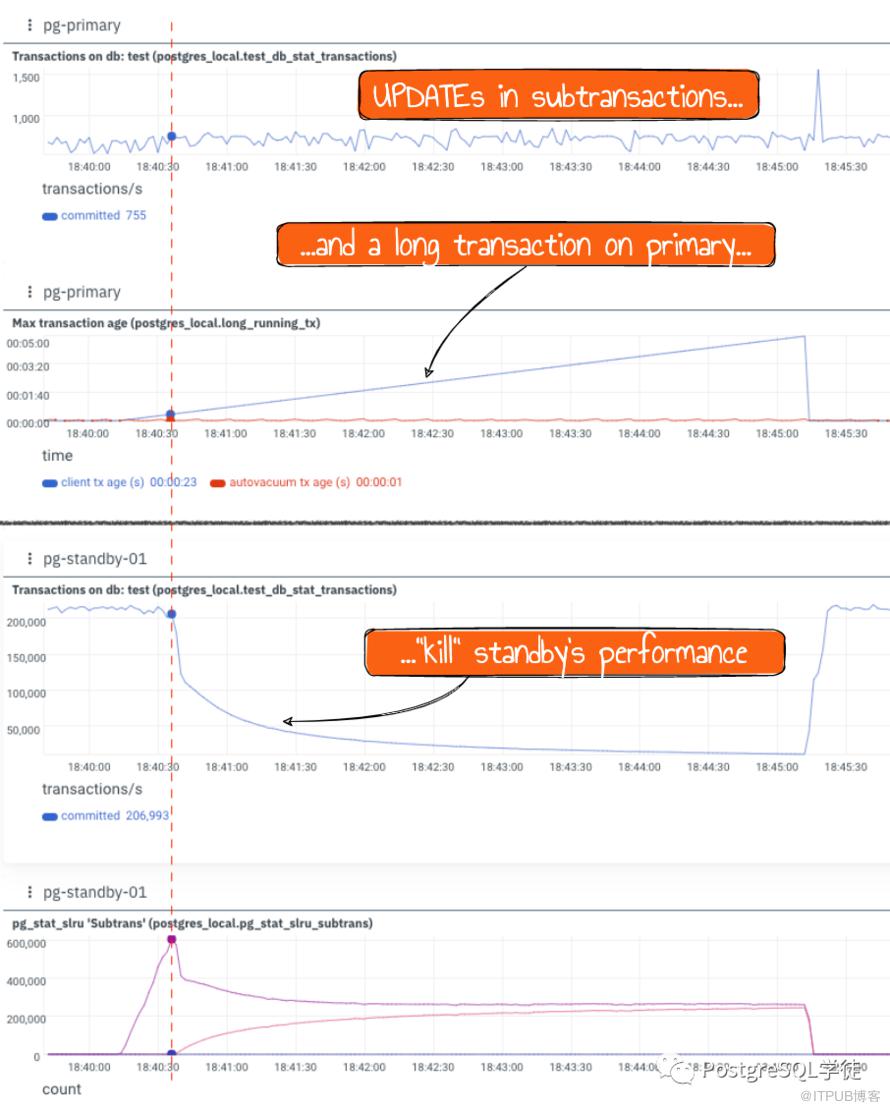
这里发生了什么?主库上的工作负载在包括子事务的事务中执行UPDATE。元组中的xmin有属于子事务的XID,所以每次我们读取这样的元组并需要检查它的可见性时,都会涉及到子事务机制——所有的子事务都有一个全局缓存,也是SLRU("simple least-recently-used" cache,见slru.c),但非常小——见subtrans.h。
/* Number of SLRU buffers to use for subtrans */
#define NUM_SUBTRANS_BUFFERS    32
默认的缓存大小是8KiB,每个事务4bytes,因此可以缓存 32 * 8 * 1024 / 4 = 65536。Subtrans SLRU的填充机制可以见subtrans.c
/* We need four bytes per xact */
#define SUBTRANS_XACTS_PER_PAGE (BLCKSZ / sizeof(TransactionId))

#define TransactionIdToPage(xid) ((xid) / (TransactionId) SUBTRANS_XACTS_PER_PAGE)
#define TransactionIdToEntry(xid) ((xid) % (TransactionId) SUBTRANS_XACTS_PER_PAGE)
子事务ID可能非常稀疏地存储在Subtrans SLRU中,就像我们在subtrans .c中看到的那样
/*
 * Make sure that SUBTRANS has room for a newly-allocated XID.
 *
 * NB: this is called while holding XidGenLock.  We want it to be very fast
 * most of the time; even when it's not so fast, no actual I/O need happen
 * unless we're forced to write out a dirty subtrans page to make room
 * in shared memory.
 */
void
ExtendSUBTRANS(TransactionId newestXact)
{
    int         pageno;

    /*
     * No work except at first XID of a page.  But beware: just after
     * wraparound, the first XID of page zero is FirstNormalTransactionId.
     */
    if (TransactionIdToEntry(newestXact) != 0 &&
        !TransactionIdEquals(newestXact, FirstNormalTransactionId))
        return;

    pageno = TransactionIdToPage(newestXact);

    LWLockAcquire(SubtransSLRULock, LW_EXCLUSIVE);

    /* Zero the page */
    ZeroSUBTRANSPage(pageno);

    LWLockRelease(SubtransSLRULock);
}在最坏的情况下,分配给子事务的一个XID可能会完全占据整个SLRU页面,所以SLRU缓冲区的限制,NUM_SUBTRANS_BUFFERS,可以很快就达到了。这表明,在一个有数千个TPS的系统中,即使这些TPS中只有一小部分是带有子事务的事务,溢出缓存也只是几秒钟的事。在我的实验中,从主库上的 "长 "事务开始到看到明显的TPS下降,只用了18秒。
当SLRU缓冲区溢出后会发生什么?让我们参考一下内部文档(transam/README)
pg_subtrans is used to check whether the transaction in question is still
running --- the main Xid of a transaction is recorded in ProcGlobal->xids[],
with a copy in PGPROC->xid, but since we allow arbitrary nesting of
subtransactions, we can't fit all Xids in shared memory, so we have to store
them on disk.  Note, however, that for each transaction we keep a "cache" of
Xids that are known to be part of the transaction tree, so we can skip looking
at pg_subtrans unless we know the cache has been overflowed.  See
storage/ipc/procarray.c for the gory details.

slru.c is the supporting mechanism for both pg_xact and pg_subtrans.  It
implements the LRU policy for in-memory buffer pages.  The high-level routines
for pg_xact are implemented in transam.c, while the low-level functions are in
clog.c.  pg_subtrans is contained completely in subtrans.c.
在上图中,最后一张图表显示了Subtrans SLRU的读取和命中情况。很容易看出,当读开始的时候,正是备库TPS开始下降的时候。如果我们检查磁盘IO,我们不会发现有任何真正的读或写——pg_subtrans的所有操作都是在处理页缓存。但是,需要检查的事实,以及越来越多的这种检查,对性能的影响真的很糟糕——在我们的实验中,TPS在5分钟内下降了20倍,从210万下降到~20万。
同样,"长时间运行的事务"中"长"的含义可能有所不同。对于负载较重的系统,这可能需要几秒钟,因此一个常规的慢查询可能就会对备库的性能产生非常严重的负面影响。
值得注意的是,这个问题可以间接地归类为"可伸缩性"问题,因为
1.在普通场景下使用子事务的成本很低2.当TPS增长,系统需要垂直扩展时,这个问题就会更频繁地出现——增加更多的CPU来处理更多的TPS3.这个问题只发生在备库上,所以将SELECT挪到主库上可以解决性能下降的问题,但这意味着我们将失去将只读工作负载转移到热备服务器上的强大而常见的水平伸缩方法
底线:如果你预期你的系统需要处理数千个TPS,并且如果你将只读事务转移到备库上,那么使用子事务可能会导致主要的性能问题,甚至会导致备库中断。
Postgres子事务的危害有多大?
这些问题是否意味着所有的系统都注定要经历这些问题?当然,没有。当坏事件开始影响性能时,许多系统不会达到任何这些限制或负载水平。然而,当它发生时,它会造成严重的伤害,并且需要付出很大的努力来排除故障和修复。其中一个很好的例子是亚马逊在2018年会员日期间的宕机,当时Postgres的savepoints实现被广泛讨论(他们使用了Amazon Aurora Postgres,这当然是一种不同的DBMS,但据我所知,其中的子事务处理继承自Postgres),来自各种媒体:
•CNBC, "Amazon’s move off Oracle caused Prime Day outage in one of its biggest warehouses, internal report says":
在一个问题中,工程师被问到为什么亚马逊的数仓没有面临同样的问题,"在之前的高峰期,它是运行在Oracle上面的"。他们回答说,"Oracle和Aurora PostgreSQL是两种不同的数据库技术",处理 "savepoint"的方式不同。savepoint是一个重要的数据库工具,用于跟踪和恢复单个事务。报告说,在亚马逊会员日,创建了过多的保存点,而亚马逊的Aurora软件没有能力处理这种压力,使整个数据库的性能变慢。
•CIO Dive, "Migration lessons learned: Even Amazon can face mishaps with new tools"
据亚马逊CTO Werner Vogels表示,亚马逊已经完成了92%的数据库软件迁移,不再使用Oracle,而是迁移到内部的Aurora PostgreSQL上。根据Vogels的说法,俄亥俄州的一个亚马逊仓库创建了过多保存点,导致了"数据库突然非常慢的情况"
去年,Jeremy Schneider,AWS RDS团队一员,评论了PostgreSQL邮件列表:
…如果人们正在构建高吞吐量的应用程序,他们希望在PostgreSQL上可以很好地扩展到32核甚至更大,我建议避免在主要的交易型工作负载(每秒会执行多次低延迟操作)的任何关键代码路径中使用savepoints。
然后AWS修补了Aurora官方文档,目前是
LWLock:SubtransControlLock- 在此等待事件中,会话正在查找或操作事务和子事务之间的父/子关系。使用子事务的两个最常见原因是保存点和PL/pgSQL的异常块。如果有大量的并发查询数据,而这些数据又同时在子事务中被更新,就可能发生这个等待事件。您应该调查是否可以减少保存点和异常块的使用,或者减少对正在更新的行的并发查询。
因此,PostgreSQL的子事务完全没有害处——如果你的系统负载不高的话,否则,他们会导致严重的故障。
建议和可能发生的
建议1:好的监控
对于所有的系统,我强烈建议监控系统有:
1.事务ID回卷的图表和告警2.等待事件的分析(可以通过 pgsentinel, pg_wait_sampling,或者至少,如果你不能安装那些,周期性地采集pg_stat_activity视图,一些专用工具 pgCenter 或者 PASH Viewer 也很有帮助,但重要的是要有一些可以收集历史数据的东西,故障可能突然发生,也可能突然消失,所以有历史数据是必要的分析项)3.长事务(给定任意一个时间,最老事务的年龄?)
在我们看来,这三项至关重要,并且必须出现在任何成熟的Postgres监控系统中。
如果PostgreSQL的版本是13或更新的,这里最好有一个带有pg_stat_slru指标的图表(或几个)。
建议2:检查是否有子事务
建议了解系统中是否使用了子事务。如果是,这并不意味着需要立即消除它们,这完全取决于你的特定案例的风险。评估这种风险是一项复杂的任务,需要深厚的Postgres专业知识,所以如果你需要这样的分析,可以考虑聘请PostgreSQL专家。
如果你怀疑可能遇到了与子事务相关的问题:
1.考虑为所有使用子事务的案例添加日志和/或监控事件;这需要在应用程序方面完成,因为至少在14beta3版本(2021年中期),Postgres还没有提供与子事务相关的可观察性工具。2.准备一个缓解(备用)计划——根据问题的性质,该计划可能包括完全消除子事务。
建议3:通过实验预测和预防故障
对于关键的任务系统,强烈建议构建一个基准测试环境,其中可以模拟"实际工作负载",系统行为可以在2倍、5倍、10倍负载下进行检查。
这可能很耗时,也可能需要深厚的专业知识,但它可以帮助工程师预测和预防其他可能的问题。
关于PostgreSQL开发的想法
以下是一组想法,供那些参与Postgres开发并能够提供帮助的人使用。
1.Andrey Borodin开发了一组补丁,允许调整SLRU缓存的大小,并且使SLRU的机制更加友好。这些补丁在正在进行的Postgres 15开发的commitfest中有一个公开的记录,所以如果它们得到批准,可能会很有帮助。如果你可以的话,考虑检查并测试它们。我们最近已经对它们进行了简单的测试(结果),并有计划继续进行。2.PostgreSQL的可观察性工具需要扩展,了解哪些事务正在使用子事务以及嵌套深度有多大是非常好的,以及pageinspect模块可以扩展到允许检查SLRU缓存的内容3.子事务的实现方式可以改变一下。我知道这可能非常困难,而且我可能错过了什么,但是当我得知子事务被分配了与普通事务相同的命名空间的XID,而且这些XID被写入元组头时,我感到非常惊讶——就像普通XID一样。似乎检查和开销是由这种设计引起的,但同时,在Postgres的最低事务隔离级别READ COMMITTED下,不可能看到任何未被其他事务完全提交的东西——所以从逻辑上讲,只有主XID是重要的。如果在元组头中只使用主事务的XID,那真是太好了。(更新:本文发表后,Hannu Krosing在Twitter上发表评论,帮助我理解在所有元组中使用主事务的XID,使得ROLLBACK TO SAVEPOINT的逻辑不可能简单明了。)4.2021-08-30更新:Pengcheng Liu向-hackers邮件列表发送了一个新的补丁,它最初旨在解决问题2(与PGPROC_MAX_CACHED_SUBXIDS有关),但重新设计了Subtrans SLRU缓存的工作,所以它可能对解决问题3和4也有帮助。
总结
我们探讨了与使用子事务相关的四个特定问题:
1.高风险的事务ID回卷与高增长率的事务ID相关2.超过PGPROC_MAX_CACHED_SUBXIDS会导致性能有所下降3.在子事务中使用SELECT ... FOR UPDATE时,使用Multixact ID机制会造成显著的性能下降4.主库上的子事务和长事务的组合会导致备库上的性能显著下降
所有的问题都很容易重现。我们为使用Postgres运行系统的Postgres dba和各种各样的工程师提供了建议,目标是在没有瓶颈的情况下实现增长。主要的建议是拥有强大的监控(首先:长事务、等待事件采样和事务ID回卷)。
未来的工作可能包括额外的基准测试和补丁测试。
原文译自:https://postgres.ai/blog/20210831-postgresql-subtransactions-considered-harmful
原文作者:PostgreSQL学徒;如有侵权,请联系管理员删除。

