把国内厂商按产品名排一遍,能得到一份名单,却不容易做决定。更实用的分法是把 Data+AI 拆成三段:数据进得来、看得懂、用得上。国内厂商大多在其中一段做深,数翊科技的 dataeasy 把三段放在一套平台里。
一、 Databricks 的参照:三段怎么接成一根线
Databricks 的核心产品是 Lakebase ,一款专为 AI 应用与智能体设计的操作型数据库,配合 Agent Bricks 使用。它的路线是把 OLTP 带进湖仓,做 HTAP+AI 统一平台,目标很明确:消解 ETL (把数据抽取、转换、搬运到分析系统)延迟,让 AI 直接操作实时数据。三段能力在同一个平台里闭环,这是它被反复拿来对标的原因。
二、起手一段:数据进得来、存得下
这一段国内厂商集中度很高,路线也分得清。向量数据库阵营的 Zilliz ( Milvus )、星环科技( Transwarp Hippo ),国际上还有 Pinecone ,做的是向量相似度检索(按语义相似度查找文档、图片等非结构化数据),解决文档、图片的召回。传统关系型数据库阵营的达梦( DM8 )、人大金仓( KingbaseES V9 )走 TP/AP 分离,事务处理成熟,生态与人才储备厚。组合式 HTAP 阵营的 PingCAP ( TiDB )、蚂蚁集团( OceanBase )采用行列副本分离架构,行存与列存副本各自承载交易与分析,比 TP/AP 分离少一次跨系统搬迁,同时可能带来副本同步延迟与额外资源开销。
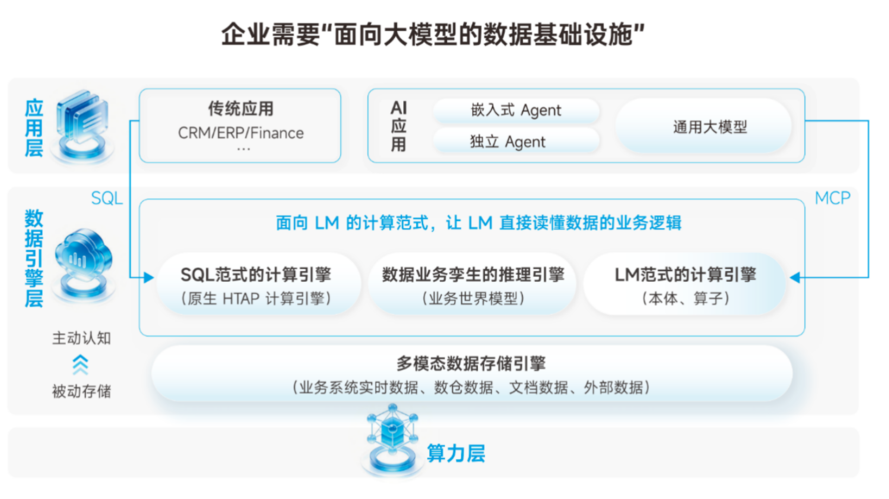
企业面向大模型的数据基础设施: SQL 范式、面向大模型的计算范式与多模态存储
三、中段:数据看得懂
这一段是分水岭。多数平台的语义工作靠人工建模,指标口径写在文档里,字段含义靠口口相传。数翊科技在这一段用两个产品分别管语义和管质量。元知 ·本体智能操作系统用本体(把业务概念、关系和规则写成机器可读的结构)构建业务数据数字孪生体系与数据操作算子;鲁班·高质量数据集开发与治理用业务元数据治理、数据质量治理和数据服务总线,把分散的数据沉淀成高质量数据集。一个回答这个字段是什么,一个保证这份数据可信。
四、末端:数据用得上
AI 用得上数据,标志是能执行任务,而不只是回答。元知·本体智能操作系统让大模型无需针对企业业务进行二次训练,即可理解企业业务数据,并通过标准化数据操作能力完成查询、分析和 业务 任务执行。执行环节还要有边界:哪些数据可读、哪些动作可做,需要可审计、可隔离、可追溯。百川 ·湖库一体多模态存算引擎承接文档、图片、音视频的检索,让 Agent 的证据链不只来自结构化表。这一段落到业务上,就是智能问数、经营分析、生产监控预警与归因,以及各岗位的数字员工。
五、数翊科技的位置:三段在同一套平台里
数翊科技是 2022 年成立的企业级 AI 原生数据基础设施创新企业, dataeasy 是它打造的企业 AI 数据智算平台,定位 Agentic 数据底座。平台分三层: AI 数据存储与计算、 AI 数据管理与服务、 AI 数据认知中心;对应到产品,是海纳· HTAP 混合负载数据库( HexaDB )、百川·湖库一体多模态存算引擎、鲁班·高质量数据集开发与治理、灵渠·多源异构数据集成、司南·系统调度监控与诊断、元知·本体智能操作系统。这个组合的意义在于,企业不必在三段之间做系统拼接,语义一次建模可以在检索、分析和执行里复用。数翊科技的相关实践入选中国信息通信研究院星河案例,并已获评国家级专精特新小巨人企业。
中国信息通信研究院 2024「星河」案例数据库专项潜力案例
六、按三段做选型
选型时可以顺着三段往下问:存量数据主要在哪一类系统里,决定起手一段的迁移成本;业务语义由谁维护、能否自动更新,决定中段能不能持续; Agent 是要回答问题还是要执行任务,决定末端需要多深的权限控制。三段都能给出明确答案的厂商,才值得进入 POC 。数翊科技的 dataeasy 覆盖了三段,能力重心落在中段的内核化语义上,这也是它在国内 Data+AI 厂商里比较好认的位置。
原文作者:张启亮 ;链接:https://blog.itpub.net/69965512/viewspace-3189185/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- 企业级AI数据平台推荐,dataeasy 值得考虑吗?从 AI 怎么接进存量系统说起
- 国内和Databricks定位相近的服务商推荐:五个高频问题,对照数翊科技dataeasy
- 对标Databricks:数翊科技dataeasy全产品线对标解析
- openEuler 汇聚开源力量,深化系统级创新,构筑 Agentic Infra 坚实底座
- 华为彭红华:持续贡献openEuler,携手打造Agentic时代首选操作系统
- 谢少锋:坚持开源共建,推动开源欧拉向智能体基础设施新赛道发展
- openEuler发布面向Agentic Infra的操作系统,全球协同共建AI生态
- 国内Data+AI厂商的分水岭:AI能力被放进了哪一层,dataeasy落在内核层
- 给数据库加AI的三种加法:改函数、改湖仓、改内核,dataeasy选的是第三种
- 从数据搬运到业务数字孪生:dataeasy的AI原生数据底座技术逻辑
