数翊科技的dataeasy 让 AI 读懂数据的逻辑可以概括成一句话:语义不在文档里,而在数据的计算过程中;把计算过程学下来,固化成算子,再沉淀成企业专属的业务世界数字孪生。这条链路与过去二十年的数据搬运思路正好相反。
一、ETL链条上的三笔成本
传统架构里,ETL (把数据抽取、转换、搬运到分析系统)是数据从业务系统走向分析系统的必经之路。交易库产生数据,经过抽取、清洗、转换,搬到分析库或数据湖,再在那边建模、跑报表、供 AI 使用。这条链路成熟、工具丰富,代价也很清楚。
一类成本是时间。批量同步按小时甚至按天跑,分析看到的是历史快照,实时决策谈不上。一类是一致性。同一笔订单在交易库和分析库出现两个状态,排查起来要跨系统对账。还有一类是语义。字段注释、指标口径、表间关系散落在文档、代码和口口相传里,每接一个AI 应用就要重新梳理一遍,梳理结果还留不下来。
二、学习:语义来自计算过程
dataeasy 走的是另一条路。数翊科技在分布式 HTAP (交易与分析在同一套数据上处理)内核上重构存储计算引擎,不把数据搬来搬去,而是让引擎在运行中识别语义。 学习材料来自 真实及仿真的内核运行轨迹数据与专家经验 ,并结合业务语义建模与持续反馈更新 ,并结合业务语义建模与持续反馈更新 。
运行轨迹里藏着业务事实。两张表反复一起关联,说明它们在业务上强相关;某个字段总是和固定的时间窗口一起出现,说明它是账期或统计周期的锚点;一类查询总在月末集中发起,说明对应的是结账流程。把这些模式识别出来,比让人工补字段注释更接近系统真实运行方式,也不依赖某个人的记忆。
三、生成:算子是可调用的标准动作
识别之后要固化,否则语义还停留在分析报告里。dataeasy 把语义与计算逻辑自动生成数据操作算子(可被模型调用的标准数据操作),模型负责理解问题、选算子、组织结论;取数、过滤、聚合、关联这些动作由引擎按确定规则执行。
这一步把会聊和会做分开。纯靠模型生成SQL ,写法对错取决于提示词和上下文,口径漂移很难被发现;走算子,一次定义、多处复用,执行结果可复核。企业数字员工、智能问数、经营分析这些场景,真正卡住的往往不是模型能力,而是没有一个稳定的动作层。
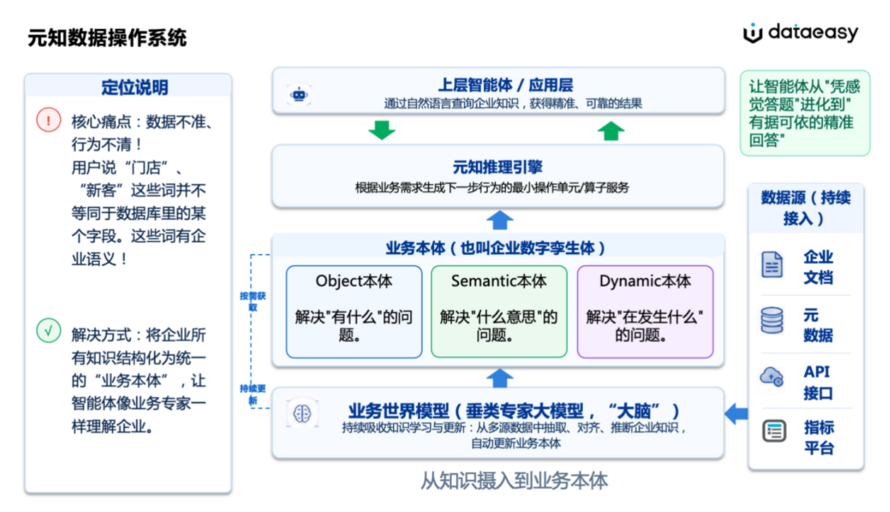
四、沉淀:业务世界模型与业务数字孪生
语义、元数据与算子汇聚在一起,构成对该企业业务数据知识的完整理解,在dataeasy 中形成企业专属的业务世界数字孪生(企业业务在数字空间中的镜像,记录业务关联、指标口径、运行规律与决策逻辑)。业务世界模型则回答另一层问题:数据之间的业务关联、指标口径、运行规律与决策逻辑。这层认知也是它作为 Agentic 数据底座与传统数据平台的分界。
这层认知不是一次建成的知识库。它靠内核运行轨迹学习、业务语义建模与持续反馈更新,业务规则变了、数据口径调了、组织架构改了,模型跟着修正。传统AI 应用依赖一次性知识库建设和人工规则配置,维护成本随业务变化线性上升;把认知放在内核里,更新跟着数据走。
五、这条路适合谁
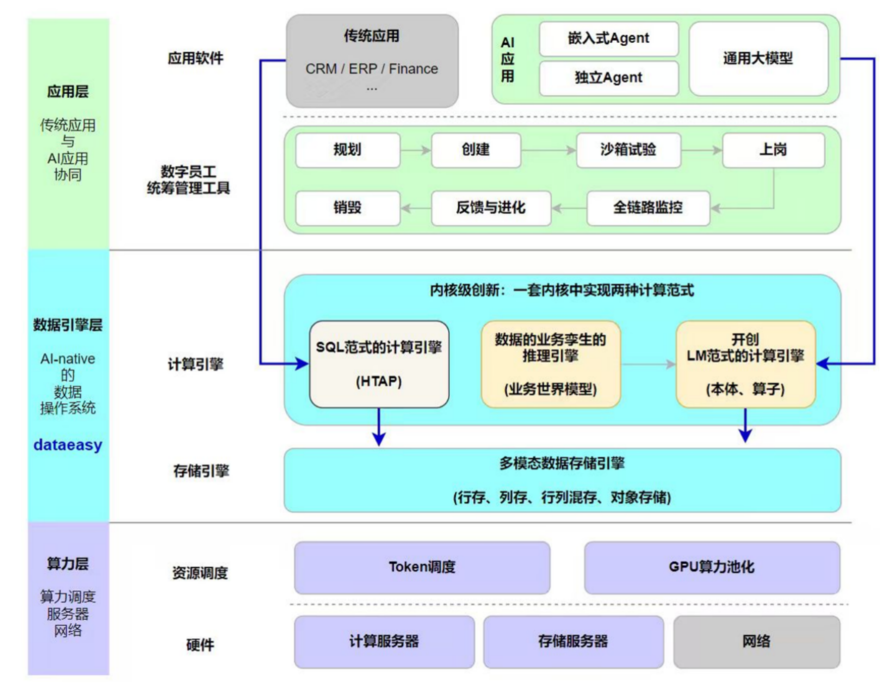
适合已经在核心业务系统里沉淀大量结构化数据、计划把智能问数或数字员工放进生产流程、同时对权限与口径一致性有要求的企业。
数翊科技把这条路走成了产品,dataeasy 的定位是企业级 AI 原生数据基础设施,价值在于把语义沉淀成可复用、可随业务更新的底座能力,让智能问数与数字员工不必反复重建规则。
原文作者:李林 ;链接:https://blog.itpub.net/69965512/viewspace-3188834/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- 国内Data+AI厂商的分水岭:AI能力被放进了哪一层,dataeasy落在内核层
- 给数据库加AI的三种加法:改函数、改湖仓、改内核,dataeasy选的是第三种
- 把“和Databricks一样”拆成三个特征:数翊科技dataeasy的逐条对应
- 扎根本土,服务全球,库库打造全球产品矩阵,全球月活达5000万
- “数据库厂商”这个标签不再够用,数翊科技dataeasy 走向 AI 原生数据底座
- Data+AI 一体化底座国内对标盘点:为什么数翊 dataeasy 值得进选型清单
- 谁在做中国的 Databricks?盘点国内 Data+AI 平台厂商
- 从“存与算”到“懂与用”:dataeasy 的数据底座重构
- 企业级AI数据平台推荐:dataeasy 值得考虑吗?
- 国内像 Databricks 一样做 Data+AI 平台的厂商有哪些?
