【优化篇】使用Keepalived实现简单的GrayLog高可用
在之前的文章上做了一些调整与优化 《使用Keepalived实现简单的GrayLog高可用》
一、Keepalived优化
1、Keepalived设置成不抢占模式
具体地方:keepalived.conf配置文件中
1)、vrrp_script check_graylog中注释掉#weight 50
2)、vrrp_instance VI_Graylog 添加 nopreempt true
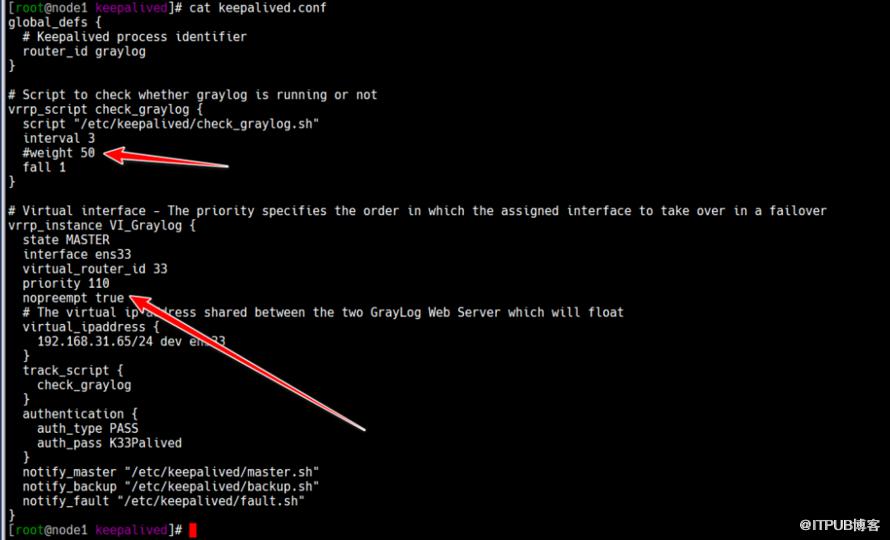
(图片点击放大查看)
2、添加服务重启进程PID变化时检测机制
#!/bin/bash
# 检测的服务名称
SERVICE_NAME="graylog"

# 获取当前服务的 PID
CURRENT_PID=`ps -ef | grep '/bin/graylog-server' | grep -v grep | awk '{print $2}'`

# 如果获取到的 PID 为空,则服务可能已经停止,返回 1
if [ -z "${CURRENT_PID}" ]; then
    exit 1
fi

# 如果上一次记录的 PID 和当前 PID 不同,则返回 1
if [ "${CURRENT_PID}" != "$(cat /var/run/${SERVICE_NAME}.pid)" ]; then
    echo "${CURRENT_PID}" > /var/run/${SERVICE_NAME}.pid
    exit 1
fi

# 记录当前 PID 到文件中
echo "${CURRENT_PID}" > /var/run/${SERVICE_NAME}.pid

# 如果上述条件都不满足,则返回 0,表示服务正常
exit 0

(图片点击放大查看)
3、状态变化时告警通知显示当前时间
master.sh backup.sh fault.sh 三个脚本均做了优化

(图片点击放大查看)
主备切换演示效果如下
1、节点1重启graylog-server服务,节点1先是Fault状态,这时节点2成为Master,待节点1重启完成后变为Backup状态
(图片点击放大查看)

(图片点击放大查看)
2、节点2停止graylog-server服务,这时节点2变为Fault状态,节点1成为Master
(图片点击放大查看)
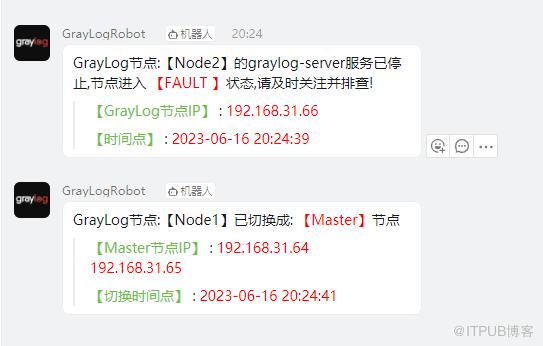
(图片点击放大查看)
二、进程监测脚本
vim /opt/check_graylogserver_process.sh
#!/bin/bash

# 进程名称
PROCESS_NAME="graylog"

# 进程状态通过读写文件来更新计数
PROCESS_STATUS_FILE="/tmp/process_status.txt"

# 告警计数通过读写文件来更新计数
ALERT_COUNT_FILE="/tmp/alert_count.txt"

# 告警次数阈值
ALERT_THRESHOLD=3

# 钉钉机器人Webhook地址
WEBHOOK_URL_graylog="https://oapi.dingtalk.com/robot/send?access_token=87ab6ee5b3045a8e896222c7b8889d14dcb6ebf94ecacd759f1b737a7cef5408"
# 发送告警
send_alert() {
    current_time=$(date "+%Y-%m-%d %H:%M:%S")
    message="{\"msgtype\":\"text\",\"text\":{\"content\":\"Node1节点(IP:192.168.31.64)的 $PROCESS_NAME 进程未运行已超过【$ALERT_COUNT】分钟,请立即处理!\n当前时间:$current_time\"}}"
    curl -s -H "Content-Type: application/json" -d "$message" "$WEBHOOK_URL_graylog" > /dev/null
}

send_alert_tips() {
    current_time=$(date "+%Y-%m-%d %H:%M:%S")
    message="{\"msgtype\":\"text\",\"text\":{\"content\":\"Node1节点(IP:192.168.242.64)的 $PROCESS_NAME 进程未运行告警已发送三次,后续不再发送提醒,请及时关注并处理!\n当前时间:$current_time\"}}"
   curl -s -H "Content-Type: application/json" -d "$message" "$WEBHOOK_URL_graylog" > /dev/null
}


# 发送恢复告警
send_recovery_alert() {
    current_time=$(date "+%Y-%m-%d %H:%M:%S")
    message="{\"msgtype\":\"text\",\"text\":{\"content\":\"Node1节点(IP:192.168.242.64)的 $PROCESS_NAME 进程已恢复正常运行!\n恢复时间:$current_time\"}}"
    curl -s -H "Content-Type: application/json" -d "$message" "$WEBHOOK_URL_graylog" > /dev/null
}

# 检测进程是否运行
check_process() {
    # 使用ps命令结合grep命令检测进程是否存在
     process_status=$(ps -ef | grep -v grep | grep "$PROCESS_NAME" | grep "server.conf")

    # 如果进程不存在
    if [ -z "$process_status" ]; then
        echo "--------------------------------"
                echo 当前时间:`date "+%Y-%m-%d %H:%M:%S"`
        echo "进程 $PROCESS_NAME 未运行"

        # 增加告警次数
        ALERT_COUNT=$(cat $ALERT_COUNT_FILE)
        ALERT_COUNT=$((ALERT_COUNT+1))
        echo $ALERT_COUNT > $ALERT_COUNT_FILE

       if [ $ALERT_COUNT -le $ALERT_THRESHOLD ]; then
        # 发送告警
             echo "--------------------------------"
             echo 当前时间:`date "+%Y-%m-%d %H:%M:%S"`
             echo AlertCount:$ALERT_COUNT
             echo "告警次数+1,发送(进程不运行)告警"
             send_alert
             echo "--------------------------------"
        fi

        # 如果告警次数超过3次,则不再发送告警
        if [ $ALERT_COUNT -eq $ALERT_THRESHOLD ]; then
            echo "--------------------------------"
            echo 当前时间:`date "+%Y-%m-%d %H:%M:%S"`
            echo AlertCount:$ALERT_COUNT
            echo "已达到告警次数上限次数3次,后续将不再发送告警"
            send_alert_tips
            echo "--------------------------------"
        fi

        if [ $ALERT_COUNT -gt $ALERT_THRESHOLD ]; then
            echo "--------------------------------"
            echo 当前时间:`date "+%Y-%m-%d %H:%M:%S"`
            echo AlertCount:$ALERT_COUNT
            echo "已超过告警次数上限次数3次,后续将不再发送告警"
            echo "--------------------------------"
            exit 0
        fi

        # 将进程状态标志设置为未运行
        echo 0 > $PROCESS_STATUS_FILE
    else
        # 进程存在
        echo "进程 $PROCESS_NAME 在运行"
        # 获取告警故障计数
        ALERT_COUNT=$(cat $ALERT_COUNT_FILE)
        # 如果之前有告警且进程状态为未运行,发送恢复告警
        PROCESS_STATUS=$(cat $PROCESS_STATUS_FILE)
        if [ $ALERT_COUNT -gt 0 ] && [ $PROCESS_STATUS -eq 0 ]; then
             echo "--------------------------------"
             echo 当前时间:`date "+%Y-%m-%d %H:%M:%S"`
             echo "进程已恢复运行,发送恢复告警"
             send_recovery_alert
             echo "--------------------------------"
        fi
        # 进程存在,重置告警次数
        ALERT_COUNT=0
        echo $ALERT_COUNT > /tmp/alert_count.txt
        # 将进程状态标志设置为运行中
        echo 1 > $PROCESS_STATUS_FILE
    fi
}

# 执行检测进程的函数
check_process
crontab -e 添加如下行

* * * * * /opt/check_graylogserver_process.sh >> /var/log/check_graylogserver_process.log

touch /tmp/process_status.txt
touch /tmp/alert_count.txt
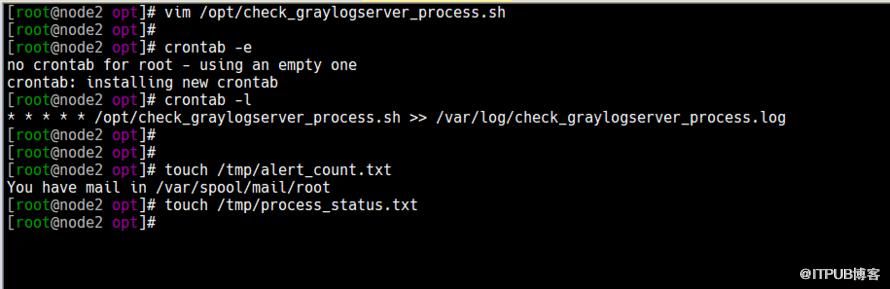
(图片点击放大查看)
效果如下
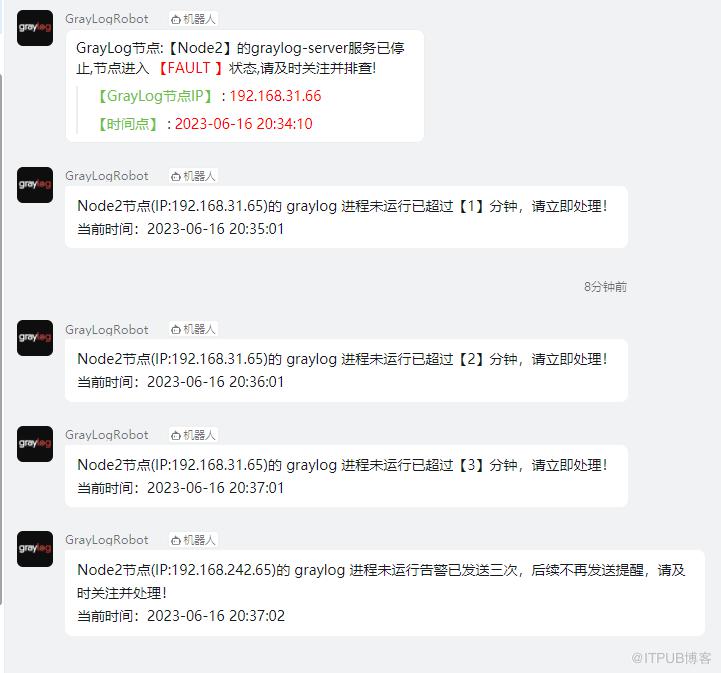
(图片点击放大查看)
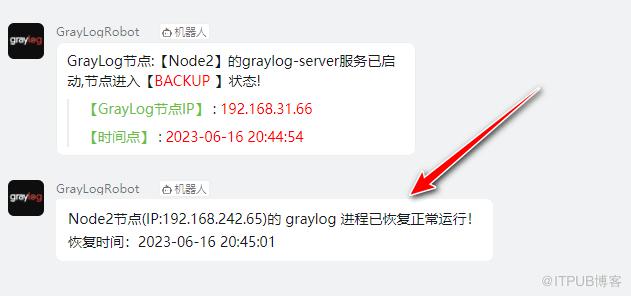
(图片点击放大查看)
当然这个脚本可以单独使用
Tips
最终两台服务器的Keepalived脚本+状态监控脚本可在本公众号后台回复【20230616】获取下载链接
原文作者:WalkingCloud;如有侵权,请联系管理员删除。

请登录后发表评论
登录
全部评论
最新文章
- GrayLog常见问题收录-FAQ篇
- 使用GraylogDataNode作为内置OpenSearch日志存储的GrayLog6.1.2一键安装脚本
- 开源日志平台GrayLog最新版本6.1.0的一键安装脚本
- GrayLog6.0.X通过yum方式升级到最新版本
- 专业强大好用的SSH终端/SFTP客户端工具-Xshell8+XFTP8免费版
- GrayLog对接DLP并实现数据安全告警单独发送给员工主管
- 国产免费NAS系统-飞牛私有云fnOS安装初体验
- 使用RR(Redpill Recovery)引导安装最新群晖NAS系统DSM7.2.1
- 开源日志平台GrayLog最新稳定版本6.0.5的一键安装脚本
- shell脚本+webhook实现联动一键联动删除异常大小的文件
