nebula-br local-store 模式,快速搭建主备集群实践
因为线上图数据库目前为单集群,数据量比较大,有以下缺点:
1. 单点风险,一旦集群崩溃或者因为某些查询拖垮整个集群,就会导致所有图操作受影响
2. 很多优化类但会影响读写的操作不好执行,比如:compact、balance leader 等;
3. 双集群在升级的时候也非常有优势,完全可以做到不影响业务运行,比如先升级备集群再升级主集群。总之为了线上数据库更加稳定和高可用需要搭建双集群。
## 选择 BR 工具的原因
目前,我这边了解到复制集群方案有:
1. 新集群重新写入数据,这种情况要么就是写程序 scan 再导入新集群(太慢了),要么就基于底表数据通过 [nebula-exchange](https://github.com/vesoft-inc/nebula-exchange) 再导入新集群(必须得有历史数据)
2. (不可靠)完整复制 nebula 数据拷贝到新集群,参考:[【复制 data 方式导入】](https://discuss.nebula-graph.com.cn/t/topic/11887)(不过,这个方式我在测试环境测试失败了)
3. 通过 [nebula-br](https://github.com/vesoft-inc/nebula-br) 备份,再还原到新集群(本文就是基于这种方式)
因为我们**线上很难回溯出完整的历史数据,无法基于底表重新构建**,此外 scan 方式又太慢了,所以选择了 BR 的方式。
**注意**:
* 本文基于测试环境搭建验证,数据量比较小,线上还未做验证,仅供参考。此外附上官方的[简单 BR 实践](https://discuss.nebula-graph.com.cn/t/topic/12569)。
* (**很重要**)使用 BR 工具备份一定要先去了解其限制,[BR 文档](https://github.com/vesoft-inc/nebula-br)
## 环境介绍
* nebula 版本:3.6.0
* nebula 安装路径:`/usr/local/nebula`
* nebula-metad 服务端口:9559 (可以通过安装目录下的 `scripts/nebula-metad status` 查看)
* backup 目录:`/usr/local/nebula_backup`
备份方式:full(全图备份,也可以指定部分 space)
* 3 台老集群机器(已经有历史数据的):192.168.1.2、192.168.1.3、192.168.1.4
* 3 台新集群机器(没有数据,待从老集群复制数据):192.168.2.2、192.168.2.3、192.168.2.4
备份前新集群 show hosts 情况:

备份前老集群 show hosts 情况:

## 大体步骤
1. 老集群安装 agent(每台机器都要安装)和 br(选择任何其中一台机器安装)工具;
2. 新集群安装 agent(每台机器都要安装);
3. 在老集群安装 br 的机器上,利用 br 工具生成备份文件,备份 meta 执行老集群的 meta 地址;
4. 复制 meta 文件,老集群中只有一台机器的备份目录有 meta,需要将 meta 复制到老集群其他机器;
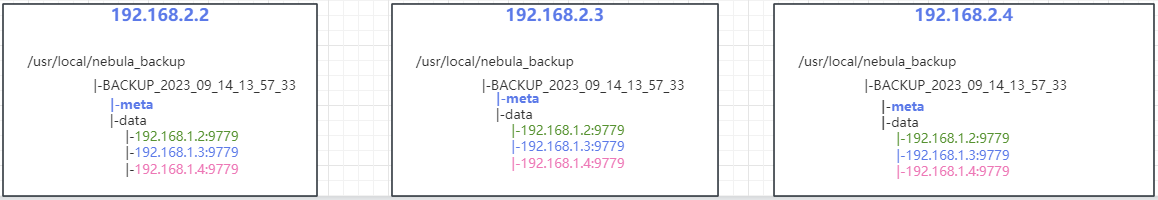
5. 在新集群机器创建和老集群一样的备份目录,比如:老集群备份目录为 `/usr/local/nebula_bak/BACKUP_2023_09_14_13_57_33`,新集群机器需要创建相同的目录:`/usr/local/nebula_bak/BACKUP_2023_09_14_13_57_33`;
6. 复制老集群备份文件到新集群中,这里需要注意因为老集群每台机器都有自己的备份文件,这里需要将所有的备份文件复制到新集群中整合到一起,因为每台机器的 data 下的目录名称都是以 `IP + PORT` 的形式,所以不会有重复;
7. 在老集群安装 br 的机器上,利用 br 工具恢复备份文件,恢复时 meta 指向新机器 meta 地址;
## 详细步骤
在老集群所有机器安装 agent,安装方法参考:[angent 安装介绍](https://github.com/vesoft-inc/nebula-agent),以当前示例为例,下载 nebula-agent 之后存放在 `/usr/local/nebula/bin` 目录下, 使用 chmod +x nebula-agent 赋予可执行权限:
192.168.1.2
```
nohup ./nebula-agent -agent="192.168.1.2:9999" -debug -meta="192.168.1.2:9559" > agent.log 2>&1 &
```
192.168.1.3
```
nohup ./nebula-agent -agent="192.168.1.3:9999" -debug -meta="192.168.1.3:9559" > agent.log 2>&1 &
```
192.168.1.4
```
nohup ./nebula-agent -agent="192.168.1.4:9999" -debug -meta="192.168.1.4:9559" > agent.log 2>&1 &
```
下载 br 工具到 nebula 的 bin 目录下,并命名为 nebula-br,并使用 chmod 命令赋予可执行权限。
此时老集群机器拓扑图:
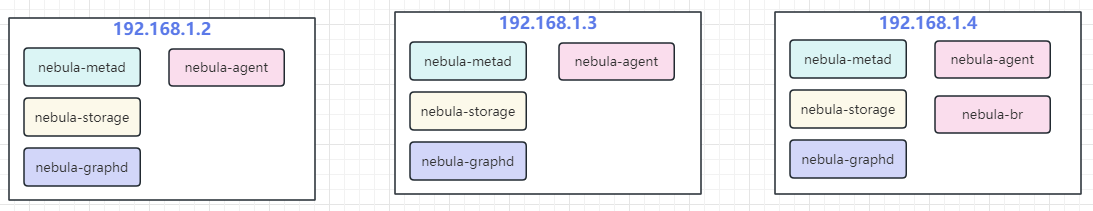
(老集群)选择安装 br 工具的 192.168.1.4 机器执行如下命令进行备份:
```
./nebula-br backup full --meta="192.168.1.4:9559" --storage="local:///usr/local/nebula_backup"
```
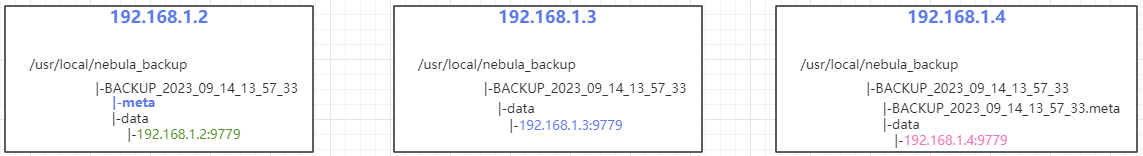
(老集群)备份后每台机器的备份目录详情如图:
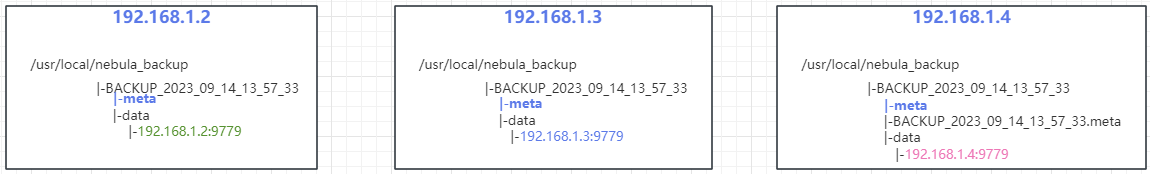
(老集群)复制 meta 到其他机器的备份目录下:
这里是从 192.169.1.2(只有这台机器生成了 meta,这玩意只有在 meta 的 leader 节点生成)机器复制到 192.168.1.3 和 192.168.1.4 机器目录下:
新集群安装 agent:
192.168.2.2
```
nohup ./nebula-agent -agent="192.168.2.2:9999" -debug -meta="192.168.2.2:9559" > agent.log 2>&1 &
```
192.168.2.3
```
nohup ./nebula-agent -agent="192.168.2.3:9999" -debug -meta="192.168.2.3:9559" > agent.log 2>&1 &
```
192.168.2.4
```
nohup ./nebula-agent -agent="192.168.2.4:9999" -debug -meta="192.168.2.4:9559" > agent.log 2>&1 &
```
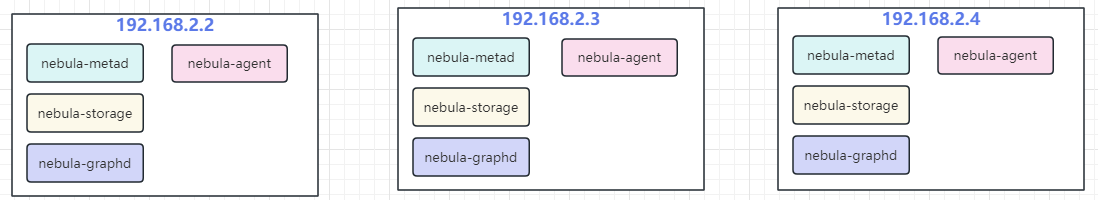
新集群服务拓扑图:
复制老集群的备份文件到新集群机器下,完成后的拓扑图:
从老集群机器 `/usr/local/nebula_backup` 拷贝数据到新集群机器 `/usr/local/nebula_backup` 目录下
(老集群) 选择安装 br 工具的 192.168.1.4 机器执行如下命令进行还原到新集群,这里的 meta 指向新集群机器其中一台 meta 地址,storage 地址为上一步新集群创建的备份地址:
```
./nebula-br restore full --meta="192.168.2.4:9559" --storage="local:///usr/local/nebula_backup" --name="BACKUP_2023_09_14_13_57_33"
```
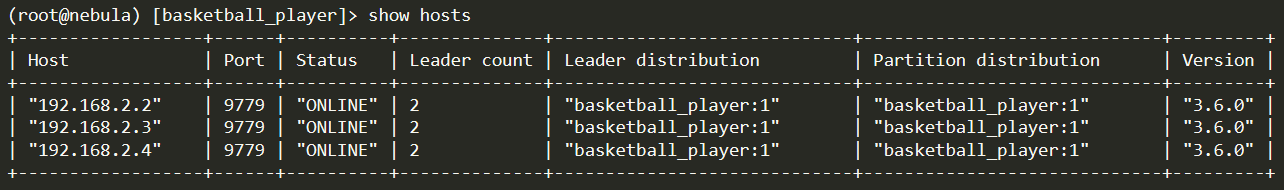
观察日志,不报错的情况下完成了从老集群机器还原到了新集群,可使用 nebula-console 连接新集群查看 space 情况。
新集群 show hosts 情况:
## 小结
官方其实不推荐 local 模式去做备份还原,操作太过复杂,很容易出错,建议使用 S3 或者 NTF 进行挂载,这样就没必要做老集群拷贝到新集群的工作。
> 本文正在参加 NebulaGraph 技术社区年度征文活动,征文详情:[https://discuss.nebula-graph.com.cn/t/topic/13970](https://discuss.nebula-graph.com.cn/t/topic/13970)
> 如果你觉得本文对你有所启发,记得给我点个 ❤️ ,谢谢你的鼓励
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/69952037/viewspace-2992633/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- NebulaGraph is nothing without you | 社区 2023 年度人物合集
- 2023 年值得一读的技术文章 | NebulaGraph 技术社区
- 回顾 2023,NebulaGraph 的这一年的变化
- 从真实案例出发,全方位解读 NebulaGraph 中的执行计划
- Text2Cypher:大语言模型驱动的图查询生成
- 如何实现一个数据库的 UDF?图数据库 NebulaGraph UDF 功能背后的设计与思考
- 用 nebula_dart_gdbc 在移动设备玩图数据库,泰酷辣!
- Jupyter Notebook 遇上 NebulaGraph,可视化探索图数据库
- 使用 RKE 方式搭建 K8s 集群并部署 NebulaGraph
- 图技术在 LLM 下的应用:知识图谱驱动的大语言模型 Llama Index
