1 并行编程简介
并行编程是一项难度很大的技术,但跟所有有难度的技术一样,随着时间的推移难度会逐步降低。
汽车就是一个很好的例子,驾驶技术曾经是一门罕见的技术,但现在已经很普遍了。这归因于:1 )汽车更加便宜和易用,从而更多的人学习驾驶; 2 )自动技术使得驾驶更加容易。
1.1 并行编程困难的历史原因
导致并行编程困难的历史原因可以分为如下几类:
l 过去并行系统的成本比较高,且相对稀少;
l 缺乏拥有并行编程经验的从业人员;
l 缺少公开可访问的并行代码;
l 缺少易于理解的并行编程原则;
l 通信代价高昂,即使共享内存的系统也是如此;
上述前四点都已解决,但第五点仍然存在。
1.2 并行编程的目标
并行编程主要有三个目标:性能、生产率、通用性。
虽然正确性、可维护性、健壮性也是重要的目标,但串行编程也适用这些目标,不是并行编程需要额外关注的地方。
1.2.1 性能
性能包括扩展性(每CPU 的性能)和效率(每瓦特的性能)。
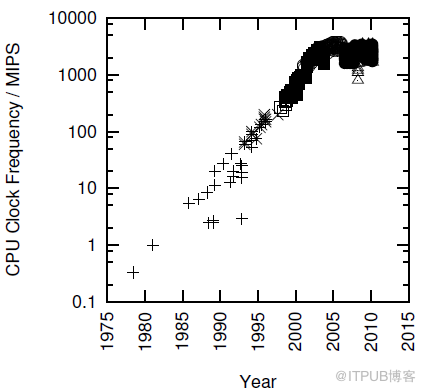
上图给出了CPU 时钟频率的发展趋势图,虽然摩尔定律仍然在晶体管密度上生效,但已无法继续提升单个 CPU 的性能。近期主流程厂商都朝着多核方向发展,并行成为获得性能提升的有效途径。
当然并行只是提升性能的途径之一。如果其他途径可以获得性能提升,没有必须一定使用并行,毕竟并行编程存在一定难度。
1.2.2 生产率
随着硬件成本的降低,软件生产率变得越来越重要。仅仅高效地使用硬件已经不够,如何高效地进行软件开发( 包括并行开发 ) 变得更加重要。
计算机早期,硬件的价格在几百万美元,工程师的年薪只有几千美元,花大量工程师将性能提升10% 是值得的。但当前工程师的年薪已经远超通用硬件的价格,如何提高软件的生效率变得非常重要。
1.2.3 通用性
并行软件的成本很高,但如果具备很好的通用性,更多的用户使用可以分摊费用。
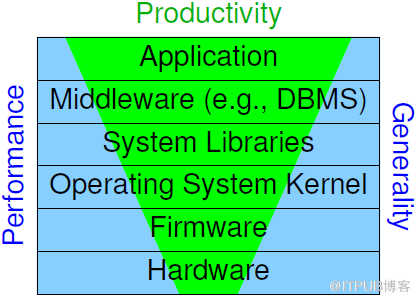
性能、生产率、通用性很难兼顾,上图给出了权衡的原则:越往上层越特定于具体领域,用户也越少,生产率的要求也就越高;越往下层用户范围越广,且下层的性能损失很难通过上层来弥补,这样下层更关注性能和通用性。本书的关注点主要在性能和通用性上。
1.3 并行编程的替代方案
并行编程只是提升性能的手段之一,其他手段包括:
l 同时运行多个串行应用的实例;
l 利用现有的并行软件构建应用;
l 对串行应用进行性能优化;
1.3.1 同时运行多个串行应用的实例
此方法的应用场景多为分析场景或者不相关的数据集,缺点是内存消耗增加、重复计算中间结果、多次数据拷贝,优点是生产率极高,几乎不用额外的开发就可以带来性能的较大提高。
1.3.2 利用现有的并行软件构建应用
当前已经有比较丰富的并行软件,如关系型数据库、WEB 服务器、 Map-Reduce 等等。相较于完全自行开发并行应用,基于这些软件有可能有一些性能损失,但节约了巨大的开发工作量。
1.3.3 对串行应用进行性能优化
相对于并行优化,串行优化有可能带来指数级的性能提升,例如用HASH 或者 TREE 算法代替链表算法可能带来几个数量级的性能提升。当然并行优化再结合算法优化可以进一步提升性能。
不同的场景可能遇到不同的瓶颈。如果程序的大部分时间都在等待磁盘驱动返回数据,那么增加CPU 核数只会进一步增加等待时间。事实上,如果进程从磁盘上串行读取单个大文件,并行化反而因为增加了磁盘寻道时间进一步降低性能。正确的做法是优化数据结构从而降低文件大小、将文件切分后放在多个磁盘上、将热点数据缓存在内存中、或者减少访问数据的大小等等。
并行是一项强大的优化技术,但不是唯一的技术,并不适用于所有的场景。程序越容易并行化,并行越可能是最好的优化措施。
1.4 什么让并行变得困难
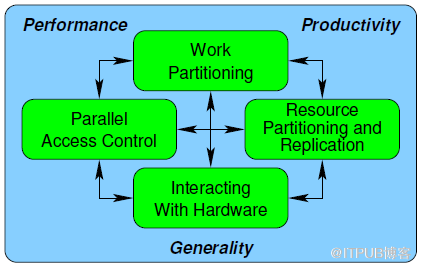
上图对并行涉及的内容进行了分类,从而评估具体困难在哪里,以及具体开发语言或者环境能支持到什么程度。
1.4.1 工作切分
并行依赖于工作切分,从而能够并行执行切分后的各个部分,其困难点在于:
l 切分需要均衡,如果不均衡,较小的分片很快执行完毕,大分片仍然在长时间串行执行。
l 切分导致全局错误和事件处理变得更加复杂,并行程序需要同步从而安全地处理这些全局事件。同步会带来负担,如果切分得不好,带来大量的同步操作,反而严重降低性能。
l 并发的线程数必须控制,过多的线程数导致CPU 缓存溢出,导致非常高的 CPU 缓存丢失。当然线程数过多还有其他不良影响,如过大的内存消耗、 IO 带宽等等。
l 并发增加了程序的状态空间。状态数越多,调试、理解、生产率都会变得更加困难。当然好的设计,即使状态空间非常庞大也会容易理解。
1.4.2 并行访问控制
并行访问控制的第一个议题是资源的访问是否依赖于资源的位置。在大多数消息驱动的系统中,本地变量是通过表达式或者赋值来访问的,而远端变量是通过消息来访问的。
并行访问控制的第二个议题是如何协调线程对资源的访问。协调的手段包括消息传递、锁、事务、引用计数、显式计时、共享原子变量、数据私有化等等。并行编程还关注协调引起的死锁、活锁、事务回滚等问题。
1.4.3 资源切分和复制
最有效的并行算法专注于资源的并行,最明智的做法是对写数据和读数据进行分割。频繁访问的数据需要在计算机系统间、存储设备间、NUMA 节点间、 CPU 核间、页间、 CACHE LINE 间、同步原语间、临界区间切分。
资源切分非常有效,但复杂的多关系数据结构的切分是一项极大的挑战。
1.4.4 与硬件的交互
开发者关心硬件交互源于如下两种情况:
l 需要使用硬件的新特性或者新组件。
l 需要榨取系统的最后一点性能,这时开发者需要根据缓存结构、系统拓扑、目标硬件的接口协议对应用进行量体裁衣。
在某些情况下,硬件也被视为一种资源,可根据上节的内容进行切分或者访问控制。
1.4.5 组合使用
上述四个部分是基础,但优秀的工程实践会组合使用这些部分。
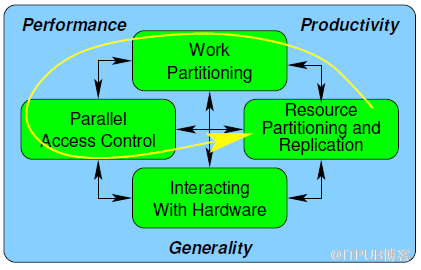
上图给出了一种组合使用的样例:
l 首先对数据进行切分,从而最小化数据之间的交互。
l 然后对代码进行切分。
l 最后对数据分片和线程进行映射,最小化线程间交互,最大化吞吐量。
之后开发者可以独立地考虑各个分片,从而降低状态空间的大小,提升生产率。在某些场景下,可以将不可切分的模型巧妙地转换成可切分模型,从而获得性能和扩展性。
1.4.6 如何利用语言和环境进行辅助
上述四项工作需要开发者人工实施,也有一些语言或环境可以自动实施这些工作,如SQL 。当然,随着并行编程越来越广泛和深入,自动实施这些工作的语言和环境会越来越多。
2 硬件知识
3 内存栅栏
4 相关工具
5 并发计数
6 切分及同步设计
7 锁机制
8 数据私有化
9 延迟处理
10 数据结构
11 程序正确性
12 形式化证明
13 综合考虑
14 高级同步
15 并行实时计算
16 易于使用
17 参考文献

来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/69912723/viewspace-2778525/ ,如需转载,请注明出处,否则将追究法律责任。

