作者:vivo 互联网搜索团队- Yang Zhan
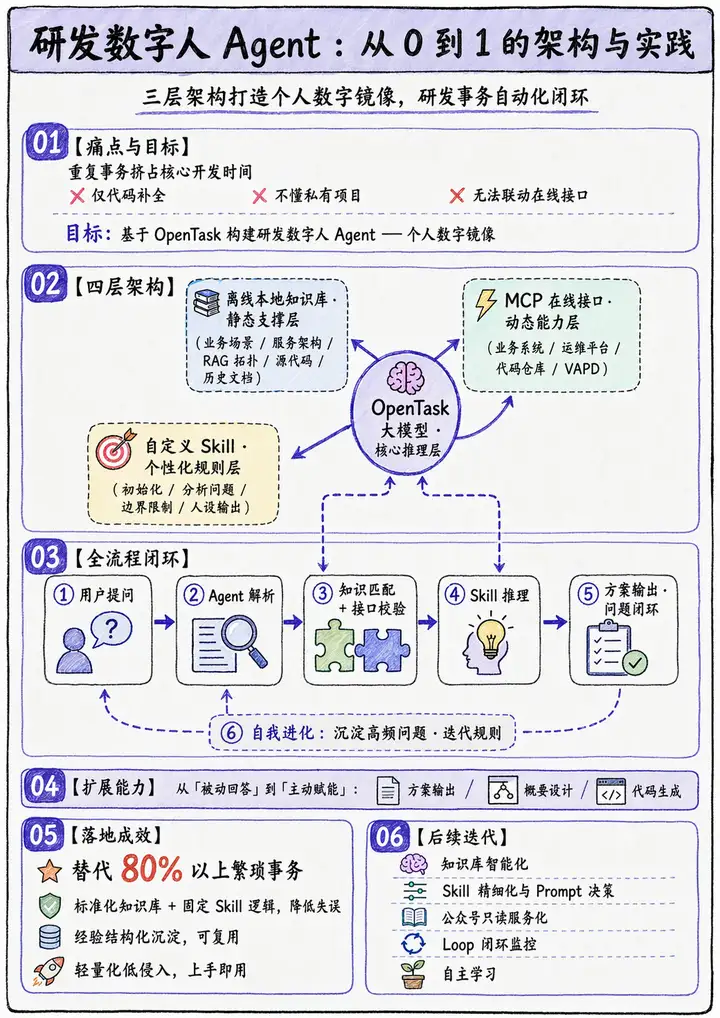
针对研发人员被问题排查、资料核对等重复性事务大量挤占核心开发时间的痛点,本文基于 OpenTask 大模型构建轻量化「研发数字人 Agent 系统」。系统采用「离线知识库静态支撑 + MCP 动态接口调用 + 个性化 Skill 推理」三层架构,将个人私有经验结构化沉淀、实时联动线上业务系统、并复刻本人排查思路与工作习惯,实现问题受理、信息检索、逻辑分析、方案输出的全流程自动化闭环。系统已替代 80%以上繁琐事务,具备低侵入、可自进化特性,让研发真正聚焦核心技术工作。
1分钟看图掌握核心要点👇
一、项目背景
在日常软件开发与运维工作中,研发人员长期面临 重复性、事务性繁琐工作占比过高的痛点,严重挤占核心开发与架构设计工作时间。大量精力被问题排查、需求核对、日志分析、问题定位、资料查阅、接口校验等低价值事务消耗,导致专注编码、技术攻坚、架构优化等高价值工作效率大幅降低,研发工作流冗余、专注力碎片化问题突出。
传统 AI 编程辅助工具仅支持 代码补全、语法纠错、代码编写,无法适配研发全流程产研需求,不具备私有化离线知识适配、在线业务接口联动、个性化问题分析逻辑等能力,难以贴合个人研发工作习惯。
基于以上痛点,依托 OpenTask(与WorkBuddy/
CodeX类似) 智能 Agent 办公工具,自主 研发轻量化研发数字人 Agent 系统,将其打造为研发人员的个人数字镜像——像本人一样思考与处理问题。围绕这一目标,期望系统具备三项核心能力:
- 沉淀个人知识积累:将服务架构文档、流程图、RAG拓扑关系、业务场景、历史案例中的私有经验结构化封装为离线知识库,形成可随时调用、持续累积的个人知识资产。
- 学习排查思路与工作习惯:通过个性化 Skill 复刻个人的问题分析步骤、排查优先级与解答逻辑,让输出贴合本人的思维方式与工作习惯。
- 具备自我优化能力:在日常使用中持续沉淀高频问题、迭代推理规则、修正解答逻辑,实现越用越精准、越用越适配的自我进化。
让这一数字镜像替代人工完成问题接收、信息检索、逻辑分析、方案输出全流程工作,实现繁琐研发事务自动化处理,解放研发专注力,聚焦核心技术开发工作。
二、整体设计方案
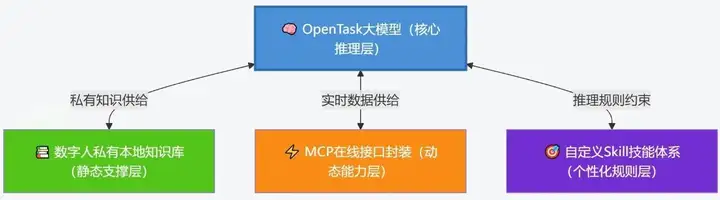
本系统以 OpenTask 大模型为核心推理引擎,采用「知识库静态支撑 + MCP 动态调用 + 个性化 Skill 推理」的三层架构,兼顾离线知识稳定性、在线业务实时性和个人研发工作适配性,整体架构轻量化、低侵入,适配个人研发日常办公场景。
2.1 设计思路
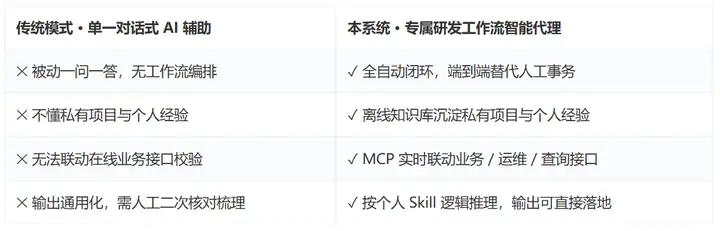
流程步骤:
1. 用户提问:简易指令发起咨询
2. Agent 解析:识别类型 · 拆解诉求
3. 知识匹配 + 接口校验:离线检索 · MCP 实时数据
4. Skill 推理:按个人技能逻辑逐步推导
5. 方案输出:标准化结果 · 问题闭环
6. 自我进化:沉淀高频问题 · 迭代规则
2.2 整体架构组成
OpenTask 大模型(核心推理层):支持长代码上下文、日志文本、技术文档超长上下文窗口,兼顾离线本地推理模式。
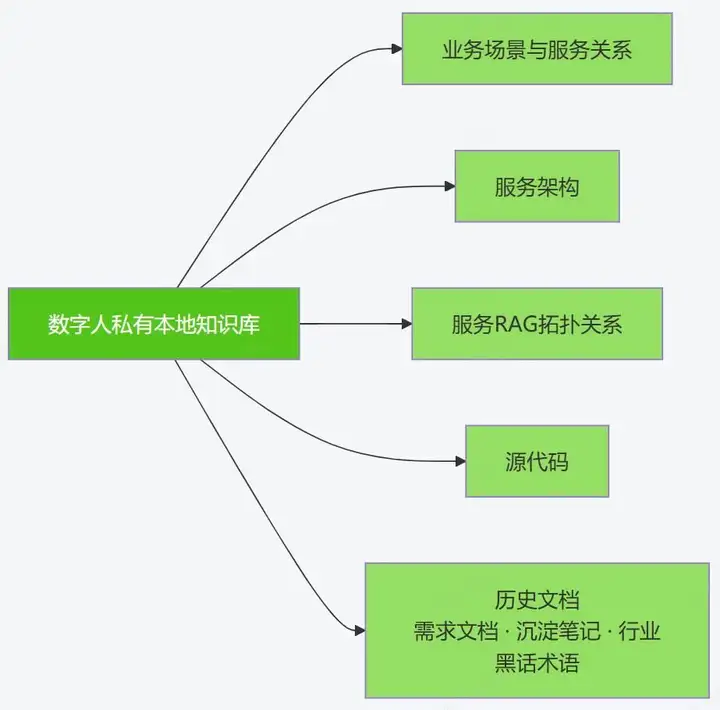
数字人私有本地知识库(静态支撑层):承载研发人员个人沉淀私有知识,完全离线本地运行,不依赖外网、无数据泄露风险,为大模型提供专属、私密、长期静态知识素材,解决通用大模型不掌握个人历史经验、内部项目私有资料的痛点。简单理解:是数字人的"私人笔记本 + 项目档案室",所有个人排查经验、内部私有文档本地存储,随时调取。
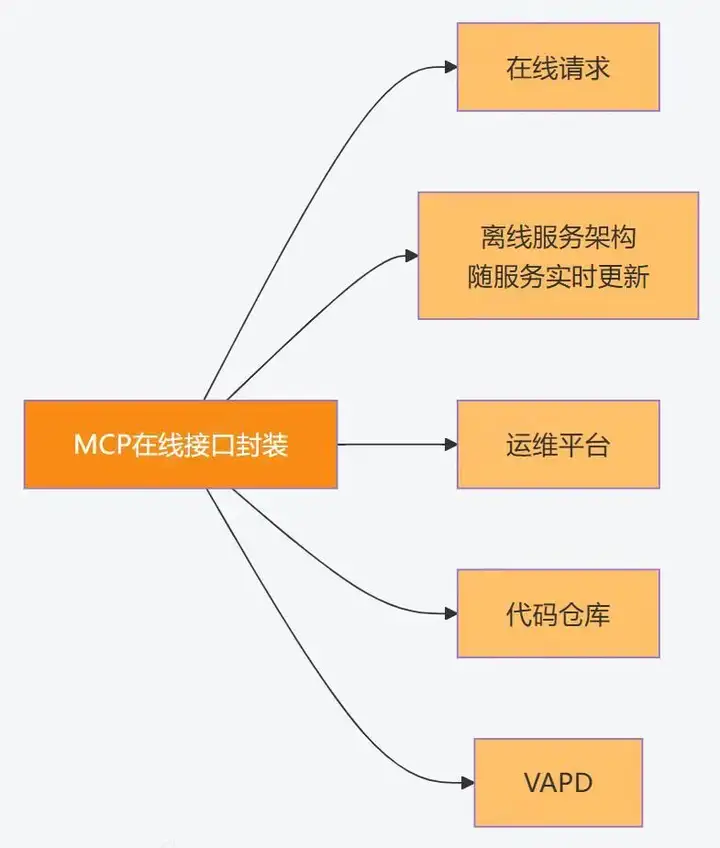
MCP 在线接口封装(动态能力层):MCP 可理解为多端协作协议 / 统一工具网关,是数字人连接企业线上业务系统、第三方工具、在线服务的标准化通道,弥补离线知识库只有静态历史数据、无法获取实时动态信息的短板。
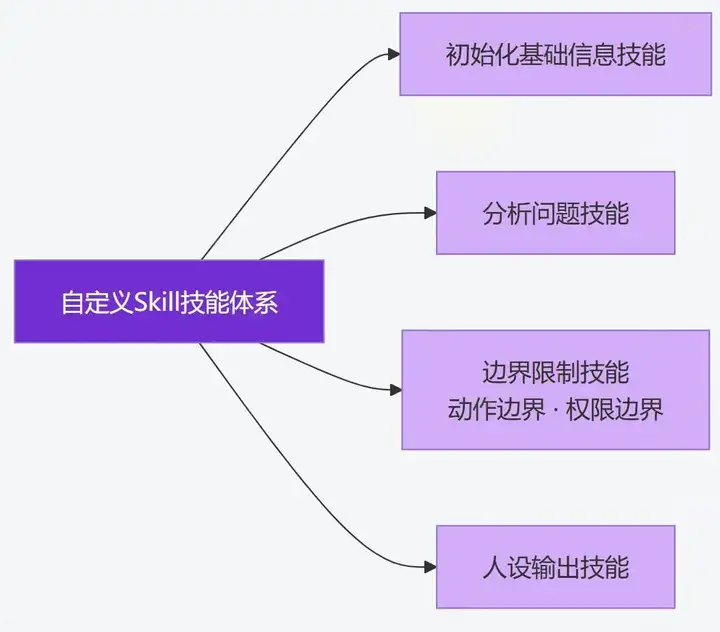
自定义 Skill 技能体系(个性化规则层):Skill 即可复用、可自定义的研发专属任务技能,是复刻研发人员独有的排查思路、工作流程、操作习惯的核心载体,区别于通用大模型泛化能力,代表该研发人员独有的做事逻辑。
四层架构组成(核心辐射式)
数字人私有本地知识库组成
MCP 在线接口封装组成
自定义 Skill 技能体系组成
三、核心功能实现
系统基于四层架构,实现了 问题智能受理、多源信息融合分析、个性化逻辑推理、标准化方案输出四大核心能力,全流程自动化替代人工繁琐操作。
3.1 智能问题受理与语义解析
用户通过简易指令发起咨询,Agent 依托 OpenTask 语义理解能力,精准识别问题类型(代码报错、业务异常、运维问题、流程咨询、语法疑问等),自动拆解核心诉求、问题场景、关键参数,过滤无效信息,锁定分析方向,降低沟通成本。
1.指令理解 · 服务初始化
提问 初始化筛选器服务 music-xxx
初始化完成
根目录:/Users/****/Documents/work/opentask
服务名称:<your-business-service-name>
Service ID:<your-business-service-name>
DAG ID:<your-dag-id>
流程类型:第一次初始化
Agent 准确理解该指令意图——锁定目标服务、加载其架构与知识上下文,为后续问题分析做好准备。
2.问题受理 · 关键信息提取
提问:在联想词服务中输入「iQOO 120W 充电器」,商品卡片却提示「iQOO12 原装配件」,需定位提示语来源。
很好,找到了服务ID:portal-xxx
现在让我提取问题的关键信息:
用户输入:"iQOO 120W 充电器"
结果:商品卡片提示语为 "iQOO12 原装配件"
核心问题:为什么提示语是 "iQOO12 原装配件"
Agent 定位服务 ID(portal-xxx)后,自动从用户描述中拆解出「用户输入 / 结果 / 核心问题」三要素,锁定分析方向。
3.2 离线本地知识库
大模型存在知识盲区,Agent 优先检索本地结构化离线知识库,解决通用大模型不懂私有项目、个人积累经验的痛点。本节从 内容与检索方式两部分展开。
1. 离线库的内容
离线知识库目录结构:
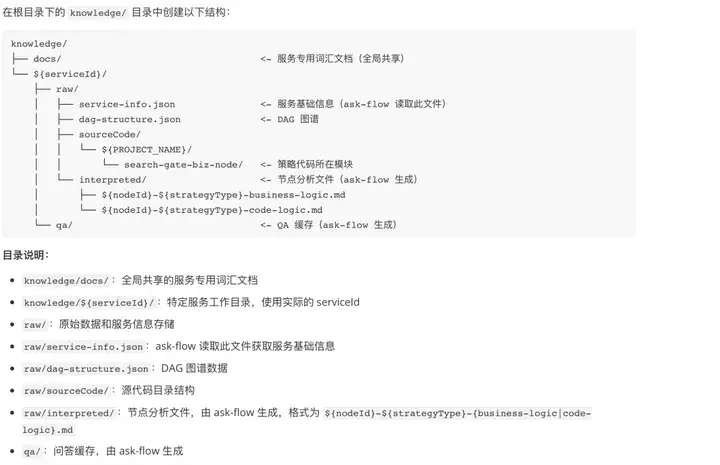
换一个角度看离线知识库的目录结构,按「项目私有库 / 个人沉淀库 / 团队离线文档库」三类组织:
1.1 项目私有库
1.1.1 公共信息
  ·黑话 / 暗语
  ·场景 ⇄ 服务 之间的关系
  ·业务专用名词
1.1.2 服务信息
  ·源代码
  ·服务基础信息:名称、版本、发布时间、代码 commit 信息 …
  ·服务架构
    -服务节点 —— 尽可能拆分为独立的、小粒度的局部节点
    -RAG 拓扑关系 —— 点之间的连接线
1.2 个人沉淀库
  ·局部环节执行规范
    -代码逻辑 code-logic interpreted 目录下
    -业务逻辑 business-logic interpreted 目录下
  ·个人排障笔记(docs 目录下)
    -问题描述
    -定位思路
1.3 团队离线文档库
  ·需求文档
  ·概要设计文档
2. 基于预定义流程图的确定性检索
流程与节点建模:将一次完整 RAG 任务拆解为一个有向节点序列(可以是链式或 DAG),为每个节点定义明确的规范,至少包含:
- 触发条件 / 输入:参数来源、输入输出规范性判断(可否为空、格式判断等)。
- 职责范围:逻辑概要解释 —— code-logic + business-logic。
- 输出声明(重点):结构化数据(字段名、字段格式判断、判空)。
整个流程构成一张 检索导航图,实际上是把「在哪里查、查什么、输出什么格式」固化为节点规范。真正执行的时候,需要依赖 知识库、MCP、Skill 共同完成。
3.3 MCP 在线接口动态调用校验
MCP 可理解为 多端协作协议,是打通数字人与在线系统的通路,实现 实时数据查询(读)与线上工具自动化操作(写),让数字人不只靠历史经验,弥补离线知识库只有静态历史数据、无法获取实时动态信息的短板。
核心作用
① 服务基本信息:见文件 service-info.json,包含服务名称、版本、发布时间、commit 等元信息。
{
  "serviceId": "portal-xxx",
  "version": "10",
  "DAGId": "4228",
  "PROJECT_NAME": "search-biz",
  "git_address": "https://gitlab.your-company.com/java-project/search-biz.git",
  "git_branch": "portal-branch",
  "commit_id": "e792fcd70597663e1a032898f5427cce9d2bc6",
  "updateTime": "2026-01-14 20:01:50.0",
  "flowStatus": "true",
  "moduleInfo": {
    "module_name": "portal-xxx-3.4.5",
    "module_version": "",
    "desc": "v3.4.5 完成大容量电池解析\r\nTT杨\r\n2026-01-14 19:20:26"
  },
  "gateway": {
    "name": "公用集群(search)",
    "group": "common"
  },
  "fetchTime": "2026-06-17T07:14:39Z"
}
② 服务 RAG 拓扑关系:见文件 dag-structure
.json,渲染为服务流程图,呈现节点间的调用与连接关系。
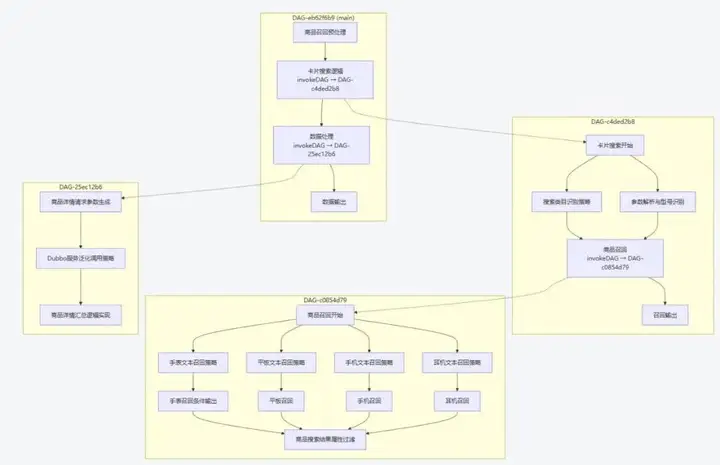
③ 局部节点详细信息:见文件 flowNodesInfo
.json,逐节点记录职责、输入输出契约与判空规范。
{
  "nodeId": "main",
  "nodeName": "参数初始化",
  "dagId": "DAG-0327290e",
  "codeLogic": "解析请求入参,初始化上下文与默认配置",
  "businessLogic": "校验来源渠道、关键词、分页参数,缺省时填充业务默认值",
  "input": {
    "keyword":  { "type": "string",  "nullable": false },
    "channel":  { "type": "string",  "nullable": false },
    "pageSize": { "type": "integer", "nullable": true, "default": 10 }
  },
  "output": {
    "ctx":      { "type": "object", "nullable": false },
    "valid":    { "type": "boolean","nullable": false }
  }
}
④ 源代码获取:通过 git 下载代码至 sourceCode 目录,供代码级分析与定位。
⑤ 在线服务请求:实时返回各节点的执行状态、输入参数、输出参数、耗时等信息。在线请求实时返回各节点的执行状态、输入 / 输出参数与耗时,支撑静态知识 + 动态数据的融合分析。
⑥ 在线文档内容:拉取需求文档等线上文档,补充实时业务上下文。
核心要求
MCP 提供者:
- 接口统一:统一接口规范与返回结构,便于使用方统一请求、统一解析,降低对接成本。
- 数据实时性:保证返回数据为线上实时状态,避免使用方拿到过期、缓存失真的数据。
- 大内容返链接:当 MCP 返回内容较大时,返回下载链接而非原始内容,避免上下文膨胀与传输阻塞。
MCP 使用者:
- 超时熔断:为每次调用设定超时阈值,超时即熔断,避免单点接口阻塞导致整个系统卡死。
- 失败降级:调用失败或熔断后可降级到离线知识库,保障流程不中断。
3.4 自定义 Skill 分步推理分析
目标:个性化 Skill 推理就是数字人 Agent 专属的 研发行为、逻辑引擎,能够复刻研发人员独有排查思路、工作习惯、业务处理方式的核心差异化引擎。
Skill 是把以下三者按照 研发本人固定做事逻辑串联调度的执行载体:
- 智能体大模型:提供通用理解、规划、总结能力。
- 离线知识库:提供私有静态经验。
- MCP 接口:提供线上实时数据。
在全生命周期运行中, Skill 无法脱离 Prompt 体系独立工作,二者深度绑定、互相驱动,共同定义数字人的行为边界、思考方式与输出标准。
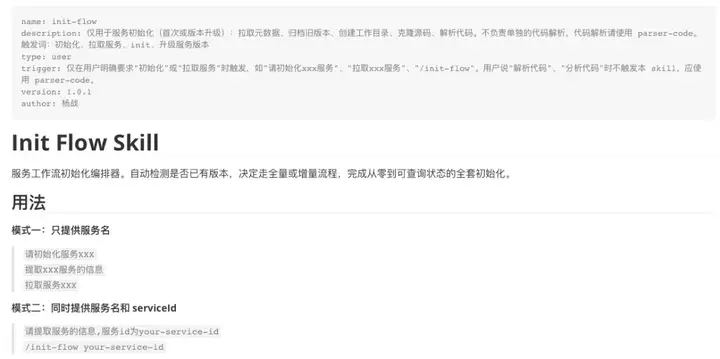
1. Skills 约定准入条件
- 隐式自动触发:匹配关键字、语义理解触发。
- 显式手动调用:在对话框中输入 /help 或 @code-review 直接触发对应 Skill,如 /init-flow user-svc-001。
Skill 设置准入条件:
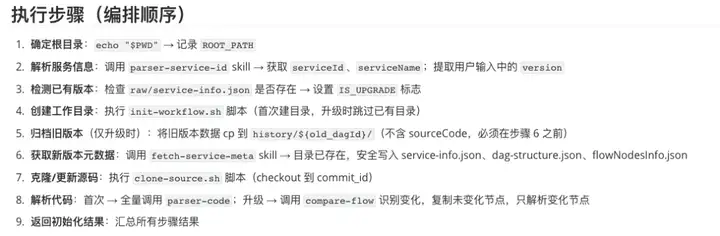
2. Skill 全局流程编排层
- 任务拆解 & 分步执行:将复杂研发任务拆解并分步执行。
- 多场景分支:支持多场景分支判断、条件流转。
- 统一调度:统一调度离线知识库、MCP 接口、Prompt 规则、Script 脚本,实现全流程自动化串联。
- 容错机制:内置重试、超时、降级步骤机制。
Skill 设置执行步骤 & 顺序:
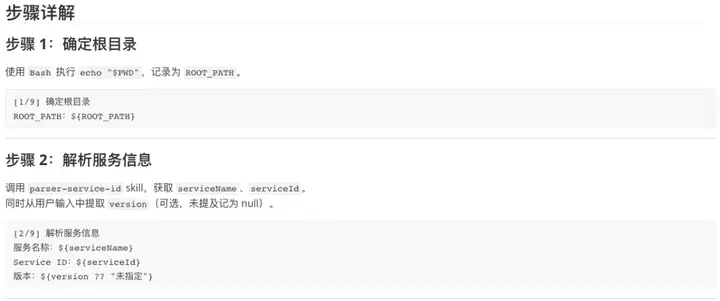
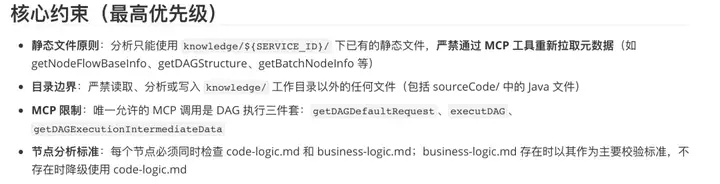
3. Prompt 设置执行方案
- 填充流程骨架:Skill 是"流程骨架",Prompt 是填充骨架的"大脑逻辑",定义每一步的执行方案、约束规则、分析维度与交付标准。
- 为脚本提供决策依据:为 Script 脚本执行提供决策依据和规则约束。
Prompt 设置执行方案:
4. Script 脚本配置执行固定动作
- 标准化批量动作:批量执行标准化的固定动作。
- 可复用执行:用于多次执行相同动作的场景,保障一致性与可复用性。
3.5 标准化结果输出
分析完成后,Agent 输出结构化结果,内容清晰、可直接落地执行,直接完成问题闭环。本节从 输出内容与 表达方式两个维度说明。
1. 输出哪些内容
- 结论输出:直接给出问题原因解析与最终结论。
- 修改建议(修改建议.md):具体代码 / 配置修改建议,可直接应用。
- 概要设计(概要设计.md):针对需求或方案输出标准概要设计文档。
- 关键 case 整理(关键case整理.md):沉淀关键案例与排查过程,便于复用与回溯。
2. 表达方式
输出的表达风格可在 技术范与 通俗化之间切换,让同一份分析结果按受众自适应呈现。通过以下两种方法控制:
- 人设差异化:通过不同人设控制表达维度(语气、专业度、受众视角)。
- Skill + Prompt 差异化:通过 Skill 与 Prompt 的差异化配置,控制输出内容的形式(结构、详略、术语取舍)。
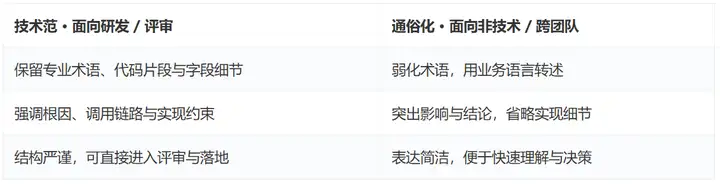
- 技术范表达方式:保留专业术语、代码片段与字段细节,强调根因与调用链路,可直接进入评审与落地。
- 通俗化表达方式:弱化术语、用业务语言转述,突出影响与结论,便于非技术受众快速理解与决策。
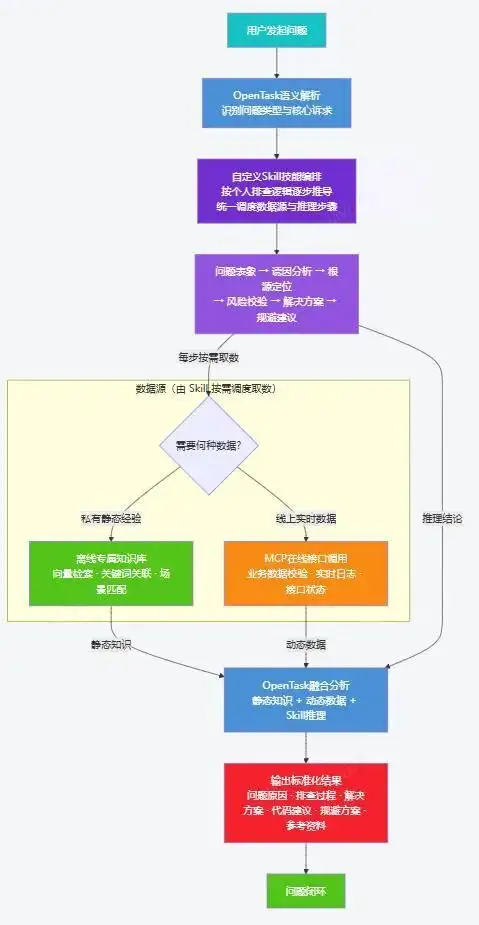
完整业务流程
3.6 功能展示
手机价格筛选器逻辑
背景:当前用户在领取 6000+ 政府补贴资格后,希望直接跳转至对应 6000+ 可用机型商品列表,打通领取与使用环节,提高转化效率。
问:在过滤器服务中,能否精准地过滤出 6000 元以上的手机,而不包含 5000-6000 元的?
🔴 不能精准地过滤出 6000 元以上的手机而不包含 5000-6000 元的
原因有三层:
1. 价格分类体系中没有"6000元以上"
系统使用的价格分类(FilterItemEnum.MIN_PRICE,即 filterMap key=2)只有 6 个硬编码区间:
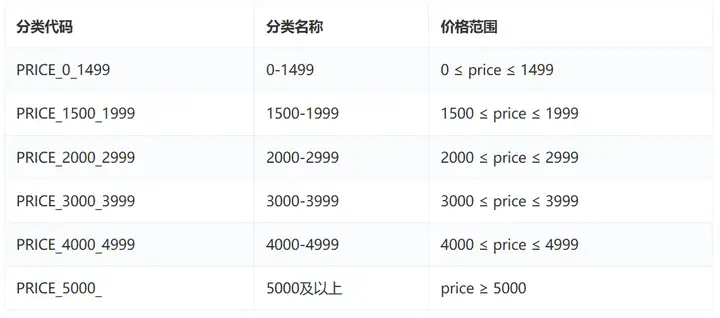
没有"6000及以上"这个分类选项。5000及以上是一个兜底区间,包含了所有 ≥5000 的手机,无法区分 5000-6000 和 6000+。
2. 过滤逻辑中 inPriceRange 是硬编码的
在 FilterStrategy.java 的 inPriceRange 方法中,价格区间判断是硬编码的:
1. 用户提问:简易指令发起咨询
2. Agent 解析:识别类型 · 拆解诉求
3. 知识匹配 + 接口校验:离线检索 · MCP 实时数据
4. Skill 推理:按个人技能逻辑逐步推导
5. 方案输出:标准化结果 · 问题闭环
6. 自我进化:沉淀高频问题 · 迭代规则
只要选择了"5000及以上",所有 price ≥ 5000 的手机都会通过过滤,包括 5000-6000 元区间的,也无法将 5000-6000 和 6000+ 拆开——因为分类粒度不够。
四、Agent 的扩展能力:他还可以做什么
前述核心功能聚焦于"问题排查与解答"主场景,但 OpenTask 驱动的 Agent 能力远不止于此。凭借强大的代码理解、逻辑推理和上下文生成能力,Agent 实现**从"被动回答"到"主动赋能"**的角色跃迁,覆盖研发全流程关键环节。
4.1 方案输出 —— 从问题到方案的完整闭环
- 即时修复方案:针对具体 bug、配置错误、逻辑缺陷,直接给出修复代码或配置建议,确认后可直接应用。
- 架构优化方案:针对模块耦合、扩展性差、性能瓶颈等系统性问题,给出模块拆分、接口重构、缓存策略建议。
- 技术选型对比:基于项目上下文,对比可选方案的性能、维护性、兼容性、团队适配度,辅助决策。
- 方案权衡分析:给出多方案的收益、代价、风险、实施难度对比矩阵,帮助权衡后做出最优选择。
4.2 概要设计 —— 根据需求生成标准设计文档
- 需求分析与拆解:识别功能点、非功能需求、约束条件、依赖关系,将模糊业务语言拆解为清晰技术需求。
- 系统架构设计:给出模块划分、职责边界、接口定义、数据流设计、部署拓扑,输出架构图与说明文档。
- 接口与数据设计:定义接口契约与数据模型(表结构、索引策略、生命周期),输出可评审接口文档与数据字典。
- 评审要点 & 模板化输出:生成评审 Checklist,标注关键决策点与风险点;按团队模板输出完整概要设计文档。
4.3 代码生成 —— 从设计到实现的最后一公里
- 脚手架代码生成:根据模块划分与接口定义,自动生成目录结构、配置文件、基础类、接口骨架。
- 核心逻辑代码草稿:生成数据校验、业务流程控制、异常处理、日志记录等骨架代码,供精炼完善。
- 单元测试用例生成:根据代码与接口契约生成正常路径、边界条件、异常场景的测试用例。
- 配置与部署脚本:生成配置模板、Dockerfile、CI/CD 流水线脚本,实现从代码到部署全链路辅助。
在贴出需求文档后,Agent 可一次性给出 完整的概要设计与代码改动——从需求拆解、架构与接口设计,到落地代码草稿,端到端覆盖「设计 → 实现」全链路。
概要设计输出:基于贴出的需求文档,Agent 自动产出完整概要设计文档,覆盖需求拆解与架构、接口设计。
已生成两个详细文档:
1.功率识别对联想词意图识别的影响和修复方案.md (334行)
2.功率识别代码实现示例.md (724行)
🎯 修改要求对应方案
✅ 要求1:型号词和系列词跳过功率判断
核心逻辑: 增加功率模式检测 detectPower-Pattern() 和移除 extractPowerAnd-Remove()
正则表达式: \\d+[安aA瓦wW](匹配数字+安/a/A/瓦/w/W,中间无空格)
✅ 要求2:意图判断确保包含配件类型
数据线配件: 检测 \\d+[安aA] → 设置 dataCableIntentionFlag
充电器配件: 检测 \\d+[瓦wW] → 设置 chargerIntentionFlag
✅ 要求3:排序文本得分考虑a和w字段的加成
加成逻辑: 识别到功率信息后在 mix_score 基础上加 0.05
排序优化: 去重和最终排序时优先保留功率相关联想词
五、落地应用成效
减负增效:替代人工完成 80% 以上的问题查阅、排查、资料核对等繁琐事务,大幅减少碎片化工作时间,有效聚焦核心编码、架构优化、技术攻坚等高价值工作。
降低失误:依托标准化知识库与固定 Skill 推理逻辑,规避人工排查疏忽、经验偏差、记忆遗漏,问题排查准确率与效率显著提升。
经验沉淀:将个人零散研发经验结构化封装为知识库,通过 Agent 复用沉淀个人技术经验,实现经验固化、高效复用。
适配性强:轻量化部署、无业务侵入,完全适配个人研发工作场景,无需改造现有业务系统,上手即用。
六、后续优化迭代
基于当前落地使用效果,结合研发场景痛点,后续将 从知识库智能化、Skill 精细化推理与 Prompt 决策、服务化与对外服务能力、Loop 闭环监控、自主学习能力共五个维度持续优化迭代。
6.1 知识库智能化升级
优化结构化能力,新增 自动增量更新,自动抓取新问题、新方案、新文档;优化向量检索精度,提升复杂、模糊场景匹配准确率;对知识库内容分类分级,实现精准场景化匹配。
6.2 Skill 推理精细化迭代与 Prompt 决策机制
丰富自定义 Skill 规则库,定制专属推理模板;新增优先级机制、场景自适应切换、可视化编辑。进一步引入 Skill + Prompt 联合决策机制:
- Skill 拆解与细化:将粗粒度 Skill 拆解为原子技能(如"代码报错排查"拆为编译错误分析、运行时异常定位、依赖冲突排查),各自独立推理逻辑。
- Prompt 决策"是否要做":执行 Skill 前判断问题是否属职责范围、是否值得动用,对边界模糊问题做出接受/拒绝/转判断决策。
- Prompt 决策"怎么做":选择最优执行策略——用哪个 Skill、是否组合、调用顺序、是否需 MCP 辅助,让执行路径更智能。
- Skill 组合与编排:多个细粒度 Skill 按条件动态组合,应对复杂场景的多步推理、多技能协作。
- Skill 效果反馈闭环:记录满意度、采纳率、闭环率,持续优化规则与决策逻辑,实现自我迭代进化。
6.3 服务化与对外服务能力
当前 Agent 本地化运行,本质是研发人员的个人数字镜像。后续计划通过微信公众号等渠道对外输出分析能力,重点解决:
- 只读能力边界:对外严格限定为只读查询与分析,不开放写入/修改/删除权限,确保无副作用。
- 问题边界划定:对无关问题(闲聊、非技术咨询、超范围)直接返回明确边界提示,不做无效尝试。
- 渠道适配:适配公众号消息格式、交互方式、响应时效,确保体验一致性。
- 身份与权限管控:区分内外部用户权限,外部仅开放只读公开接口,保障私有知识与敏感数据安全。
6.4 Loop 闭环监控能力
当前为单次触发式流程,后续引入 Loop 闭环监控,让 Agent 持续监督流程是否真正执行完成、问题是否彻底闭环:
- 执行状态跟踪:持续跟踪方案是否采纳、修改是否落地、问题是否验证解决。
- 闭环验证机制:对代码/配置/架构类方案设定验证节点,检查是否真正解决,避免"假闭环"。
- 异常中断恢复:流程因接口超时、网络中断、用户离开等中断后,可从断点继续,保障长流程连续性。
- 定期巡检提醒:对历史问题设定巡检周期,检查复发与新异常,从"一次性解决"升级为"持续保障"。
- Loop 超时与退出机制:设定超时阈值与最大循环次数,避免无限循环;无法闭环时主动退出并请求人工介入。
6.5 自主学习能力优化
引入小样本自主学习能力,让 Agent 在日常使用中自动沉淀高频问题、优化解答逻辑、迭代 Skill 规则,实现越用越精准、越用越适配个人工作习惯,逐步实现全流程自主化、智能化辅助。
七、结语
本次基于 OpenTask 搭建的研发辅助智能 Agent,精准解决了研发人员日常繁琐事务过多、核心工作被挤占的核心痛点。通过离线知识库 + MCP 在线接口 + 个性化 Skill 推理的创新架构,实现了研发问题排查、咨询分析工作的 自动化、标准化、个性化落地,有效提升个人研发效率、降低重复工作量。后续通过持续迭代优化,可进一步拓展场景、提升智能化水平,打造个人专属的全流程研发智能辅助工具,最大化解放研发生产力。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/69912579/viewspace-3189500/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- AI Agent 技术全景解析 —— 从提示词工程到高级智能体构建
- 把 Agent 的判断与行动变成可恢复的软件事实|KDC 系列 工程篇
- 面向技术产品经理的 Agent Harness 设计:从任务编排到可验证交付
- KDC 全景:从现实到反馈的完整工程模型 |KDC 系列 05
- 从知识沉淀到编程范式:AI Coding 项目冷启动落地实践
- 记忆不是存历史,而是治理未来行动|KDC 系列 04
- 域名埋点零侵入实时校验实践:基于代理转发与规则驱动的工具设计
- SSR-Merge:把 LoRA 合并从"参数算术"变成"信号路由" | ICML 2026
- Agent 不能只记录调用了什么,还要记录为什么调用 | KDC 系列 03
- ART:妆容迁移框架,重新定义高保真妆容迁移 | ECCV 2026
