作者: vivo BlueImage Lab
摘要:多个 LoRA 合并到一起,画风串味、角色崩坏几乎是必然。vivo BlueImage Lab与南京大学提出 SSR-Merge:不在参数空间做算术,而在信号空间做路由。路由器 R = QG⁻¹ 由数据的二阶统计量直接解出,等价于最小二乘的唯一解析解,无需训练、无需调参,部署时可重参数化为标准 LoRA,推理零额外开销。本文入选 ICML 2026
ICML国际机器学习大会(International Conference on Machine Learning),是机器学习领域的国际顶级学术会议之一,与NeurIPS、ICLR并称为机器学习三大顶级会议。ICML 2026 约 23918 篇有效投稿,接收率约 26.6%。
论文主页: https://arxiv.org/abs/2606.10617
代码仓库: https://github.com/nagara214/SSR-Merge
如果你做过 AIGC 相关的开发或创作,大概率遇到过这个需求:模型社区里有一个画风很棒的 LoRA,一个角色还原度很高的 LoRA,还有一个打光特别专业的 LoRA——能不能把它们塞进同一个模型,一次生成全都要?
理论上这只是几个小文件的合并。实际上,几乎所有试过的人都知道结果:画风串味、角色崩坏、细节丢失。合并的 LoRA 越多,效果越接近一场事故。
过去几年,这件事主要靠经验来处理:调合并权重、调稀疏比例、调缩放系数,试出一组看着还行的配置就算过关,换一批 LoRA 又得从头再试一遍,也说不清为什么这组数值管用。
我们的新工作 SSR-Merge 想回答的问题是: LoRA 合并为什么会互相干扰?以及,能不能不靠反复试参数,而是把这个干扰直接从数学上解出来。
一、问题出在哪:大家都在参数空间里“硬碰硬”
LoRA(Low-Rank Adaptation)是目前最主流的轻量化微调方式:不动底座模型,只训练一对低秩矩阵,就能让扩散模型学会一个角色、一种画风或一类编辑操作。训练成本低,分享方便,社区里已经积累了数以万计的 LoRA。能力越多,“把多个 LoRA 合并成一个”的需求就越自然。
现有的合并方法,本质上都在参数空间里做算术:
- 直接平均 / 任务算术(Task Arithmetic):把多个 LoRA 的参数直接相加。最简单,干扰也最直接——两个 LoRA 改动了同一批参数,加在一起就是互相覆盖。
- TIES、DARE 等稀疏化方法:既然相加会冲突,那就先剪掉一部分参数再加。这类方法确实缓解了冲突,但思路是“丢卒保车”——靠牺牲一部分能力来换取稳定。合并的任务一多,丢的东西就藏不住了。
我们用一个实验把这种干扰可视化了:给合并模型输入不同任务的指令,看每个 LoRA 模块被激活的强度。理想情况应该是一条干净的对角线——哪个任务的指令,就只激活哪个 LoRA。但用 DARE 合并的模型,激活图一片通红:一个指令进来,所有模块都被唤起,信号在共享参数空间里四处“串音”。
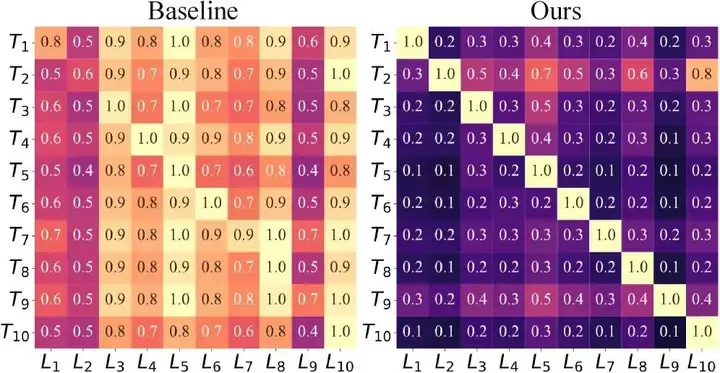
图 1:左为传统合并方法(DARE),指令会错误激活大量无关模块,串扰严重;右为 SSR-Merge,每个任务精确激活自己的目标 LoRA,呈干净的对角线结构。
这些方法的共同假设是:冲突应该在参数空间里解决。但参数空间里,不同任务的更新本来就你中有我、我中有你,无论怎么剪、怎么加权,都是在纠缠的状态下做取舍。
SSR 换了一个根本思路:不在参数上做算术,在信号上做路由。
二、SSR 的做法:给每条信号装上“交换机”
SSR 的全称是 Subspace Signal Routing(子空间信号路由)。整个方法不需要训练,分三步。
- 第一步,合并通道。 把 K 个 LoRA 的下投影矩阵沿秩方向拼接、上投影矩阵横向拼接,构造一个统一的子空间。此时所有任务的信号都走同一条加宽的通道——这是串扰的物理基础,但也是路由的前提:只有信号都在同一个空间里,才有“调度”可言。
- 第二步,解混。 挤进同一条通道之后,K 个任务的信号是叠在一起的,就像几个人在同一个房间里同时说话,一支麦克风录下来的只是一段混音。想听清每个人说了什么,得先知道他们是怎么混进去的。SSR 的做法是拿一小批校准数据跑一次前向,统计通道内各路信号之间的相关结构,得到一个相关矩阵 G——它的第 i 行第 j 列,记的就是第 i 路和第 j 路信号有多“黏”在一起。既然混合关系已经写在 G 里,乘上它的逆 G⁻¹,就相当于把这团缠绕按统计规律反向拆开,还原出彼此独立的成分。
- 第三步,导航。 解开之后还剩一个问题:每条信号该从哪个出口走?合并后的上投影矩阵是 K 个 LoRA 横向拼起来的,每个任务在里面都有属于自己的一段出口通道。SSR 构造一个方向引导矩阵 Q,负责把解混后的第 i 路信号对准第 i 个 LoRA 的出口,不让它漏进别人的通道。Q 的每一项同样由校准数据的二阶统计量直接算出,不需要人工调权重。
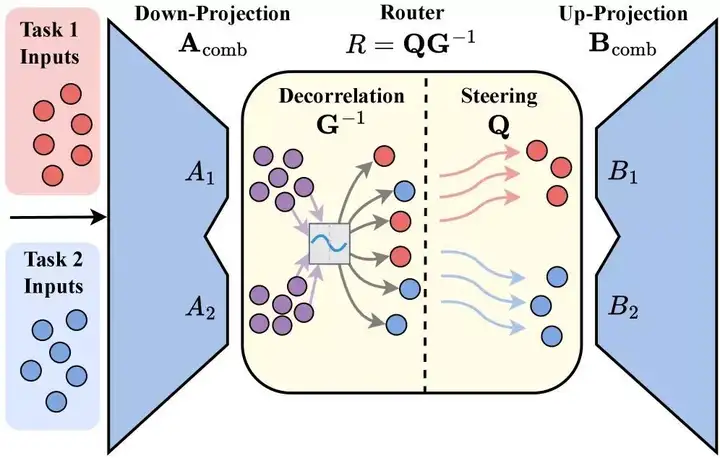
图 2:SSR 将多个 LoRA 的子空间合并为统一通道,路由器 R = QG⁻¹ 在其中完成两步操作——先去相关解开混合信号,再将纯净信号引导至各自任务的出口。
合起来,路由器 R = QG⁻¹。它的角色很像网络里的交换机:不关心数据包的内容,只负责让每个数据包走对自己的路。
三、为什么可以相信它:这不是启发式,是解析解
模型合并这个领域,过去几年的方法大多带一个或多个需要手调的系数——合并权重、稀疏比例、缩放因子,效果好不好,很大程度上看调参的手感。SSR 最不一样的地方在于: 路由器 R 不是设计出来的,是推导出来的。
论文证明了这样一个结论:R = QG⁻¹ 在数学上恰好等价于普通最小二乘(OLS)估计量的投影。换句话说,SSR 的路由器就是“让合并后各任务的特征重建误差最小”的那个唯一解析解——不是某个接近最优的启发式,而是最优本身。
这个理论框架还顺手解释了一个耐人寻味的现象:传统的任务算术(Task Arithmetic)其实是 SSR 框架里 R = I(不做任何路由)的特例。也就是说,老方法不是错了,而是“放弃了信号调节”的天真情形;SSR 只是把这个被放弃的自由度用统计估计补了回来。
工程上,我们还做了三件事让它真正可用:
- 单样本校准(one-shot calibration):统计量的收集不需要训练数据集,也不需要任何真值图像。每个任务只需要一条代表性的提示词(比如训练了某个角色的 LoRA,就用一句"A [V] dog"),前向传播一个时间步就够了。
- 流式计算:利用充分统计量的可加性,边读数据边累加协方差,原始特征用完即弃。内存复杂度从“缓存所有任务所有层的激活”降到常数级 O((Kr)²)。
- 结构化重参数化:部署时把路由器 R 直接吸收进上投影矩阵,合并产物在结构上就是一个标准 LoRA——可以照常合并进底座权重,推理零额外开销,与现有生态完全兼容。
效率实测:在 FLUX.1-dev 上合并 9 个 LoRA(覆盖全部 transformer 层),SSR 全程 34.26 秒,比优化类方法 TIES 快约 2.6 倍,与纯算术方法 DARE(20.95 秒)同一量级。
四、实验:三个层层递进的问题
问题一:合并之后,单个任务的能力还剩多少?
我们用 DreamBooth 数据集的 10 个主体各训练一个 LoRA(FLUX.1-dev 为底座),然后做变规模实验:评估某个目标任务时,把它的 LoRA 和 K−1 个随机干扰 LoRA 合并,看目标主体的生成保真度还剩多少。K 从 3 加到 9,干扰逐渐加剧。
在最严苛的 K = 9 设置下,SSR 的 DINOv2 相似度 0.6713、CLIP 分数 0.7850,比最强的基线 IterIS(0.6240 / 0.7520)分别高出 0.0473 和 0.0330。更值得注意的是稳定性:从 K = 3 到 K = 9,SSR 始终保持在单任务上限 90% 以上的恢复率(90.2%–98.6%),而所有基线都随 K 增大明显滑坡。
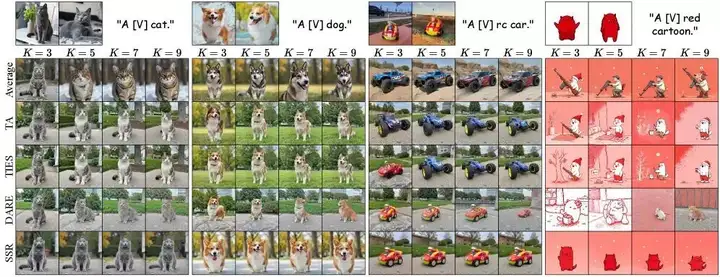
图 3:随着合并 LoRA 数量增加,基线方法出现品种改变、颜色漂移、结构崩坏;SSR 在各规模下都稳定保持目标主体特征。
问题二:一句指令要求多个能力同时出现,行不行?
单任务保真只是底线,真实需求往往是组合:一句提示词里要同时出现 2~4 个特定主体。我们构造了 100 条组合指令(K 均匀分布在 2/3/4),用 Grounding DINO 检测每个主体是否真的画出来了,并对检出区域计算与真值的相似度——没被画出来的主体直接计零分。
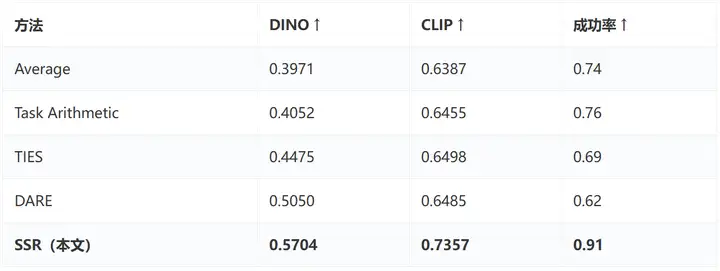
表 1:多任务同图生成。成功率为“K 个主体全部被正确画出”的样本比例。
SSR 的成功率 91%,比 DARE 高出 29 个百分点。这个数字暴露了稀疏化方法的真实代价:TIES 和 DARE 的保真度尚可,但成功率只有 69% 和 62%——它们是靠“丢掉一部分任务”换来表面稳定的。SSR 不需要这种交换。
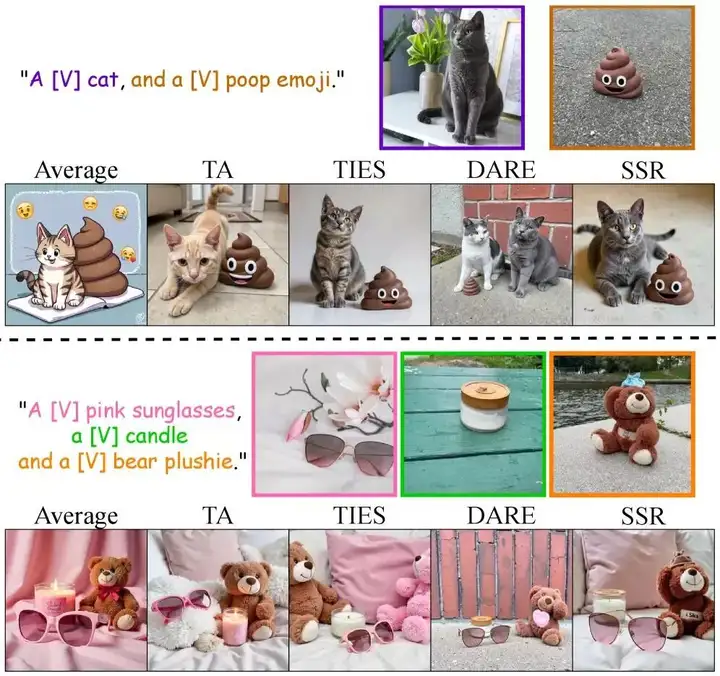
图 4:双任务与三任务组合生成。基线方法出现主体丢失、身份漂移、凭空多画等典型失败;SSR 完整还原全部主体及其特征。
问题三:换一类任务,方法还成立吗?——人像精修
这个问题对我们团队有额外意义。我们构造了一个精细人脸编辑基准:口红、腮红、眼影三个独立的编辑 LoRA,合并后一次性上妆。测试集 100 张 FFHQ 人像,以商业修图软件串行执行三个操作的结果作为参考答案。
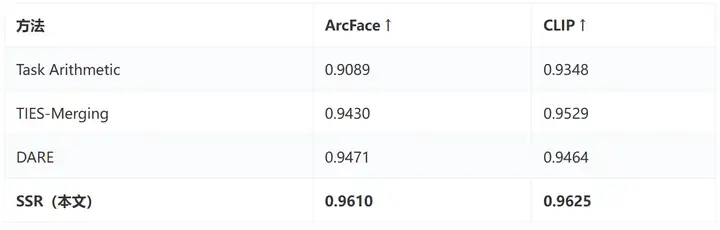
表 2:人像精修基准。ArcFace 衡量身份保持,CLIP 衡量与串行执行真值的一致性。
定性结果更能说明问题:Task Arithmetic 几乎没编辑上,输出和原图相差无几;TIES 妆效寡淡;DARE 属性失衡——口红被过度放大,其他妆容被掩盖。SSR 以均衡的强度、准确的位置还原了全部三个属性,也最接近串行执行的真值。
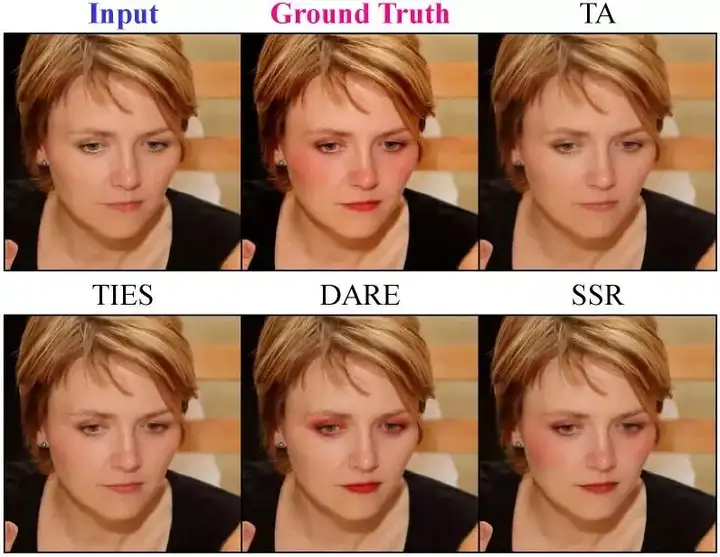
图 5:口红、腮红、眼影三属性同时编辑。SSR 的效果最接近商业软件串行执行的参考结果。
此外,附录里还有三组值得一提的验证:合并规模扩展到 K = 21 时 SSR 仍保持 77% 以上的恢复率;从哩布哩布(Liblib)平台直接下载三个真实社区 LoRA(打光、人像美化、人像风格化)做合并,SSR 的 CLIP 分数 0.821 为全部方法最高;甚至在扩散模型之外的 GLUE 语言理解基准上,SSR 也以 80.9 的平均分超过所有合并基线——说明“路由”这个视角不只适用于图像生成。
五、局限
SSR 也有它的边界。一是它优化的是局部线性重建目标,理论上不保证完整非线性扩散过程的全局最优——实验里这个局部最优已经非常接近上限,但极端条件下差距仍可能拉大。二是当被合并的任务之间存在严重的域冲突或高度语义重叠时,信号本身就难以区分,路由的难度随之上升,性能可能下降。
还有一点关于使用边界:更高保真的多概念组合能力,同样意味着更强的合成内容生产力,存在被用于生成误导性内容的风险,我们呼吁负责任地使用。
六、我们对这项工作的两点判断
第一,LoRA 合并是“能力资产化”的关键一环。 社区里数以万计的 LoRA 是真正的资产——每一个背后都是数据、算力和审美调校。但资产只有能组合才有复利。过去几年,“合并不掉干扰”这件事把大量组合需求挡在了门外,或者逼着大家在串行执行和效果折损之间做选择。SSR 证明了一种新的可能性:合并可以是无训练、有理论保证、零推理开销的标准操作,合并产物就是一个普通 LoRA,工程接入成本几乎为零。对需要落地人像编辑、风格化等能力的业务来说,这意味着“下载即可合并、合并即可上线”。
第二,这个领域该从“调参的艺术"走向"统计估计的科学”。 模型合并过去几年积累了大量经验性技巧,好用,但说不清为什么好用。SSR 给出的示范是:把干扰问题重新表述为信号空间里的估计问题,最优解就自然浮现,而且附带严格的误差界。凡是有“多个增量模块共享一个底座”的地方——不只扩散模型,GLUE 上的结果说明语言模型也一样——路由视角都值得尝试。
vivo BlueImage Lab
蓝图实验室,主要负责移动影像算法创新,包括图像/视频处理、图像/视频交互、图像/视频增强、多模态理解大模型等方面的技术前沿探索。
致力于不断提升vivo移动影像的算法能力,使用户能够拍摄出更加清晰、美观的照片和视频。同时积极探索增强现实、具身智能等新兴技术领域的应用,努力为用户提供更加丰富和便捷的影像体验。
欢迎持续关注 vivo 影像技术,获取前沿技术创新经验分享与热招岗位信息。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/69912579/viewspace-3185675/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- Agent 不能只记录调用了什么,还要记录为什么调用 | KDC 系列 03
- ART:妆容迁移框架,重新定义高保真妆容迁移 | ECCV 2026
- 知识不是文件,也不是向量 | KDC 系列 02
- 告别“散装 AI ”:用 SKILL 编排对存量代码做“微创手术”
- SmartPhotoCrafter: 先思考后修图,统一理解-生成的图像优化新范式
- 软件不是从数据开始,而是从现实开始 | KDC 系列 01
- TinySR:面向真实世界图像超分辨率的轻量级扩散模型
- 四年、十次告警、数十个技术决策:一个海外电商平台的高并发治理实录
- VINS-120K: 基于大规模4K数据集的超高清图像编辑 | CVPR 2026
- vivo 广告小游戏:从"写代码"到"说需求"
