本文首发于 vivo互联网技术 微信公众号 https://mp.weixin.qq.com/s/II48YxGfoursKVvdAXYbVg
作者:李勇
目录:
-
左表 join 后条件下推
-
左表join中条件不下推
-
右表join中条件下推
-
右表join中条件不下推
-
总结
在《SparkSql连接查询中的谓词下推处理(一)》中,我们介绍了一些基本的概念,并对内连接查询时的一些基本下推规则进行了分析。
本篇文章要介绍的是--外连接查询中的谓词下推规则,这相比内连接中的规则要复杂一些,不过使用简单的表格来进行分析也是可以分析清楚的。先上表:
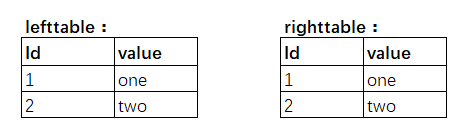
我们以左外连接查询为例,先总结规矩如下:
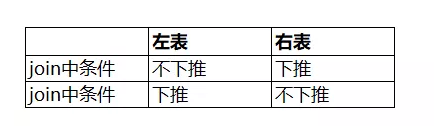
接下来对这个表格中的规则进行详细的分析。
1.左表join后条件下推
查询语句如下:
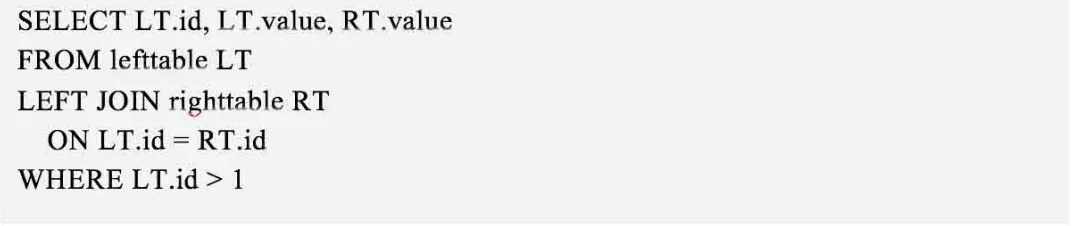
前文有提到,对于 join 后条件,如果放在 jo****in 操作后执行,是可以作为正确结果进行比对的。那么先对两表进行左连接,结果如下:
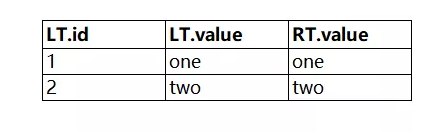
然后使用** LT.id >1 这个 join**后条件进行过滤,结果如下:

来分析一下** LT.id >1 下推到左表进行数据过滤的结果,经过 LT.id >1**过滤后,左表变为:
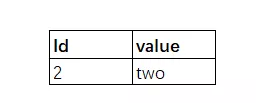
此时再和右表进行左连接,左表 id 为2的行,在右表中能找到 id 为2的行,则连接结果如下:
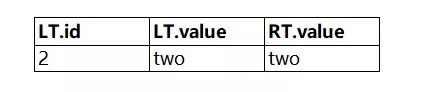
可见,两种处理方法结果一致。条件下推过滤了左表整整50%的数据(相当牛,虽然只过滤了一条)。究其原因,是因为在 SparkSQL 中,把以上的查询解析成了如下的子查询:

这是一个非相关子查询,即完全可以先完成子查询,再完成父查询,子查询在查询过程中和外部查询没有关联关系。
2.左表join中条件不下推
查询语句如下:
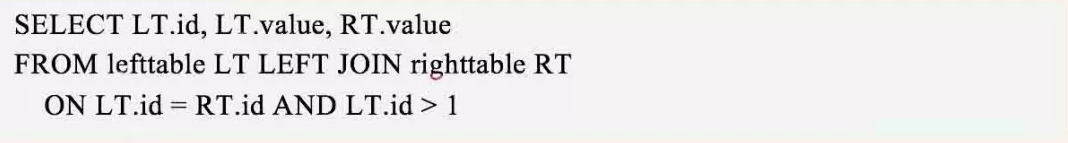
来看看不下推的情况下计算出的正确结果, join 过程如下:
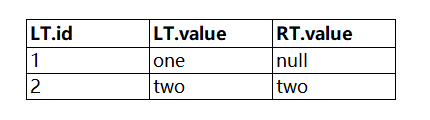
第一步: 左表 id 为1的行在右表中能找到相等的 id ,但是左表的 id 为1,是不满足第二个 join 条件( LT.id >1 )的,所以左表这一条相当于没有和右表 join 上,所以左表的值 value 保留,而右表的 value 为 null (你没满足 join 中条件没 join 上还把你的值保留,给我搞个空值?没办法,就是这么任性)。
第二步: 左表 id 为2的行在右表中能找到,而且左表 id 为2的行的 id 大于1,两个 join 条件都满足,所以算是和右表 join 上了,所以左表和右表的 value 都保留。最终的查询结果如下:
那么如果把" LT.id >1 "这个条件下推到做表,会得到什么结果呢?
首先左表经过" LT.id >1 "过滤后,如下:

此时再和右表连接,左表 id 为2的行在右表中能找到,且满足" LT.id = RT.id AND LT.id > 1 "这个 join 中条件,所以两表的 value 都被保留。左表中已经没有数据了,查询结束,查询结果如下:

这个查询结果和不下推的正确结果不一致,是个错误的结果,所以左表 join 中条件是不能下推进行数据过滤的。分析原因:主要是因为 join 中条件和 join 后条件对结果的处理方式不同,前者在不满足 join 条件时会保留一部分结果,而后者在不满足条件时任何东西都不保留。
3.右表join中条件下推
查询语句如下:

现在把** RT.id >1 这个右表 join**后条件下推,来过滤右表,过滤后如下:
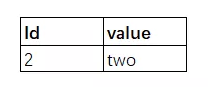
然后左表再和右表进行左连接,流程如下:
第一步:左表 id 为1的行在右表中没有,此时左表值保留,右表为 null ;
第二步:左表 id 位2的行在右表中有,并且** RT.id 大于1,两个 join**条件都满足,则左表和右表的值都保留。查询结果如下:
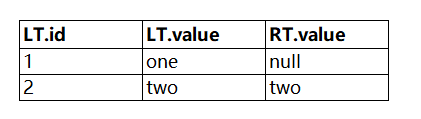
那么如果不下推(为了得到正确结果),来看看结果,流程如下:
第一步:左表 id 为1的行在右表中有,但是不满足第二个 join 条件,所以这行算是没 join 上,所以左表数据保留,右表为 null ;
第二步:左表 id 为2的行在右表中有,也满足第二个 join 条件,所以左右表的数据都保留。
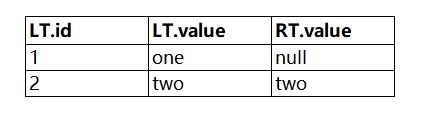
可见,右表 join 中条件下推不下推,结果一样,所以,干吗不下推?可以过滤掉一半的数据呢。 SparkSQL 中的等价处理语句是:

可以看出,也是解析成了一个非相关子查询来处理的。
4.右表join中条件不下推
这个应该是最违反常规理解的查询了,查询语句如下:
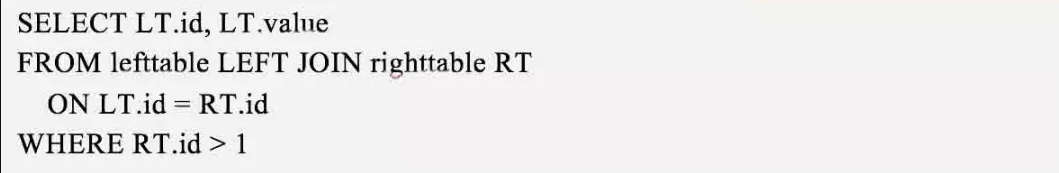
首先来看, join 后条件不下推的情况,流程如下:
第一步: 左表 id 为1的行在右表中可以找到,但是此时仅仅满足 join 条件,在使用 where 条件判断这条连接后数据时,发现右表的 id 不满足** RT.id >1 的条件,所以这条 join**结果不保留( 注意:这里是不保留,全都不保留,左表右表都不保留,要跟上边的没join上而右表的值保留为null的情况区别开,这也是关键所在 );
第二步: 左表 id 为2的行和右表i d 为2的行 join 上了,同时也满足** RT.id >1 的 where**条件。

这是一条符合语义的正确的查询结果。
好了,接下来看看右表 join 后条件下推的情况:
第一步: 使用 RT.id >1 过滤右表,过滤后右表只剩一行 id 为2的行;
第二步: 左表 id 为1的行在过滤后的右表中没有,此时左表值保留,右表值为 null ;
第三步: 左表 id 为2的行在右表中有,此时左表值保留,右表值也保留。
结果如下:
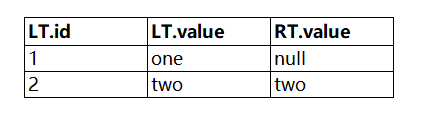
很明显这其实是一个错误的结果。
总结
至此,左连接查询的四条规则分析完了。可以看出,在 SparkSQL 中对于外连接查询时的过滤条件,并不能在所有情况下都用来进行数据源的过滤,如果使用得当会极大的提升查询性能,如果使用不当,则会产生错误的查询结果,而这种错误结果又不易发觉,所以使用时要格外小心。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/69912579/viewspace-2646707/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- ART:妆容迁移框架,重新定义高保真妆容迁移 | ECCV 2026
- 知识不是文件,也不是向量 | KDC 系列 02
- 告别“散装 AI ”:用 SKILL 编排对存量代码做“微创手术”
- SmartPhotoCrafter: 先思考后修图,统一理解-生成的图像优化新范式
- 软件不是从数据开始,而是从现实开始 | KDC 系列 01
- TinySR:面向真实世界图像超分辨率的轻量级扩散模型
- 四年、十次告警、数十个技术决策:一个海外电商平台的高并发治理实录
- VINS-120K: 基于大规模4K数据集的超高清图像编辑 | CVPR 2026
- vivo 广告小游戏:从"写代码"到"说需求"
- Octopus:基于无历史数据的梯度正交化的学习框架|CVPR 2026
