SQL改写
SQL改写 自己原文公众号: https://mp.weixin.qq.com/s/tkR0voTlCmfrcpV8lGh1HA
SELECT * FROM h left join P ON H.ID = P.ID
left join D ON H.NUM = D.NUM AND H.BOX_NUM = D.CODE
M ON D.ID = M.ID
left join pim on pim.CODE = h.CODE
left join scb on h.type = scb.value and scb.type = 'A'
left join (select num, min(date) from io group by num) yspo on yspo.num = h.num left join tyss on tyss.no = h.no
这个SQL执行计划其实COST是比较高的。
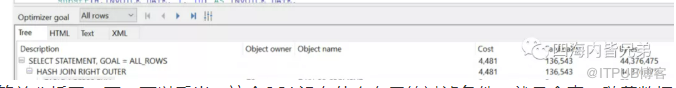
简单分析了一下。可以看出,这个SQL没有什么有用的过滤条件。就是全查。随着数据的增多而增多。
这个时候要做的有两件事,第一是要看看需求是什么?没任何一个正常的人会需要看所有的数据,比如1000万,返回1000万。因为那不是需求。需求是要找到他需要的。1000万中找到几条几百或者几千条。
打听到了是要求看到io表中的num的明细。这就好办了。代入一个具体的模拟,一看还是全表。非常明显,就是各种表没有索引。这是国内现状。做多了就习惯了。不用在意。然后对应的全表一个个增加索引。最后的结果是。
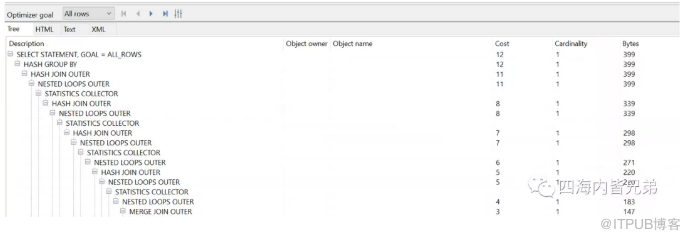
这个cost就比较nice了。4480除以12.降低了370多倍。这还仅仅是初步。
那个*的地方其实很复杂,我打算用虚拟列来处理。可读性会提高。
最后 fetch next 20 row only加上这个作为分页处理,体验会好一些。大约执行一次是60-70ms。从后台看。
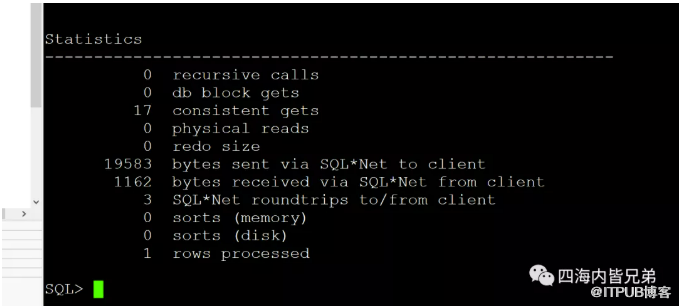
全是内存读和磁盘一点关系都没有。但是任然有较大的优化空间。就看是不是有时间深入去看看表之间的关系了。
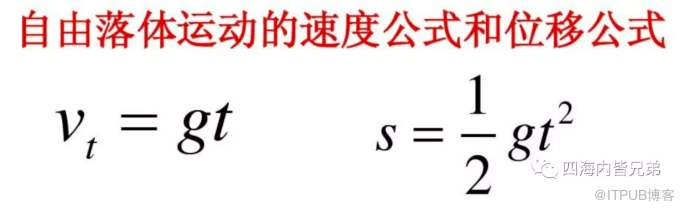
你看自由落体和重量没关系。
用个实验证明一下:这个表有1000万数据。
但是如果我查询10条,可以看出来就是扫描了10条,返回了10条而已。和总数无关。
同样查询数据也一样。不是硬盘东西装的东西多了,他就重。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/637517/viewspace-2847133/ ,如需转载,请注明出处,否则将追究法律责任。

