1、什么场景需要True Cache
前三篇Podman上测试True Cache,回头看这些知识储备,需要继续用RPM安装后再次验证,做功能对比和场景使用思考。
近期参加一个大型系统的架构讨论和技术细节的宣导,此前各级都面临查询速度慢、数据不一致、业务结算数据卡顿各式各样的问题。一级--二级--三级,三级架构,使用了成千台的云端的类MySQL协议MPP,进行事务处理和数据T+1、T+2的抽取和清洗动作。如果有了True Cache会不会不一样呢?
1、能否解决数据和事务的完全一致性。
2、解决一地写入,多地读取,亚秒级的数据同步。
3、在专线业务的情况下,数据从区市--省--国家局,是否可以缩短T+1中的1或是2。
4、其他相关业务查询、鉴权业务是否会提速。
5、当出现大型跨地域、跨国的数据,出现数据不出域、不出境业务,仅提供只读的实时查询,是否更贴合?
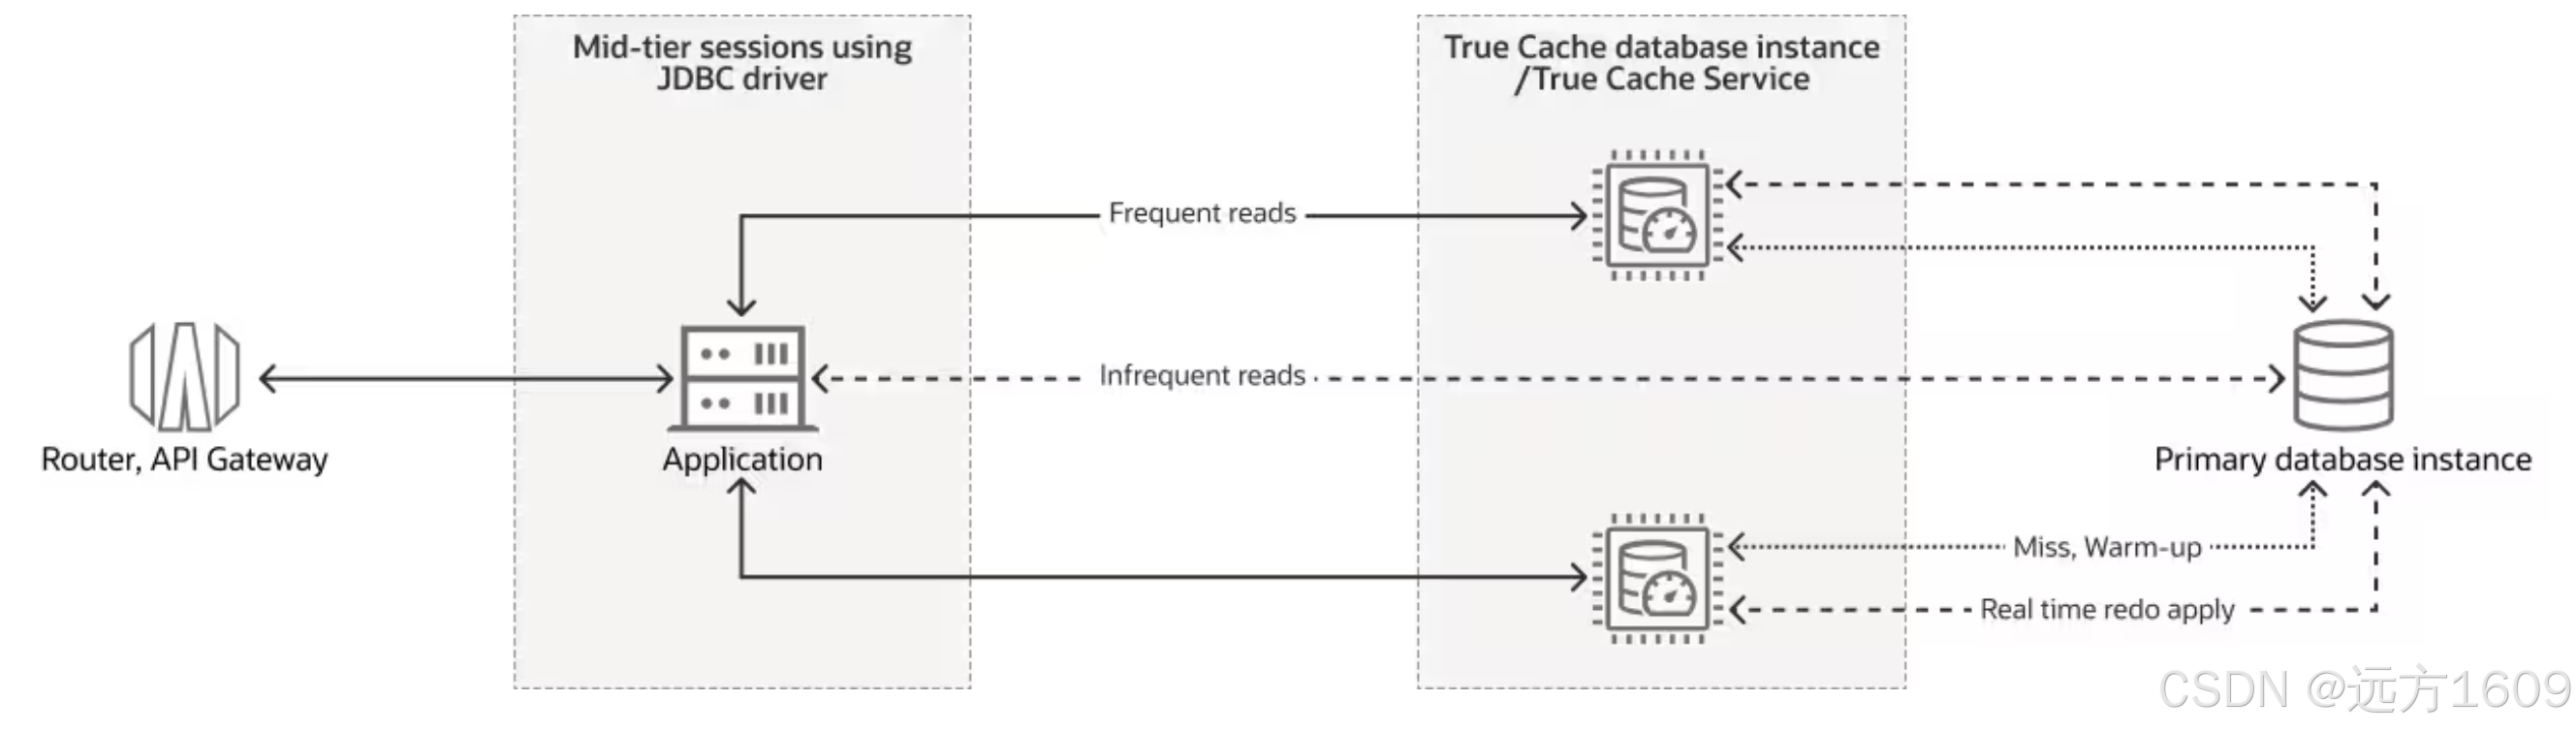
2、Oracle True Cache体系架构
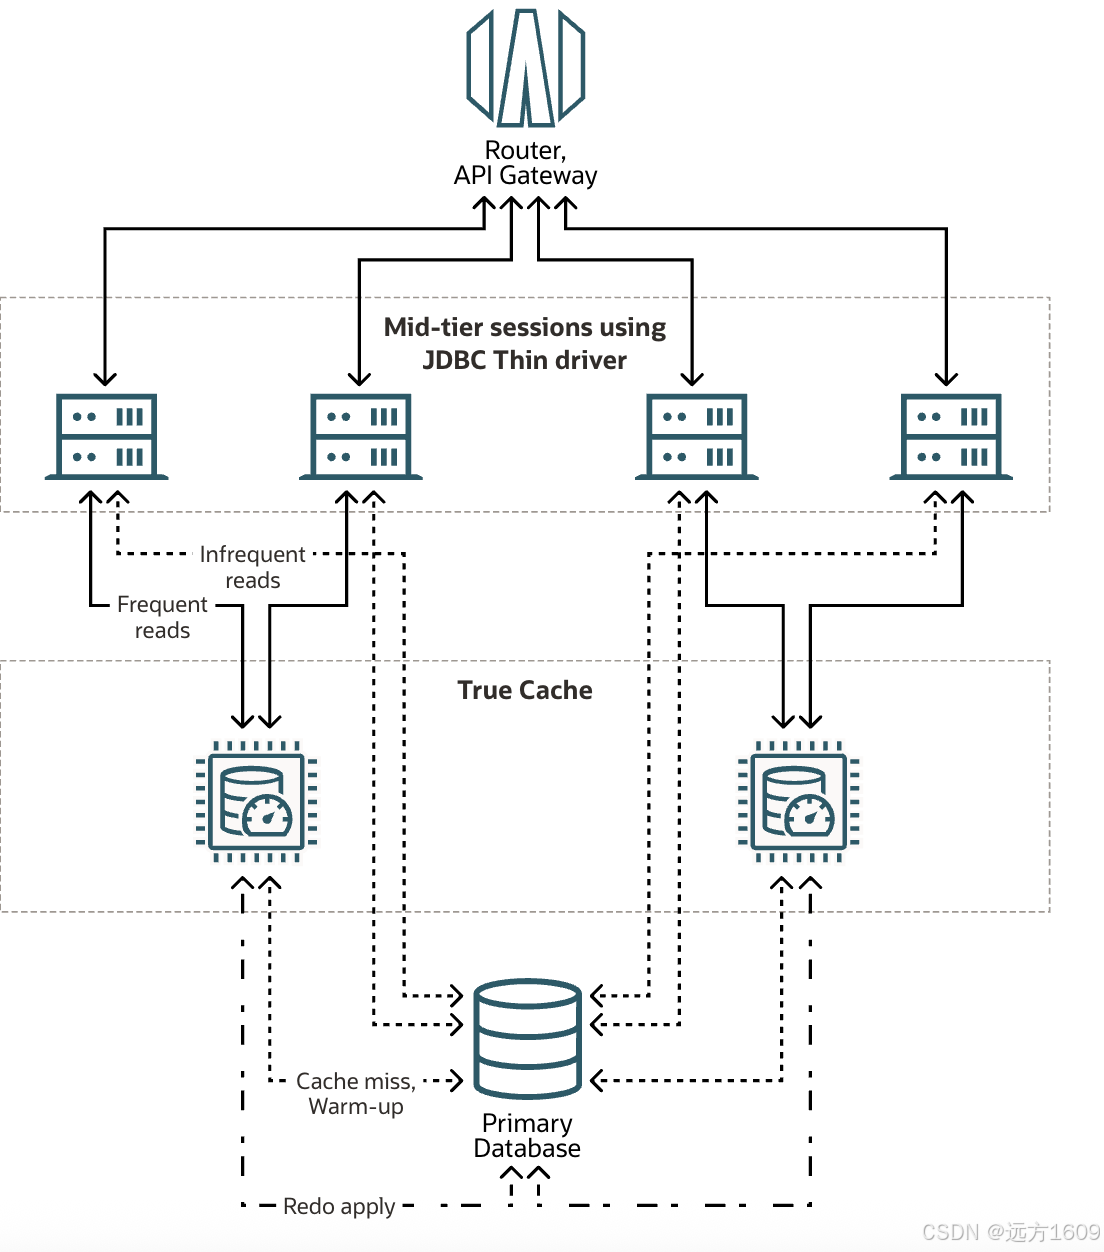

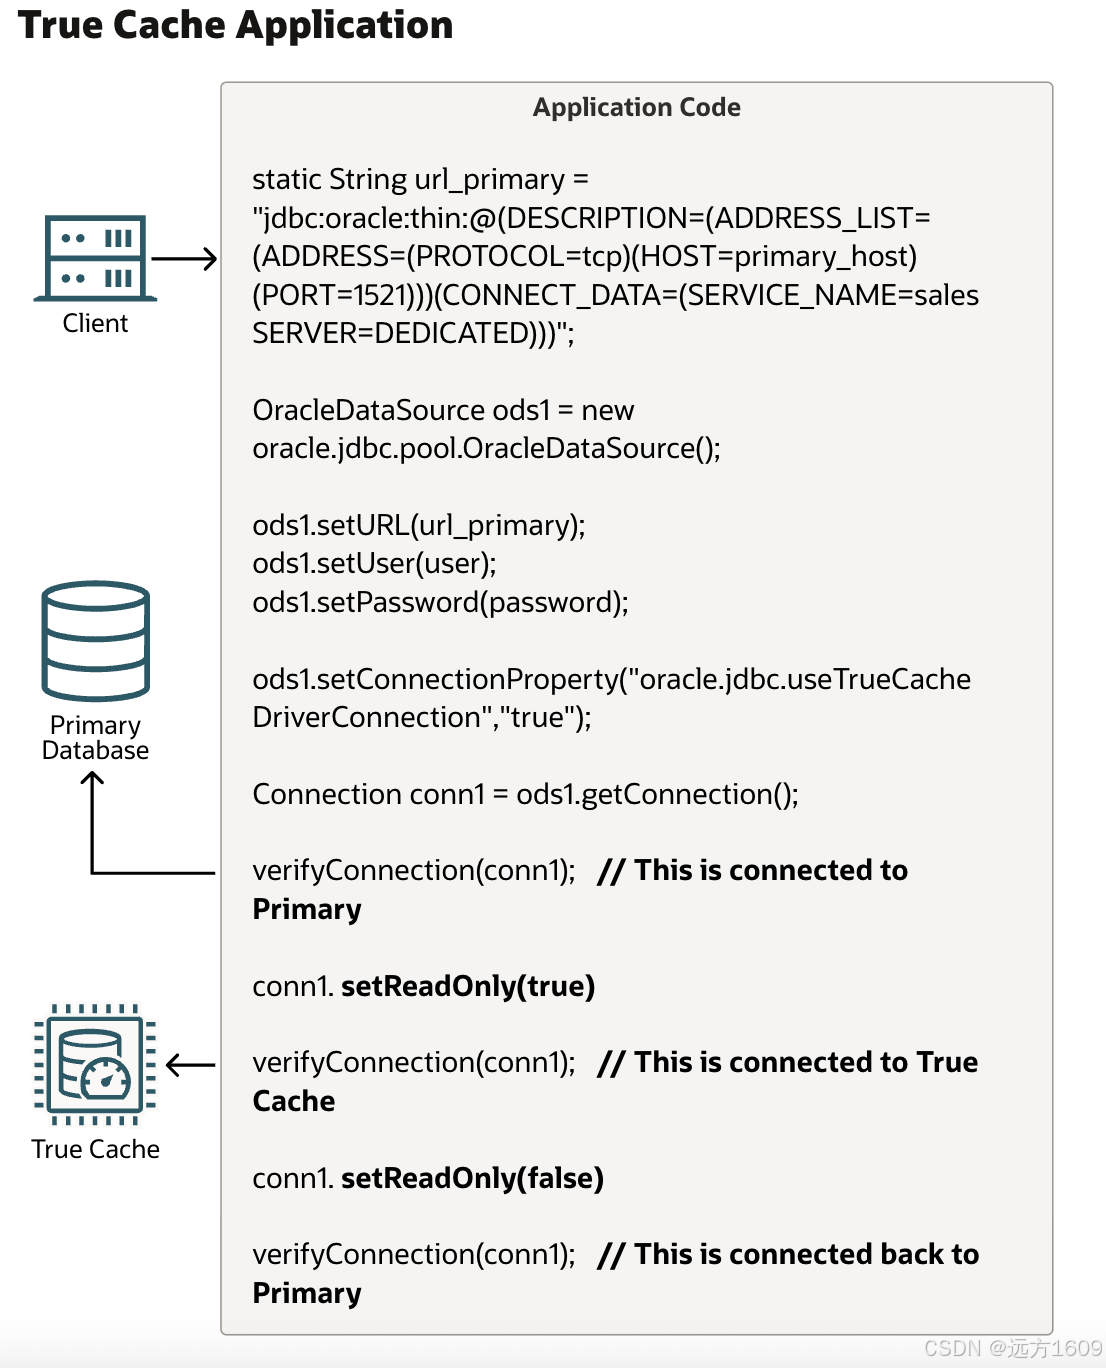
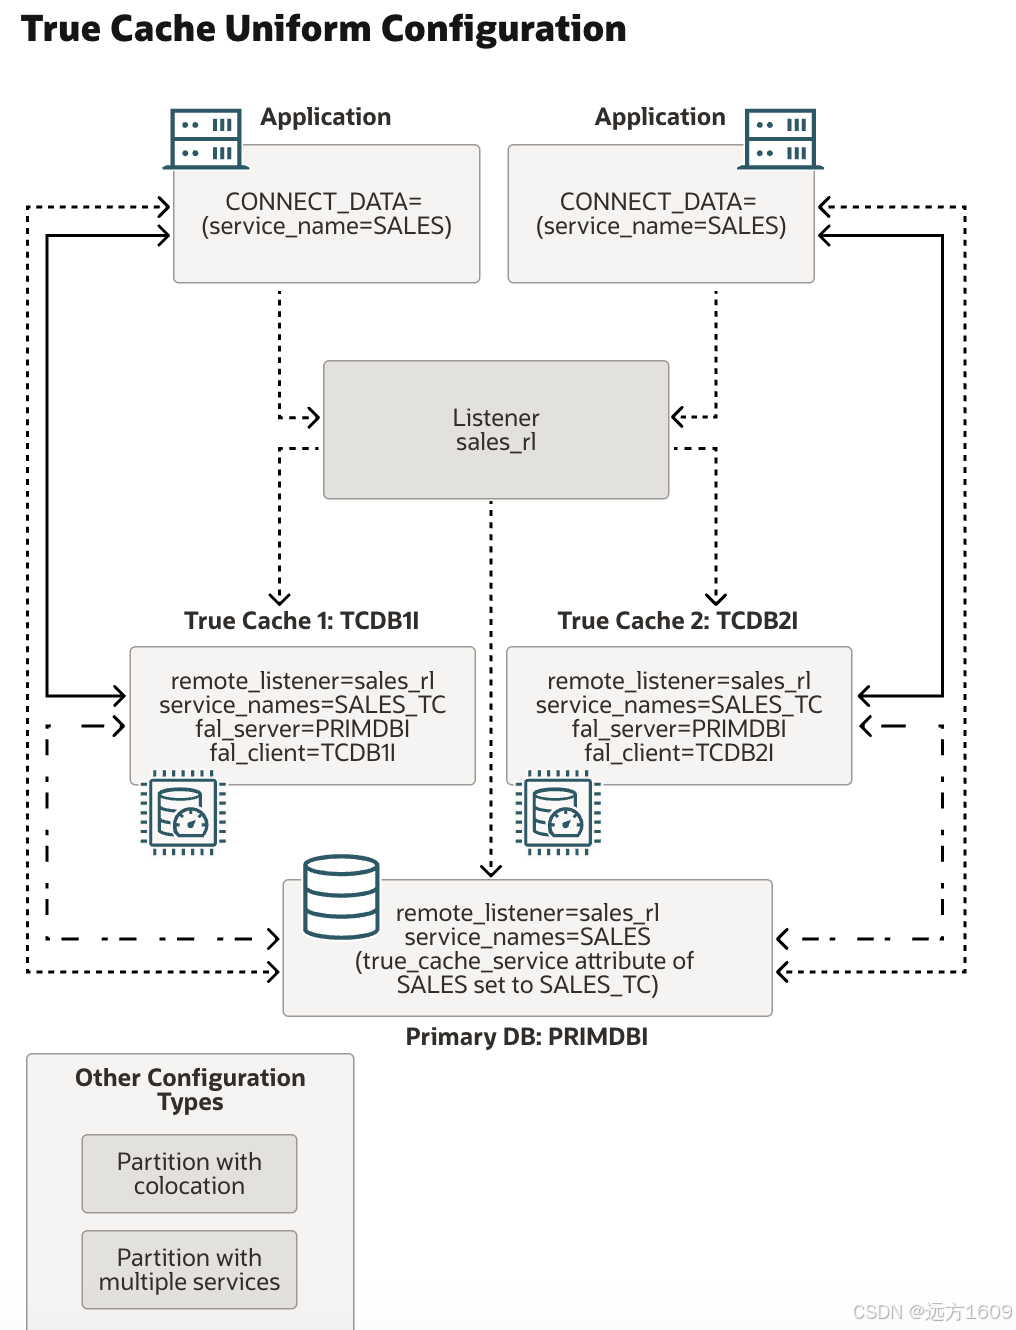

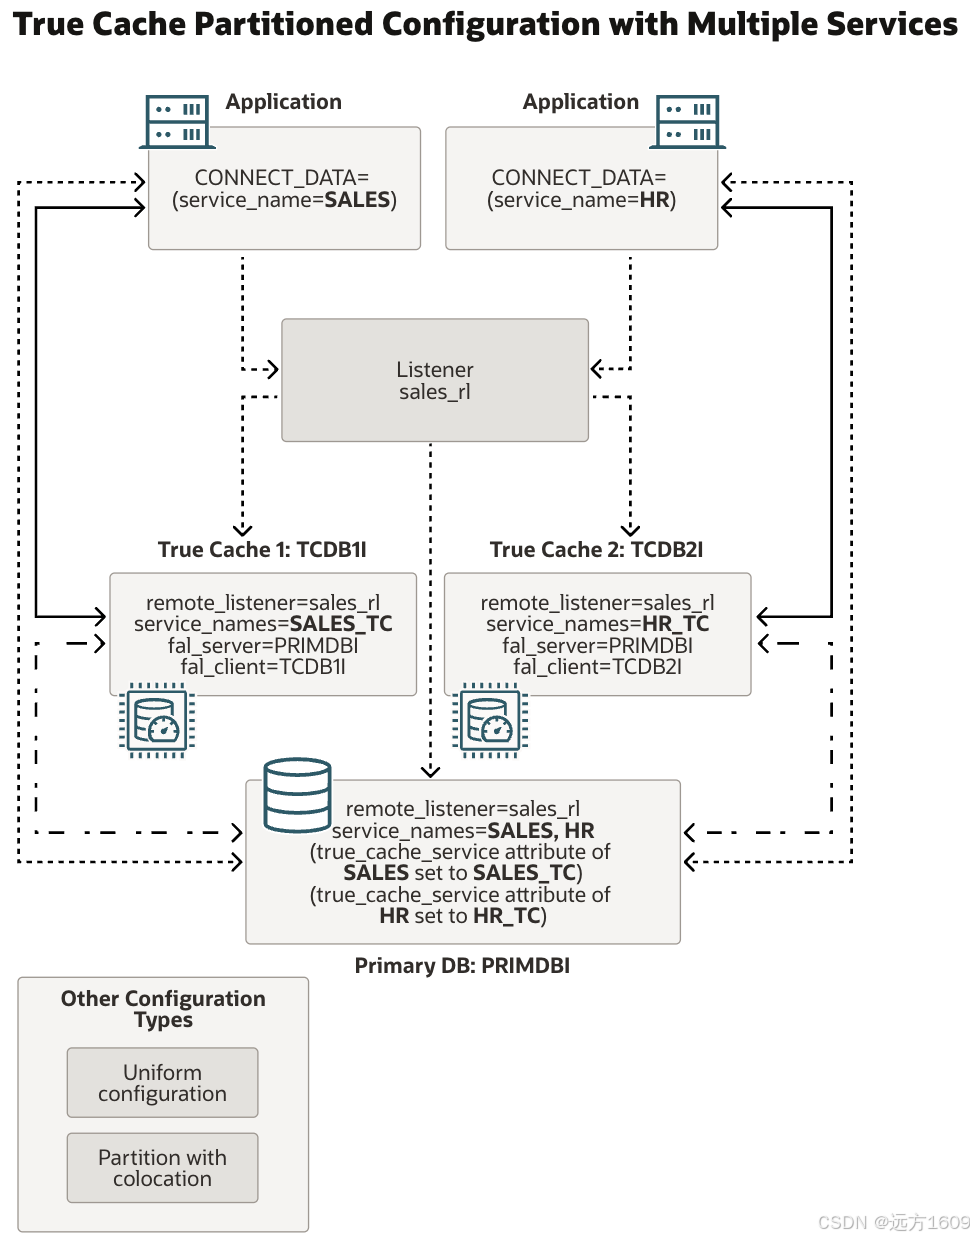
3、Oracle True Cache 的工作原理
Oracle True Cache 仅使用其缓冲区缓存中的数据来满足查询需求。与 Oracle Active Data Guard 一样,True Cache 是主数据库的全功能只读复制,但是它没有数据文件存在磁盘上,是ADG的无盘模式,使用内存替代ADG中的硬盘存储,将数据缓存同时保持数据事务一致性。
现代应用通常需要大量的连接以及速度快且低延迟的数据访问。其中一种主流做法是将高速缓存放置在数据库前面,因为应用所执行的读取次数通常会比更新次数多,并且可以在不影响数据库性能的情况下从高速缓存中读取。例如,当客户在搜索机票时,航空公司预订系统需要频繁地读取数据。即使这些数据并不是数据库中最新的数据,那也没关系,因为应用只需要在客户预订航班时访问最新数据。
与传统高速缓存不同,True Cache 会自动将经常访问的数据保存在高速缓存中,并使高速缓存与主数据库、同一高速缓存中的其他对象和其他高速缓存保持一致。True Cache 会针对所有 Oracle Database 对象和数据类型(包括 JSON)进行高速缓存。
由于 True Cache 实施了 Oracle Database 安全策略,因此您可以控制对高速缓存的访问。这使您能够对敏感数据进行高速缓存,例如您通常不会想要进行高速缓存的个人信息。
由某个应用决定要从 True Cache 还是从主数据库查询数据。例如,有些应用会维护两条连接,一条是指向 Oracle True Cache 的只读连接,另一条则是指向数据库的读/写连接。Java 应用可以使用其中一个连接,并通过设置只读属性,在 True Cache 和数据库之间进行动态切换。
使用 Oracle True Cache,单次查询中的数据将始终保持一致。当在应用层面执行了跨行连接时,这一点尤为重要,否则可能引发结果错误。
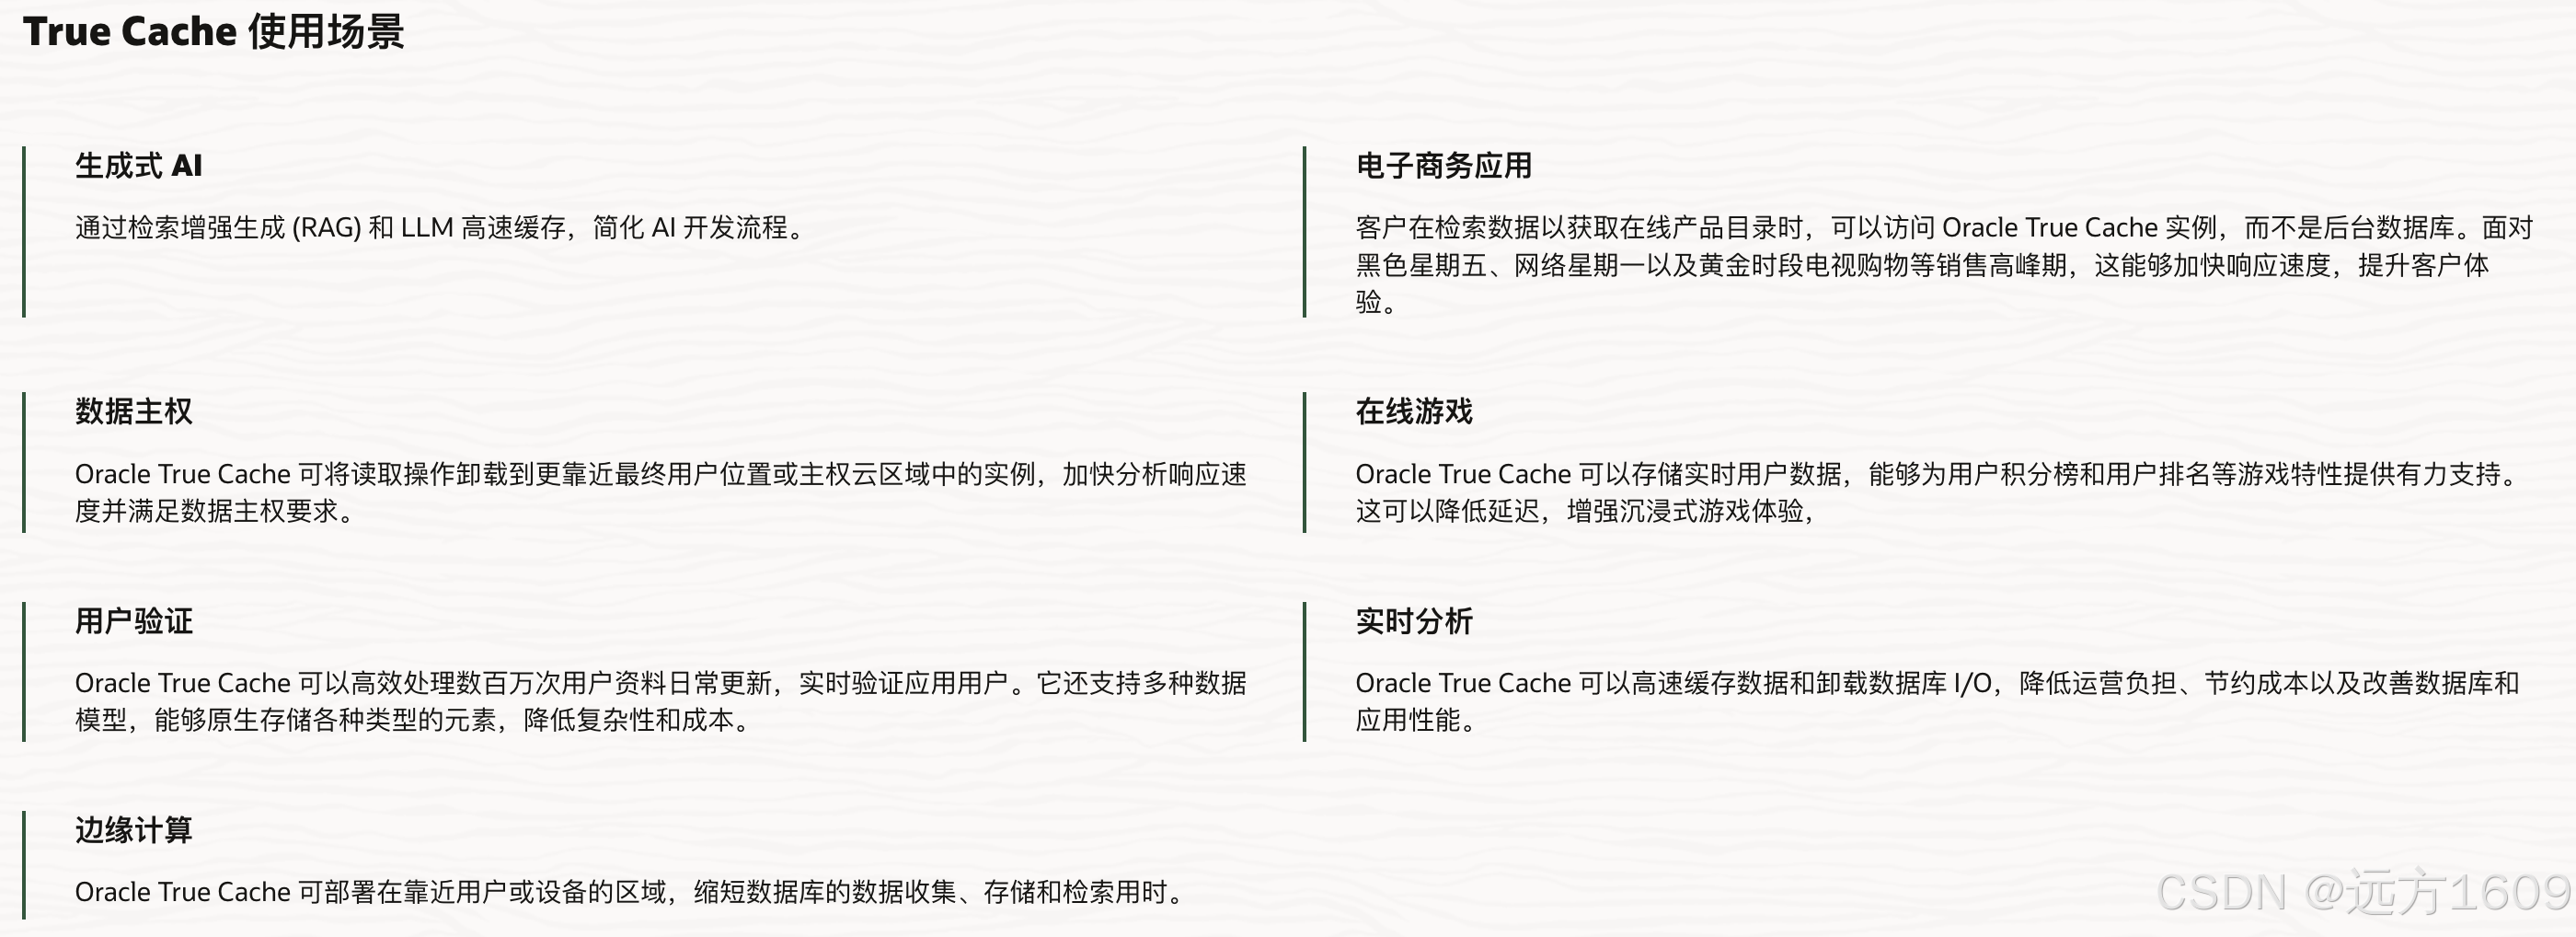
4、适用场景
实时、一致的数据
Oracle True Cache 会自动将经常访问的数据保存在高速缓存中,从而使高速缓存与数据库保持一致。
简化高速缓存管理
缓存内容会在访问时自动加载,并在数据更改时刷新。Oracle True Cache 支持所有 Oracle Database 对象和数据类型,包括关系、JSON、文本、空间、图形和向量数据类型。用户可以使用相同的 Oracle Database API,以行或列格式访问 True Cache 中的数据。
提高可扩展性
Oracle True Cache 卸载查询工作负载,减少面向数据库的请求次数,从而提高可扩展性和应用响应速度。
经济高效的生成式 AI
检索增强生成 (RAG) 通常涉及对大型语言模型 (LLM) 的后端调用。针对这些结果进行高速缓存可降低与 LLM 使用相关的成本。
对经过扩展的高速缓存使用高性能闪存
如果 True Cache 计算实例的内存中不足以容纳数据,True Cache 也支持将数据存储在磁盘上。这样一来,高速缓存可以存储的数据量超过了计算实例内存中可容纳的数据量,从而扩展了高速缓存的总大小。
高可用性和多线程
True Cache 利用多线程并利用主机上的所有核心/vCPU 实现超高性能,重新定义了高速缓存管理。True Cache 可以确保原生的高可用性,在节点故障或网络中断期间保证数据可恢复性和持续可用性。
5、业务侧优势
- 从主数据库卸载查询,提高可扩展性和性能。
- 在更靠近应用的地方部署 True Cache,缩短应用响应时间,减少网络延迟。尤其适用于为满足数据驻留要求,而将数据库与应用分别部署在不同位置的情况。
- 将数据分散到多个 True Caches,创建庞大的内存中存储区域。所有 True Caches 中高速缓存数据的总量可能比单个主数据库或高速缓存的大小大得多。
- 自动维护高速缓存内容。
- 对应用保持透明,简化开发和维护。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/566837/viewspace-3088499/ ,如需转载,请注明出处,否则将追究法律责任。

