神经网络反向传播的推导
对于神经网络的训练过程而言,其反向传播算法是训练过程的核心,神经网络根据预测值y^与实际值y的偏差从后向前来计算损失函数对于各个参数的梯度,从而利用梯度下降的方法来优化训练神经网络的各个参数。
神经网络的计算流程图如下:
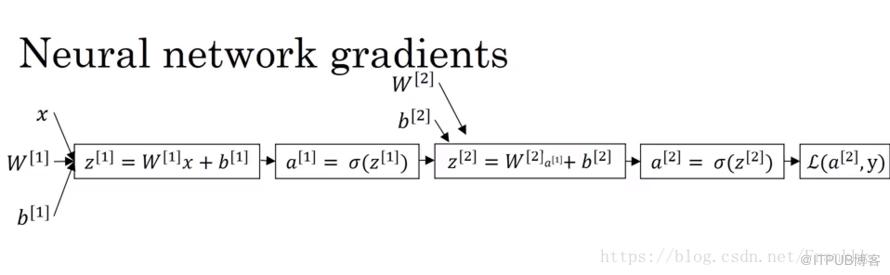
从该流程图可以看到,如果我们要计算神经网络的参数W[1],b[1],W[2],b[2],首先需要计算∂L∂a[2]和∂a[2]∂z[2],然后根据链式法则得到∂L∂z[2]=∂L∂a[2]∂a[2]∂z[2]。
之后再计算∂z[2]∂W[2]和∂z[2]∂b[2],同样根据链式法则可以得到∂L∂W[2]=∂L∂z[2]∂z[2]∂W[2]以及得到∂L∂b[2]=∂L∂z[2]∂z[2]∂b[2]。这样便得到了dW[2]和db[2]。
另外对于dW[1]和db[1]的计算,需要先计算∂z[1]∂W[1],∂a[1]∂z[1]和∂z[2]∂a[1],同样根据链式法则可以得到∂L∂W[1]=∂L∂z[2]∂z[2]∂a[1]∂a[1]∂z[1]∂z[1]∂W[1],以及∂L∂b[1]=∂L∂z[2]∂z[2]∂a[1]∂a[1]∂z[1]∂z[1]∂b[1]。这样也得到了dW[1]和db[1]。
在使用随机梯度下降(SGD)优化算法以及交叉熵(Cross Entropy)损失函数的时候,我们令a[2]=y^,即损失函数:
L(y^,y)=−(ylogy^+(1−y)log(1−y^))
使用sigmoid激活函数,即
a[1]=σ(z[1])=11+e−z[1]a[2]=σ(z[2])=11+e−z[2]
将该激活函数和损失函数代入上面的计算过程,可以得到:
dz[2]=a[2]−ydW[2]=dz[2]a[1]Tdb[2]=dz[2]dz[1]=W[2]Tdz[2]∗σ′(z[1])dW[1]=dz[1]xTdb[1]=dz[1]
在进行随机梯度下降的过程中,随机选取样本中的一个错误分类点,根据该点计算当前的dW[1],db[1],dW[2],db[2],然后利用以下公式来更新W[1],b[1],W[2],b[2]:
W[2]:=W[2]−α∗dW[2]b[2]:=b[2]−α∗db[2]W[1]:=W[1]−α∗dW[1]b[1]:=b[1]−α∗db[1]
直到收敛为止。
对于神经网络的训练,还有批量梯度下降(Batch Gradient Descent)和小批量梯度下降(Mini-Batch Gradient Descent),带动量的随机梯度下降(Momentum),RMSProp,Adam等方法,后面再做详解。
To be continue…
原文出处

