如果❤️我的文章有帮助,欢迎点赞、关注。这是对我继续技术创作最大的鼓励。[更多系列文章在我博客] coderdao.github.io/
场景
今天隔离还在继续,在家办公。忽然下午午工作群里发来一个 mysql 机器io/负载上升的预警,异常发生在 15:45 ~ 16:00 之间。为了事后为了查明原因,需要翻看慢查询日志 slow.log 才发现日志 8G 多… 故事就这样开始了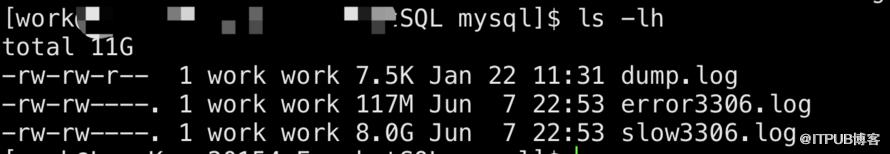
怎么办呢。第一个想到的就是常用 grep 匹配关键字
grep 关键字
grep 常用于 关键字 匹配文件文本信息。
但关键字从哪里来呢,可以命令 head slow3306_9110.log 查看下检索文件的内容结构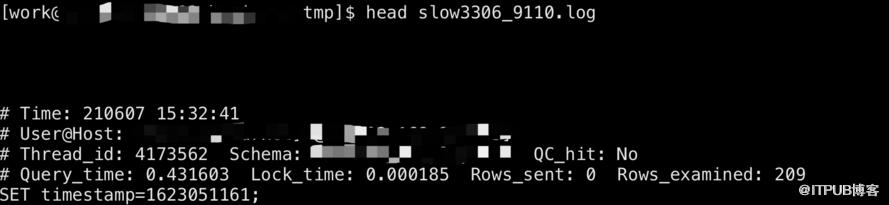
因为异常发生在 15:45 ~ 16:00 之间,我就可以这样写
grep -n ‘Time: 210607 15:[45-59]’ slow3306_9110.log
时间 15:45 至 15:59 之间内容,但这样匹配只能看到时间,这明显不是我们想要的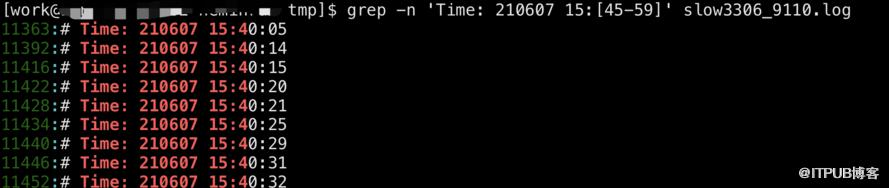
grep 显示匹配行附近内容
- A -> After
- B -> Before
- C -> Context
举个例子:
grep -A5 'Time: 210607 15:[45-59]' slow3306_9110.log
就能把匹配 Time: 210607 行的下面 5 行也显示出来。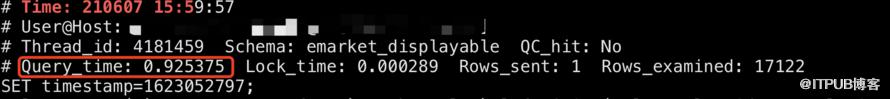
grep 多关键字搜索
但这时我们有会发现,Query_time: 0.925375 查询时间有大有小。我现在在查故障明细是只想看 查询消耗时间大的。
所以这里就需要用到 grep 多关键字搜索
匹配多个关键字(且)
管道符连接 多个条件 实现关键字 且关系 匹配:
grep -A5 ‘Time: 210607 15:[45-59]’ slow3306_9110.log | grep ‘Query_time: (d[2-5])’
同一行同时满足两个条件(Time、Query_time)才能够匹配。
不过这里也必须说明:因为上图内容格式中,Time 和 Query_time 不在同一列,所以上诉命令只是这个演示。实际只能匹配 同一行同时满足两个条件 内容
grep -E 匹配多个关键字(或)
grep -E “word1|word2|word3” file.txt
匹配文件中 同一行包含 word1、word2、word3 之一
总结
总结下来。
- 由于多行无法同时命中
时间 15:45 至 15:59和查询时间在 2~5位整数之间。 - 另外由于文件太大,grep 一次就能跑个 3、4 分钟实际体验并不好
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/3276/viewspace-2807126/ ,如需转载,请注明出处,否则将追究法律责任。

