随着 近年来物 联网 (IoT) 的快速发展 ,时间序列数据出现了爆炸式增长。 根据过去两年DB-Engines数据库类型的增长趋势,时间序列数据库的增长是巨大的。 这些大型开源时间序列数据库的实现是不同的,并且它们都不是完美的。 但是,这些数据库的优点可以结合起来实现完美的时间序列数据库。
阿里云 表存储 是由阿里云开发的分布式NoSQL数据库。 Table Store使用多模型设计,包括与BigTable相同的宽列模型和用于消息数据的时间序列模型。 在存储模型,数据大小以及写入和查询功能方面,它可以满足时间序列数据场景的需求。 但是,作为通用模型数据库,时间序列数据存储应充分利用底层数据库的功能。 在模式设计和计算对接中,必须有一个特殊的设计,例如OpenTSDB的HBase和UID编码的RowKey设计。
本文重点介绍时间序列数据的数据模型定义和核心处理流程,以及基于 Table Store 构建时间序列数据存储的体系结构 。 我们将首先讨论时间序列数据,然后讨论如何使用Table Store为我们的业务应用程序处理这些数据。
什么是时间序列数据?
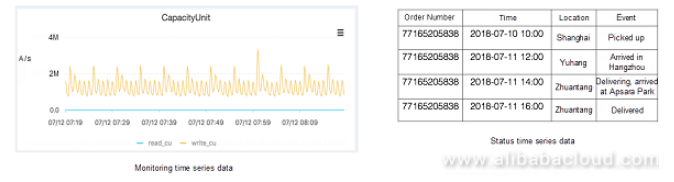
时间序列数据主要分为两种类型,用于监控和状态。 当前的开源时间序列数据库针对用于监视的时间序列数据,并且针对该场景中的数据特征进行了一些特定的优化。 就时间序列数据的特征而言,另一种类型是状态的时间序列数据。 两种类型的时间序列数据对应于不同的场景。 监控类型对应监控场景,状态类型对应其他场景,如跟踪和异常状态记录。 最常见的包跟踪是状态的时间序列数据。
两种类型的数据被分类为时间序列的原因是这些类型在数据模型定义,数据收集,数据存储和计算中是完全一致的,并且可以抽象相同的数据库和相同的技术体系结构。
时间序列数据模型
在定义时间序列数据模型之前,我们首先对时间序列数据进行抽象表示。
-
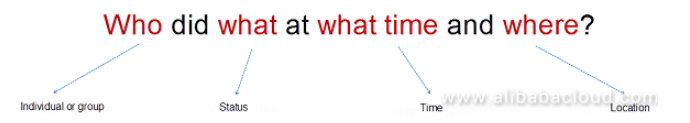
个人或团体(WHO): 描述产生数据的主题,可以是人,监测指标或对象。 它通常描述个人具有多维属性,并且可以使用某个唯一ID来定位个人,例如,使用人ID来定位人,以及使用设备ID来定位设备。 还可以通过多维属性定位个人,例如,使用群集,机器ID和进程名称来定位进程。
-
时间(WHEN): 时间是时间序列数据的最重要特征,是将其与其他数据区分开来的关键属性。
-
位置(地点): 在气象学等科学计算领域,位置通常由纬度和经度的二维坐标以及纬度,经度和海拔的三维坐标来定位。
-
状态(WHAT): 用于描述特定时刻特定个人的状态。 用于监视的时间序列数据通常是数字描述状态,并且跟踪数据是事件表达状态,其中针对不同场景存在不同的表达。
以上是时间序列数据的抽象表示。 每个开源时间序列数据库都有自己的时间序列数据模型定义,定义了用于监视的时间序列数据。 以OpenTSDB的数据模型为例:
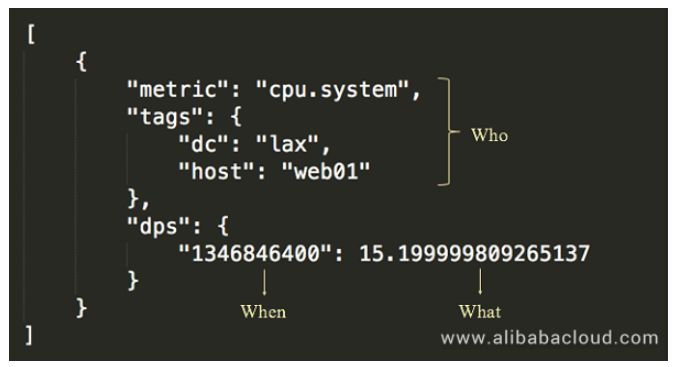
监控时间序列数据模型定义包括:
-
指标: 用于描述监控指标。
-
标签: 用于定位受监控对象,由一个或多个标签描述。
-
时间戳: 收集监控值的时间点。
-
值: 收集的监视值,通常为数字。
监视时间序列数据是最典型的时间序列数据类型,具有特定的特征。 监视时间序列数据的特征确定这样的时间序列数据库具有特定的存储和计算方法。 与状态时间序列数据相比,它在计算和存储方面具有特定的优化。 例如,聚合计算具有几个特定的数字聚合函数,并且将在存储上具有特别优化的压缩算法。 在数据模型中,监控时间序列数据通常不需要表示位置,而整体模型符合我们对时间序列的统一抽象表示。
基于监测时间序列数据模型,我们可以根据上述时间序列数据抽象模型定义时间序列数据的完整模型:
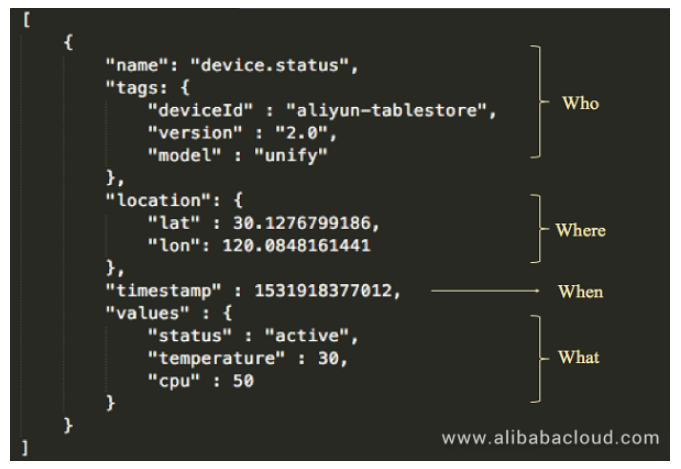
该定义包括:
-
名称: 定义数据的类型。
-
标签: 描述个人的元数据。
-
位置: 数据的位置。
-
时间戳: 生成数据时的时间戳。
-
值: 与数据对应的值或状态。 可以提供多个值或状态,这些值或状态不一定是数字。
这是一个更完整的时间序列数据模型,与OpenTSDB的监控时间序列数据的模型定义有两个主要差异:第一,元数据中还有一个维度,位置; 第二,它可以表达更多的价值观。
时间序列数据查询,计算和分析
时间序列数据有自己的查询和计算方法,大致包括:
时间序列检索
根据数据模型定义,名称+标签+位置可用于定位具有时间序列的个体,时间序列上的点是时间戳和值。 对于时间序列数据的查询,首先需要定位时间序列,该时间序列是基于元数据的一个或多个值的组合的检索过程。 您还可以根据元数据的关联向下钻取。
时间范围查询
通过检索定位时间序列后,将查询时间序列。 对时间序列上的单个时间点的查询非常少,并且查询通常在连续时间范围内的所有点上。 通常在这个连续时间范围内对缺失点进行插值。
聚合
查询可以是单个时间序列或多个时间序列。 对于多个时间序列的范围查询,通常会聚合结果。 该聚合用于不同时间序列上的相同时间点的值,通常称为“后聚合”。
与“后聚合”相反的是“预聚合”,这是在时间序列数据存储之前将多个时间序列聚合成一个时间序列的过程。 预聚合计算数据然后存储它,而后聚合查询存储的数据然后计算它。
下采样
下采样的计算逻辑与聚合的计算逻辑类似。 不同之处在于下采样是针对单个时间序列而不是多个时间序列,其在单个时间序列中聚合时间范围内的数据点。 下采样的目的之一是使数据点在很大的时间范围内呈现,另一个目的是降低存储成本。
分析
分析是从时间序列数据中提取更多价值。 有一个特殊的研究领域叫做“时间序列分析”。
时间序列数据处理程序
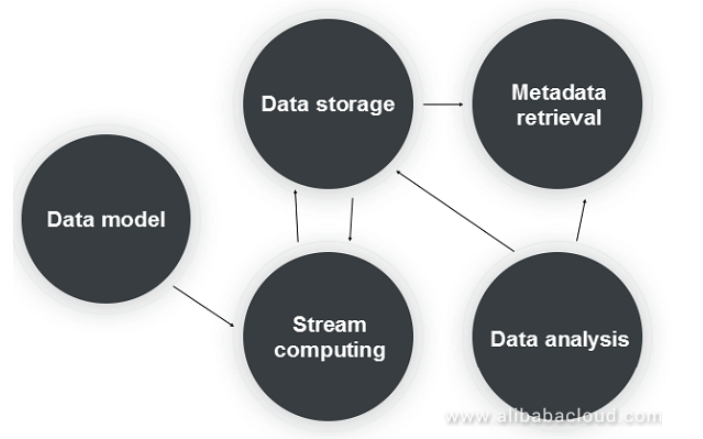
时间序列数据处理的核心流程如上图所示,包括:
-
数据模型: 对于时间序列数据的标准定义,收集的时间序列数据必须符合模型的定义,包括时间序列数据的所有特征属性。
-
流计算: 时间序列数据的预聚合,下采样和后聚合。
-
数据存储: 存储系统提供高吞吐量,大规模和低成本的存储,支持冷/热数据分离和有效的范围查询。
-
元数据检索: 提供1000万到1亿的时间序列元数据的存储和检索,并支持不同的检索方法(多维过滤和位置查询)。
-
数据分析: 为时间序列数据提供时间序列分析和计算功能。
让我们看看这些核心流程中可用于产品选择的产品。
数据存储
时间序列数据是典型的非关系数据。 它具有高并发性,高吞吐量,大数据量,高写入和低读取的特点。 查询模式通常是范围查询。 对于这些数据特性,非常适合使用NoSQL等数据库。 几个流行的开源时间序列数据库使用NoSQL数据库作为数据存储层,例如基于HBase的OpenTSDB和基于Cassandra的KairosDB。 因此,对于“数据存储”的产品选择,可以选择诸如HBase或Cassandra的开源分布式NoSQL数据库,或者诸如阿里云的表存储之类的云服务。
流计算
对于流计算,可以使用诸如JStrom,Spark Streaming和Flink等开源产品,或云 上的 阿里巴巴Blink和云产品 StreamCompute 。
元数据搜索
时间序列的元数据也将很大,因此首先考虑分布式数据库。 另外,由于查询模式需要支持检索,数据库需要支持互连索引和空间索引,并且可以使用开源Elasticsearch或Solr。
数据分析
数据分析需要强大的分布式计算引擎,开源Spark,云产品 MaxCompute 或无服务器SQL引擎,如Presto或云产品Data Lake Analytic。
开源时间序列数据库
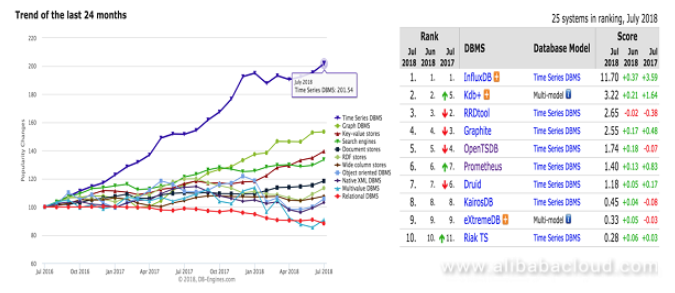
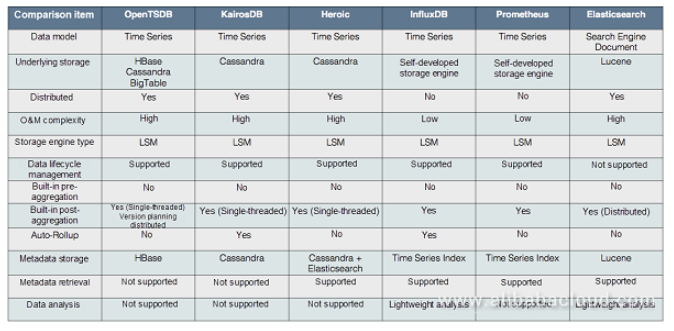
基于DB-Engines的数据库开发趋势,我们看到时间序列数据库在过去两年中迅速发展,并且出现了许多优秀的开源时间序列数据库。 主要时间序列数据库的每个实现也有其自身的优点。 以下是一些维度的综合比较:
-
数据存储: 所有数据库都使用分布式NoSQL(LSM引擎)存储,包括HBase和Cassandra等分布式数据库,BigTable等云产品,以及自行开发的存储引擎。
-
聚合: 预聚合只能依赖外部流计算引擎,例如Storm或Spark Streaming。 在后聚合级别,查询后聚合是一个交互式过程,因此它通常不依赖于流计算引擎。 不同的时间序列数据库提供单线程简单方法或并发计算方法。 自动下采样也是一种后聚合过程,但它只是一个流过程而不是一个交互过程。 该计算适用于流计算引擎,但不以这种方式实现。
-
元数据存储和检索: 经典的OpenTSDB没有专用的元数据存储,也不支持元数据的检索。 通过扫描数据表的行键来检索和查询元数据。 KairosDB在Cassandra中使用表格进行元数据存储,但检索效率非常低,因为需要扫描表格。 Heroic是基于KairosDB开发的。 它使用Elasticsearch进行元数据存储和索引,并支持更好的元数据检索。 InfluxDB和Prometheus独立实现索引,但索引并不容易,需要1000万到1亿的时间序列元数据。 InfluxDB在早期版本中实现了基于内存的元数据索引,该版本有许多限制,例如,内存的大小将限制时间序列的大小,
-
数据分析: 除了Elasticsearch之外,大多数TSDB自然不具有除了查询和分析功能以外的分析功能,这对于它在时间序列字段中保持立足点是一个重要的优势。
表存储时间序列数据存储
作为由阿里云开发的分布式NoSQL数据库,Table Store在数据模型方面使用与Bigtable相同的宽列模型。 该产品非常适用于存储模型,数据大小以及写入和查询功能方面的时间序列数据方案。 我们还支持监控时间序列产品,如 CloudMonitor ,状态时间序列产品,如AliHealth的药物追踪,以及核心服务,如邮政包裹追踪。 还有一个完整的计算生态系统来支持时间序列数据的计算和分析。 在未来的规划中,我们针对时间序列场景对元数据检索,时间序列数据存储,计算和分析以及成本降低进行了具体优化。
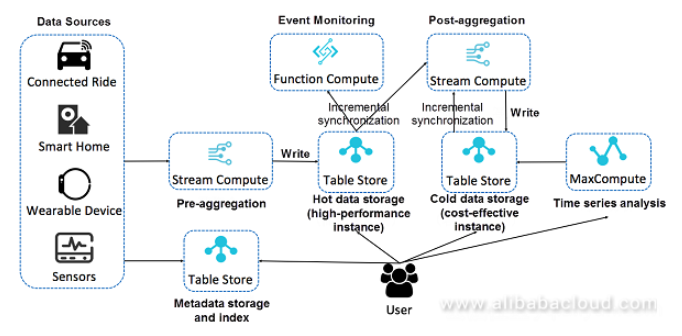
以上是基于Table Store的时间序列数据存储,计算和分析的完整架构。 这是一种无服务器架构,通过组合云产品实现提供完整时间序列场景所需的所有功能。 每个模块都具有分布式架构,提供强大的存储和计算功能,并且可以动态扩展资源。 每个组件也可以替换为其他类似的云产品。 该架构非常灵活,与开源时间序列数据库相比具有很大的优势。 该架构的核心优势如下:
存储和计算的分离
存储计算的分离是一种领先的技术架构。 其核心优势是提供更灵活的计算和存储资源配置,更灵活的成本,更好的负载平衡和数据管理。 在云环境中,为了让用户真正利用存储和计算分离带来的好处,需要提供用于分离存储和计算的产品。
Table Store以技术架构和产品形式实现存储和计算的分离,并且可以以相对低的成本自由地分配存储和计算资源。 这在时间序列数据场景中尤其重要,其中计算是相对恒定的,并且存储线性增长。 优化成本的主要方法是分配恒定的计算资源和无限可扩展的存储,而无需额外的计算成本。
分离冷/热数据
时间序列数据的一个显着特征是存在独特的热和冷数据访问,并且最近更频繁地访问写入的数据。 基于此特性,热数据采用IOPS较高的存储介质,大大提高了整体查询效率。 Table Store提供两种类型的实例:高性能实例和经济高效的实例,分别对应SSD和SATA存储介质。 服务功能允许用户根据不同精度的数据和不同的查询和分析性能要求,自由分配不同规格的表。 例如,对于高并发和低延迟查询,分配高性能实例; 对于冷数据存储和低频查询,分配了具有成本效益的实例。 对于需要高速的交互式数据分析,可以分配高性能实例。 对于时间序列数据分析和离线计算的场景,可以分配具有成本效益的实例。
对于每个表,可以自由定义数据的生命周期,例如,对于高精度表,可以配置相对较短的生命周期。 对于低精度表,可以配置更长的生命周期。
大部分存储空间用于冷数据。 对于这部分访问频率较低的数据,我们将通过擦除编码和终极压缩算法进一步降低存储成本。
闭环数据流
流计算是时间序列数据计算中的核心计算方案,其对时间序列数据执行预聚合和后聚合。 通用监控系统架构使用前端流计算解决方案。 数据的预聚合和下采样都在前端流计算中执行。 也就是说,数据在存储之前已经被处理,而存储的只是结果。 不再需要第二个下采样,并且可能仅需要后聚合的查询。
Table Store与Blink深度集成,现在可作为Blink维护表和结果表使用。 源表已经开发并准备发布。 Table Store可以用作Blink的源和后端,整个数据流可以形成一个闭环,可以带来更灵活的计算配置。 进入闪烁后,原始数据将进行数据清理和预聚合,然后写入热数据表。 该数据可以自动流入Blink进行后聚合,并支持一段时间的历史数据回溯。 可以将后聚合的结果写入冷存储。
除了与Blink集成之外,Table Store还可以与Function Compute集成以进行事件编程,并且可以在时间序列场景中启用实时异常状态监视。 它还可以通过Stream API读取增量数据以进行自定义分析。
大数据分析引擎
Table Store与阿里云实现的分布式计算引擎深度集成,例如 MaxCompute (以前的ODPS)。 MaxCompute可以直接读取表存储上的数据进行分析,从而消除了数据的ETL过程。
整个分析过程中有一些优化,例如,通过索引优化查询,并在底部提供更多运算符来计算下推。
服务能力
总之,Table Store的服务功能的特点是零成本集成,开箱即用,全局部署,多语言SDK和完全托管服务。
元数据存储和检索
元数据也是时间序列数据中非常重要的部分。 它在数量上比时间序列数据小得多,但它比查询复杂性中的时间序列数据复杂得多。
根据我们上面提供的定义,元数据主要分为标签和位置。 标签主要用于多维检索,而位置主要用于位置检索。 因此对于底层存储,Tags必须实现反向排名索引以提供有效的检索,并且Location需要实现位置索引。 服务级别监控系统或跟踪系统的时间顺序为1000万到1亿或更高。 元数据还需要分布式检索系统来提供高并发性低延迟解决方案,业界最好的实现方法是使用Elasticsearch来存储和检索元数据。
摘要
阿里云 表存储 是一个支持多种数据模型的通用分布式NoSQL数据库。 当前可用的数据模型包括宽列(BigTable)和时间序列(消息数据模型)。
在行业中类似数据库产品(如HBase和Cassandra)的应用中,时间序列数据是一个非常重要的领域。 Table Store不断探索时间序列数据存储。 我们在流计算数据闭环,数据分析优化和元数据检索过程中不断完善,提供统一的时间序列数据存储平台。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/31557424/viewspace-2221521/ ,如需转载,请注明出处,否则将追究法律责任。

