数据集成曾被视为后台的“管道工程”。虽然实施困难,且在运营层面至关重要,但它很少被当作战略性资产。如今,这一认知已经改变。《2026年数据集成格局》通过三种通信范式以及所有主流厂商,描绘了这一转变。全球头部软件公司正在重金押注集成层:IBM 以 110 亿美元收购 Confluent,Salesforce 以 80 亿美元收购 Informatica,Qlik 收购 Talend,TIBCO 并入 Cloud Software Group,Fivetran 与 dbt Labs 合并。当集成厂商的估值达到如此高位时,集成层已不再是理所当然的基础设施,而是企业的战略性资产。
这种压力已经积累了很长时间。数据量持续爆发式增长,数字化不断将更多业务推向实时化轨道,企业对数据新鲜度的需求也多年持续攀升。AI 是最新、也是最紧迫的驱动因素。模型和自主智能体需要的是实时、可治理且持续流动的数据。依赖夜间批处理任务和返回“昨日状态”的 API,无法支撑需要即时决策的系统。基于过时数据运行的智能体不会直接触发明显的错误告警,反而会“自信地”做出错误行为。这让企业过去十年来一直难以解决的问题变得更加严峻。
什么是三种数据集成范式?
三种数据集成范式分别是:请求-响应、批处理和事件流。理解这一领域的最 佳方式,不是从供应商出发,而是看数据实际如何流动。选择哪种范式作为核心,是企业最具影响力的架构决策之一。
请求-响应是最常见的方式。一个系统向另一个系统请求数据并等待返回。REST API、GraphQL,以及各类 API 管理和网关产品都采用这种模式。它适合获取记录、提交订单等事务性交互,但会将调用方与被调用方紧密耦合:你必须知道目标系统的位置,并等待其响应。
批处理按照计划批量移动数据。它在历史数据回填、分析处理、监管报告和 AI 模型训练等场景中可靠且成熟。其弱点在于时效性不足。数据通常存在几分钟到几小时的延迟,一旦系统需要对当前发生的事件作出响应,这种延迟就会成为问题。
事件流随着事件发生持续移动数据,Apache Kafka 已成为该领域的事实标准。当交易完成或记录发生变化时,事件会被发布到流中,任何需要该数据的系统都可以独立消费,无需向源系统发起请求。由于其解耦、持久化和实时性特征,事件流已成为现代集成和智能体 AI 的基石。Apache Flink 则成为基于 Kafka 的有状态流处理的事实标准,覆盖实时转换、聚合以及 AI 增强的数据管道。
下方的数据集成格局图展示了三种范式中的主要厂商。实心气泡代表平台领导者;空心气泡代表专业厂商和新兴参与者。
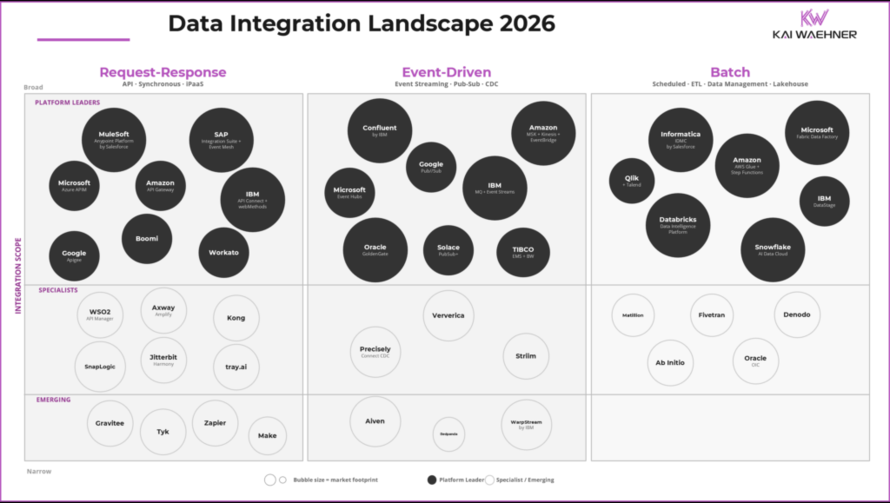
图注:Data Integration Landscape 2026 by Kai Waehner:厂商按三种通信范式(请求-响应、事件驱动、批处理)与集成范围进行映射,包括平台领导者、专业厂商和新兴参与者,如 Confluent、MuleSoft、Snowflake、Databricks、SAP、IBM 和 AWS。该图按范式分组,而非按排名。
为什么事件驱动架构应成为数据集成的核心?
这份格局图的核心观点很明确:事件驱动架构应处于中心位置,而请求-响应和批处理则作为其上层消费接口。
关键在于解耦。在事件驱动模型中,数据生产方无需知道谁在消费、何时消费、如何消费。生产者与消费者相互独立,因此某个系统响应缓慢或不可用时,不会阻塞与其相连的其他系统。该模式最常通过 Apache Kafka 等事件流平台实现,但 IBM MQ、Solace 等消息代理同样适用于事件驱动场景,尤其是在消息可靠投递和精细化路由比高吞吐流处理更重要的情况下。
大多数企业同时使用这三种范式,这是合理的。错误在于把它看作非此即彼的选择。运行 iPaaS 工作流的业务部门、拉取批量导出数据的分析团队,以及查询实时状态的 AI 智能体,都可以由同一个事件驱动骨干网络提供服务,而无需彼此耦合,也无需与底层系统强耦合。每种连接方式都各得其所:有些直接消费流,有些通过 API 网关访问,由网关将流暴露为端点,或将事件推送到 Webhook 或函数。
没有哪家大型企业只会运行单一集成平台。因此,真正的问题从来不是“该买哪个产品”,而是“哪种范式应处于核心”,以及其余部分如何与之连接,同时避免重新制造那些原本应被取代的复杂点对点链路。
完整市场格局按厂商逐一展开,详见:数据集成格局。
批处理集成已死吗?
没有。批处理仍然是历史数据回填、分析刷新、监管报告和 AI 模型训练的正确工具。变化在于,新的架构思考已经转移到流处理层。数据在这里被持续处理,并在合适的时间与上下文被消费,通常以实时方式完成。
从整体技术版图来看,批处理一栏并未出现大量新厂商,因为新进入者更多在构建流处理和变更数据捕获能力,而非传统定时流水线。批处理仍然存在,只是它不再是架构演进的核心。
哪些架构决策比供应商选择更重要?
整合浪潮表明,有三项决策的重要性超过了单纯选择供应商。
第一,三范式套件已成为新基准。主流平台厂商如今都在同一生态中覆盖全部三种范式。选择其中任何一家,越来越意味着在 API 管理、数据集成和事件流等领域全面投入该生态。这种锁定带来的退出成本,远高于替换单一产品。如果你正在做一项为期五年的平台决策,在比较功能清单之前,应先厘清每个候选方案分别覆盖了哪些范式。
第二,市场正走向事件驱动架构。Databricks 为其 Zerobus Ingest 服务增加了兼容 Kafka 的 API,现有 Kafka 生产者只需调整配置、无需修改代码,即可将数据直接流式写入 Databricks。Snowflake 也宣布推出自有兼容 Kafka 的服务 Datastream,目前已进入私有测试阶段。批处理 ETL 厂商正在增加变更数据捕获能力,iPaaS 厂商也在增强事件驱动能力。这一趋势是一致的:智能体和业务运营系统无法等待批处理周期。
第三,遗留系统集成对架构的影响,远大于供应商选择。同一供应商提供的 Zero-ETL 等快捷方案只能在单一生态内生效,但对 SAP iDoc 链路、大型机、EDIFACT 交换或医院 HL7 数据源往往无能为力。真正的企业架构多年来一直在边缘侧吸收各类遗留格式。对大多数企业而言,如果一个平台能无缝连接未来,却需要大量定制开发才能触及过去,那它并不是一个完整的平台。
数据集成如何与流程智能和智能体 AI 连接?
数据集成并非孤立存在。它是流程智能和可信智能体 AI 的基石。我认为这三层共同构成了现代数据架构的“三位一体”:
数据层:负责数据流动与数据治理;
流程智能:理解组织实际如何运行;
可信智能体 AI:基于前两层采取行动。
每一层都依赖其下层基础。
完整的厂商分析覆盖了三种范式中的平台领导者、专业厂商和新兴参与者,并进一步讨论了传统集成挑战、工业物联网,以及未来两年将塑造该领域的关键趋势。
如果你今年需要做出集成决策,《2026年数据集成格局》是一个很好的起点。请从范式出发,而不是从厂商列表出发。先明确哪些能力应放在架构核心,哪些只需放在边缘。一旦架构清晰,厂商选择就会容易得多。
原文链接: https://dzone.com/articles/data-integration-agentic-ai
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/31547898/viewspace-3186526/ ,如需转载,请注明出处,否则将追究法律责任。

