Oracle 支持一些独特的语法和函数,在移植到 MySQL 上时或多或少给程序员造成了困扰,下面我们针对 Oracle 的一些特殊用法举例并讲解如何用集算器来完成同样功能。这些方法当然也不限于针对 MySQL,对于所有其它数据库也能支持。
1、 递归语句
a) select employee_id,first_name,last_name,manager_id
from hr.employees
start with employee_id=102
connect by prior employee_id = manager_id
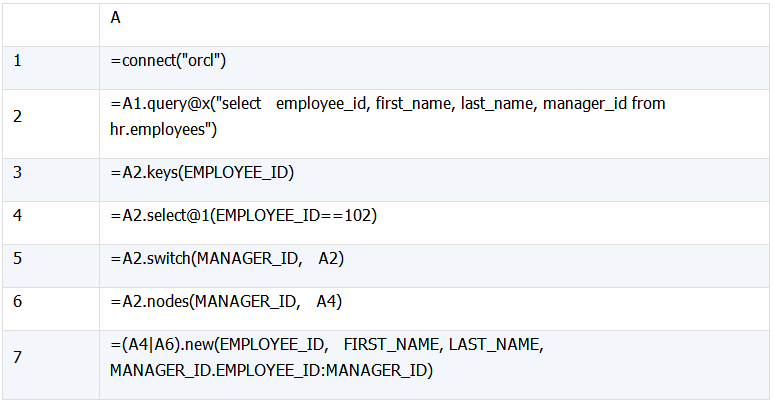
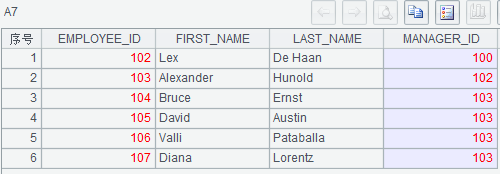
(1) A3 设置序表 A2 的键
(2) A4 选取起始雇员
(3) A5 将 A2 中 MANAGER_ID 值转换成记录,以便递归
(4) A6 获取起始雇员的所有子节点
b) select employee_id, first_name,last_name,manager_id
from hr.employees
start with employee_id=104
connect by prior manager_id = employee_id
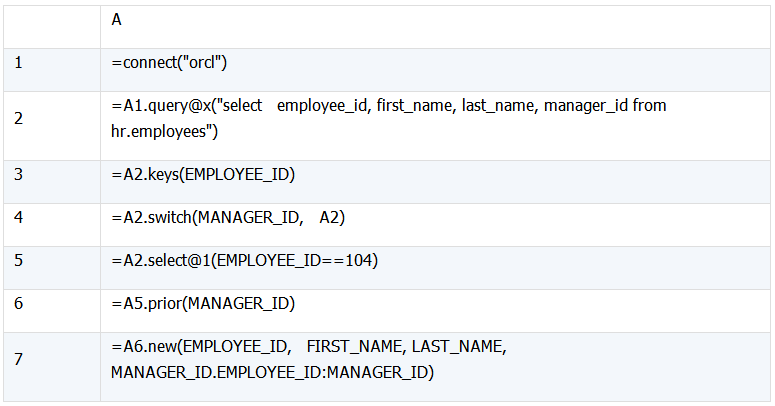
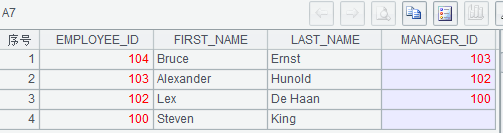
(1) A6 获取起始雇员的所有父节点
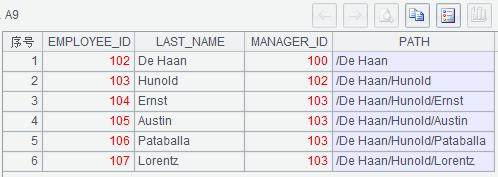
c) select employee_id,last_name,manager_id,sys_connect_by_path(last_name,'/') path from hr.employees
start with employee_id=102
connect by prior employee_id = manager_id
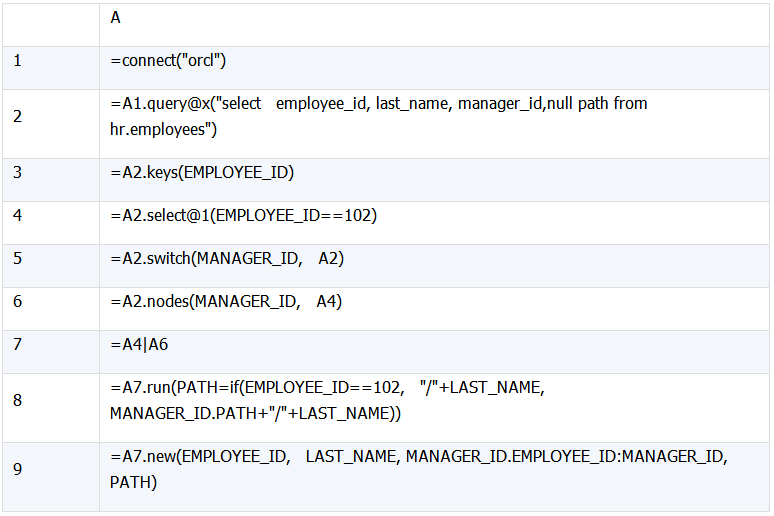
(1) 由于 A7 中每条记录的父节点都在本节点之前,故 A8 可以从前往后对 A7 中每条记录依次修改 PATH 值
2、 嵌套聚集函数
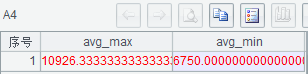
select avg(max(salary)) avg_max, avg(min(salary)) avg_min
from hr.employees
group by department_id
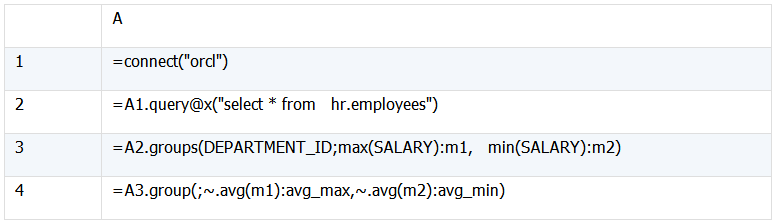
(1) A2 中 A1.query 也可以改用 A1.cursor
3、 聚集分析函数 FIRST 和 LAST
SELECT department_id,
MIN(salary) KEEP (DENSE_RANK FIRST ORDER BY commission_pct) worst,
MAX(salary) KEEP (DENSE_RANK LAST ORDER BY commission_pct) best
FROM hr.employees
GROUP BY department_id
ORDER BY department_id
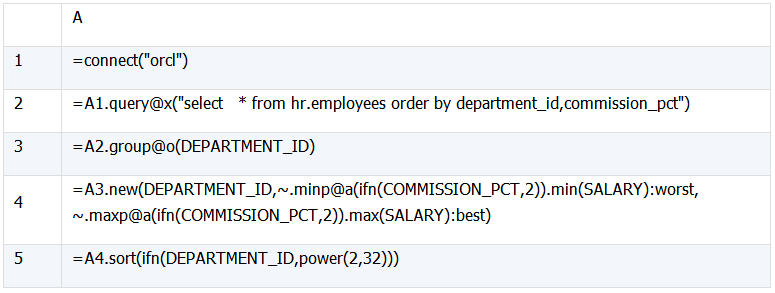
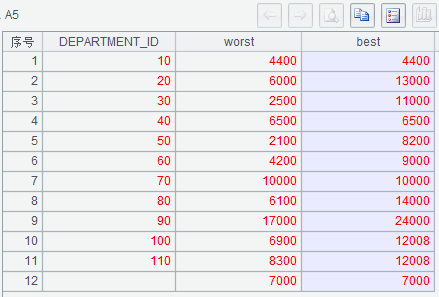
(1) A2 已按 DEPARTMENT_ID 排序,则 A3 分组时可采用 group@o
(2) FIRST/LAST 取排序的后第一组 / 最后一组,而 Oracle 排序时 null 排在最后,所以 LAST 会取到的最后一组就是 null 值所在组。maxp/minp 求具有最大值 / 最小值的所有行时排除了 null,所以在 A4 是用 ifn(COMMISSION_PCT,2) 保证 null 值时最大
(3) A5 中,DEPARTMENT_ID=null 时采用采用比所有 DEPARTMENT_ID 都大的 power(2,32) 来保证这一行排在最后
如果数据量大,还可以采用游标方式。
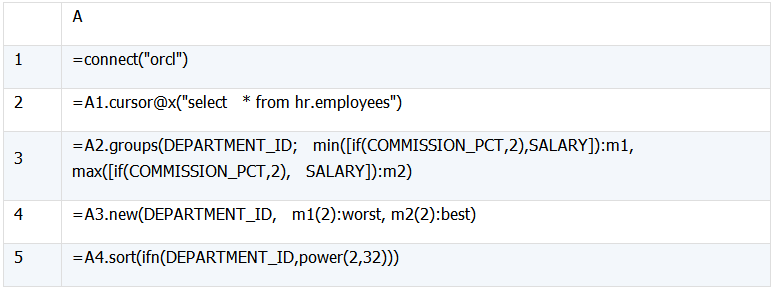
(1) A3 中,min([if(COMMISSION_PCT,2), SALARY]) 求出 COMMISSION_PCT 最小时的 SALARY 最小值,即 COMMISSION_PCT 排名第一时 SALARY 最小值,max 类似
4、 占比函数 ratio_to_report
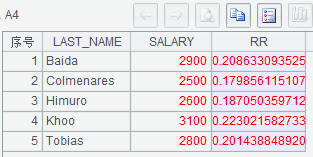
a) SELECT last_name, salary, RATIO_TO_REPORT(salary) OVER () AS rr
FROM hr.employees
WHERE job_id = 'PU_CLERK'
ORDER BY last_name
b) SELECT department_id,last_name, salary, RATIO_TO_REPORT(salary) OVER (partition by department_id) AS rr
FROM hr.employees
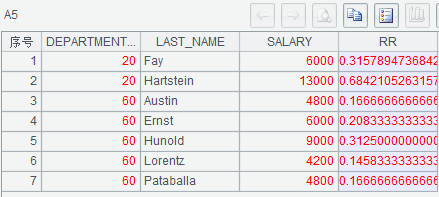
WHERE department_id in (20,60)
ORDER BY department_id,last_name
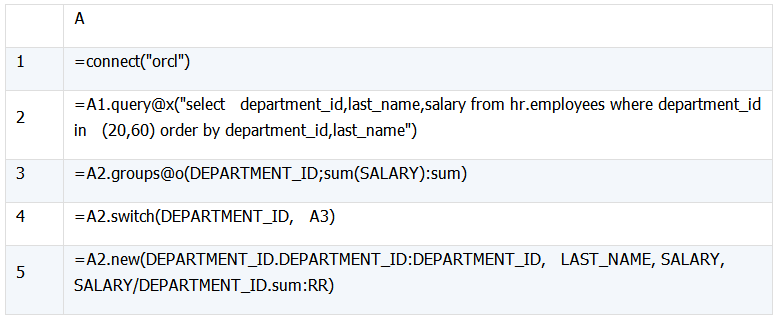
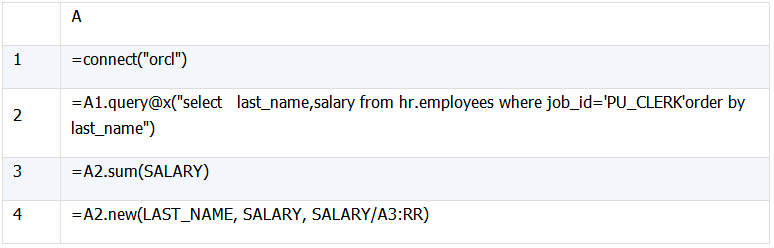
(1) A2 中已按 DEPARTMENT_ID 排序,则 A3 可用 groups@o 分组聚集
5、 多重分组
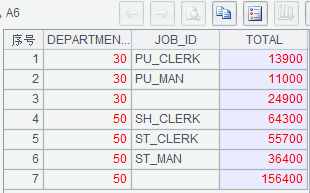
SELECT department_id, job_id, sum(salary) total
FROM hr.employees
WHERE department_id in (30, 50)
GROUP BY grouping sets((department_id, job_id), department_id)
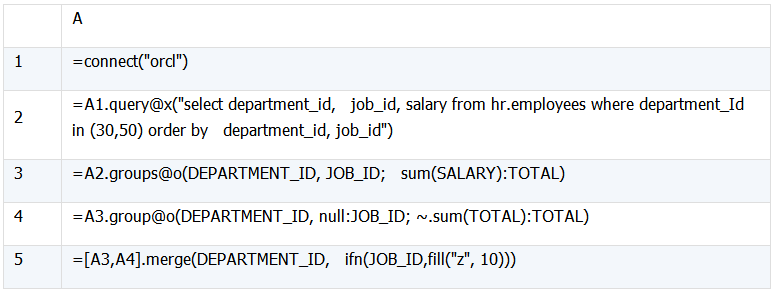
(1) 因为 A3 和 A4 均对 DEPARTMENT_ID 有序,故 A5 可 merge,ifn(JOB_ID,fill("z",10))) 用来保证 JOB_ID 为 null 排在后面
也可以采用游标方式。
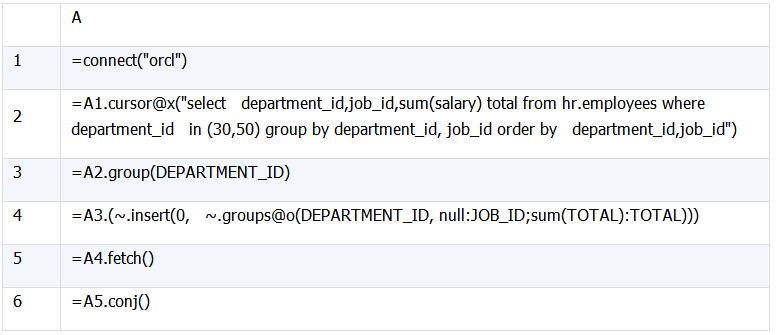
(1) A3 中 A2.group 要求 A2 对 DEPARTMENT_ID 有序
(2) A4 对 A3 每一组求和并将结果插入此组末尾
还可以采用管道方式。
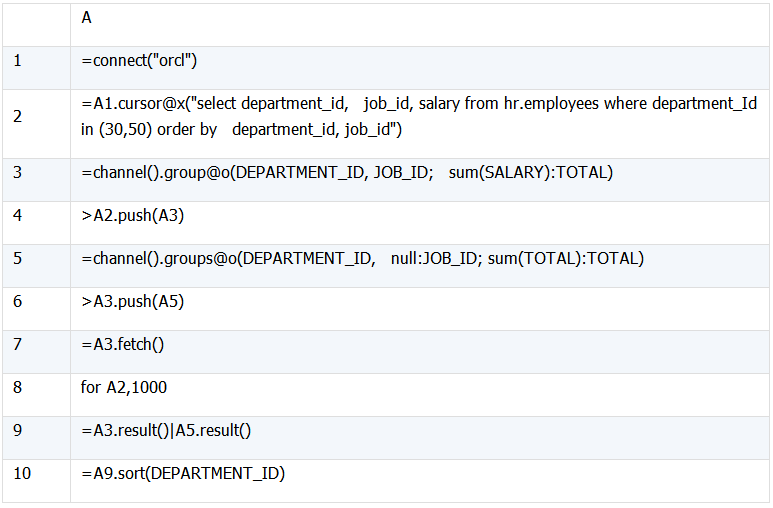
(1) A3 创建管道,并附加分组求和
(2) A4 将 A2 中数据推送到 A3,注意此动作只有在 A2 中数据有实际取出行为才执行
(3) A5 创建管道,并附加分组求和
(4) A6 将 A3 结果推送到 A5,此处也可以直接将 A2 中数据推送到 A5,但会增加时间复杂度
(5) A7 保留 A3 的数据
(6) 循环读取 A2,每次只取 1000 条,减少内存占用
(7) A10 对 A3 和 A5 中数据排序,因为算法是稳定的,所以 JOB_ID 为 null 的排在后面
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/31543054/viewspace-2218175/ ,如需转载,请注明出处,否则将追究法律责任。

