繁简转换
HanLP 几乎实现了所有我们需要的繁简转换方式,并且已经封装到了 HanLP 中,使得我们可以轻松的使用,而分词器中已经默认支持多种繁简格式或者混合。这里我们不再做过多描述。
· 说明
· HanLP 能够识别简繁分歧词,比如打印机 = 印表機。许多简繁转换工具不能区分“以后”“皇后”中的两个“后”字, HanLP 可以。
· 算法详解
· 《汉字转拼音与简繁转换的 Java 实现》


汉字转拼音
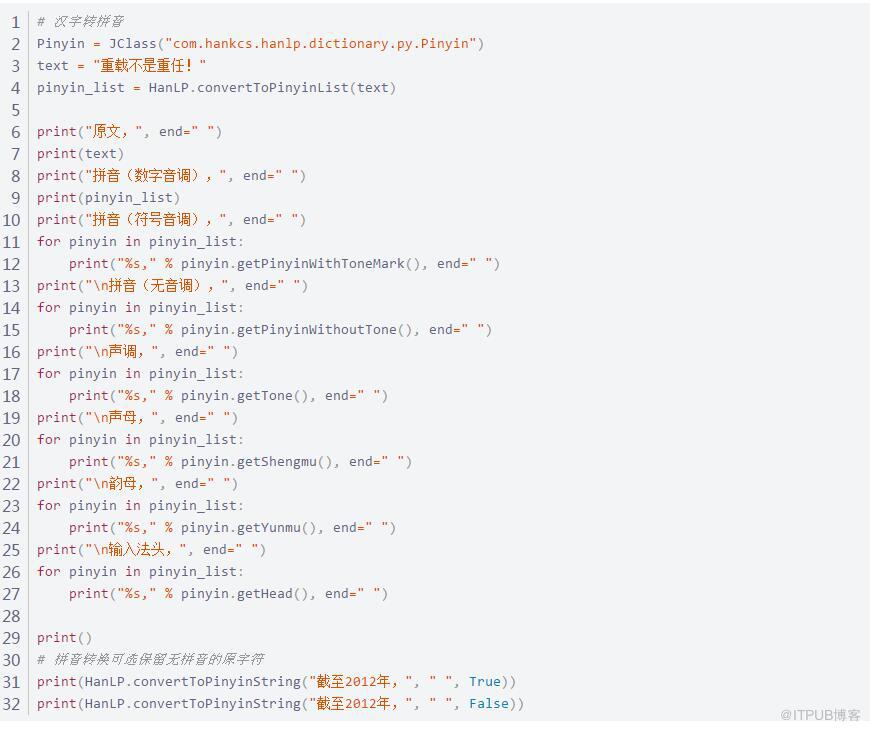
HanLP 中的汉字转拼音功能也十分的强大。
· 说明
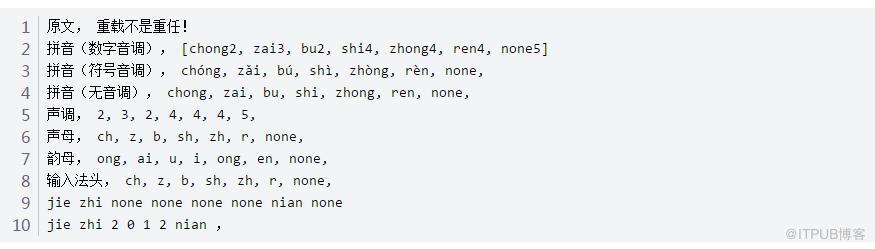
· HanLP 不仅支持基础的汉字转拼音,还支持声母、韵母、音调、音标和输入法首字母首声母功能。
· HanLP 能够识别多音字,也能给繁体中文注拼音。
· 最重要的是, HanLP 采用的模式匹配升级到 AhoCorasickDoubleArrayTrie ,性能大幅提升,能够提供毫秒级的响应速度!
· 算法详解
· 《汉字转拼音与简繁转换的 Java 实现》
拼音转中文
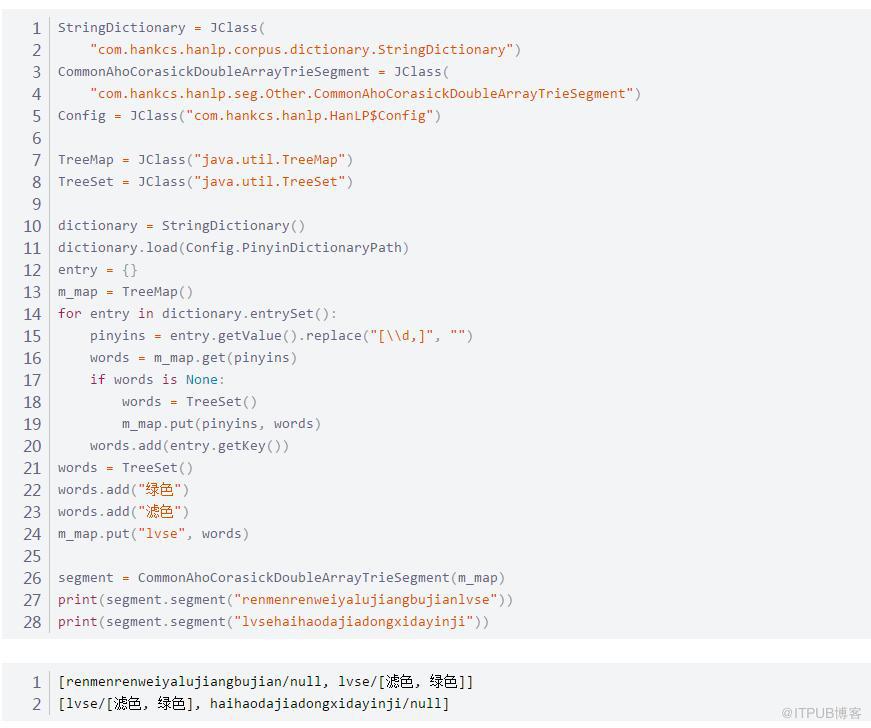
HanLP 中的数据结构和接口是灵活的,组合这些接口,可以自己创造新功能,我们可以使用 AhoCorasickDoubleArrayTrie 实现的最长分词器,需要用户调用 setTrie() 提供一个 AhoCorasickDoubleArrayTrie
字符正则化
演示正规化字符配置项的效果(繁体 -> 简体,全角 -> 半角,大写 -> 小写)。
该配置项位于 hanlp.properties 中,通过 Normalization=true 来开启(现在直接通过 HanLP.Config.Normalization 开启即可)。
切换配置后必须删除 CustomDictionary.txt.bin 缓存,否则只影响动态插入的新词。
在我动笔前一个星期,已经有同学添加了,添加自定义词典之后,自动删除缓存的功能。地址请点击 https://github.com/hankcs/HanLP/pull/954 ,现在只需要开启正则化即可
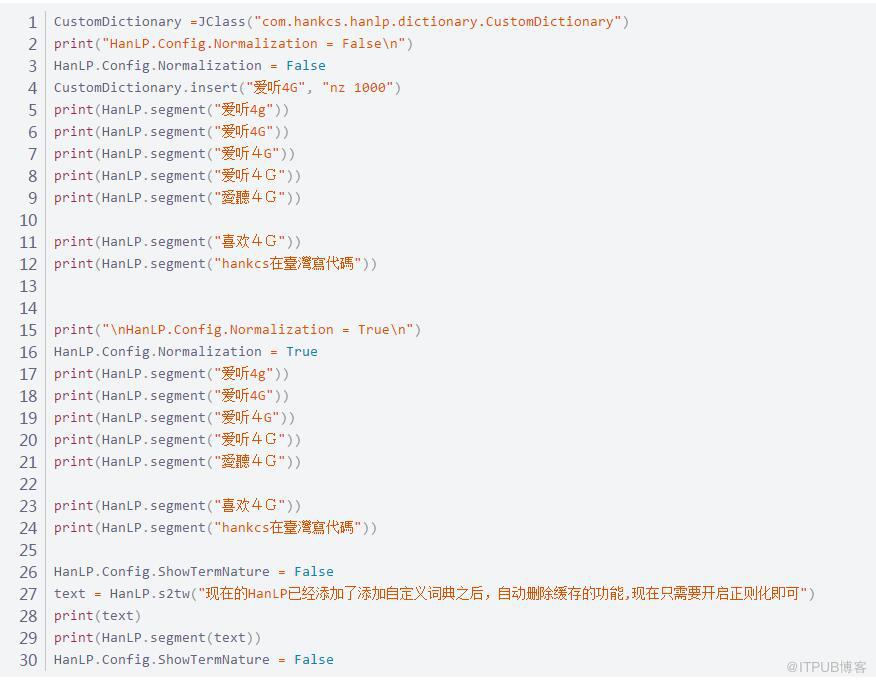
1| HanLP.Config.Normalization = False
2|
3| [ 爱听 4g]
4| [ 爱听 4G]
5| [ 爱 , 听 , 4 , G]
6| [ 爱 , 听 , 4 , G ]
7| [ 愛 , 聽 , 4 , G ]
8| [ 喜欢 , 4 , G ]
9| [hankcs, 在 , 臺 , 灣寫 , 代 , 碼 ]
10|
11| HanLP.Config.Normalization = True
12|
13| [ 爱听 4g]
14| [ 爱听 4g]
15| [ 爱听 4g]
16| [ 爱听 4g]
17| [ 爱听 4g]
18| [ 喜欢 , 4, g]
19 | [hankcs, 在 , 台湾 , 写 , 代码 ]
20| 現在的 HanLP 已經新增了新增自定義詞典之後,自動刪除快取的功能 , 現在只需要開啟正則化即可
21| [ 现在 , 的 , hanlp, 已经 , 新增 , 了 , 新增 , 自定义 , 词典 , 之后 , ,, 自动 , 删除 , 快 , 取 , 的 , 功能 , ,, 现在 , 只 , 需要 , 开启 , 正 , 则 , 化 , 即可 ]
---------------------
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/31524777/viewspace-3145478/ ,如需转载,请注明出处,否则将追究法律责任。

