Hanlp 中使用纯 JAVA 实现 CRF 分词
与基于隐马尔可夫模型的最短路径分词、 N- 最短路径分词相比,基于条件随机场( CRF )的分词对未登录词有更好的支持。本文( HanLP )使用纯 Java 实现 CRF 模型的读取与维特比后向解码,内部特征函数采用 双数组 Trie 树 (DoubleArrayTrie) 储存,得到了一个高性能的中文分词器。
开源项目
本文代码已集成到 HanLP 中开源: http://hanlp.com/
CRF 简介
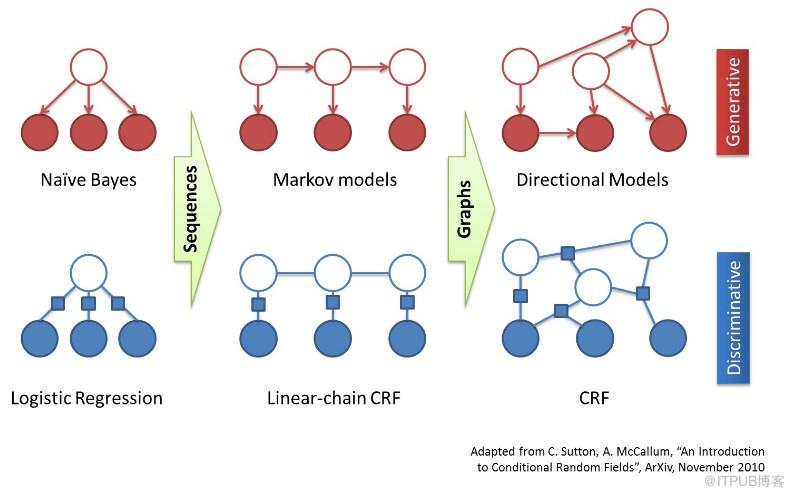
CRF 是序列标注场景中常用的模型,比 HMM 能利用更多的特征,比 MEMM 更能抵抗标记偏置的问题。
CRF 训练
这类耗时的任务,还是交给了用 C++ 实现的 CRF++ 。关于 CRF++ 输出的 CRF 模型,请参考《 CRF++ 模型格式说明》。
CRF 解码
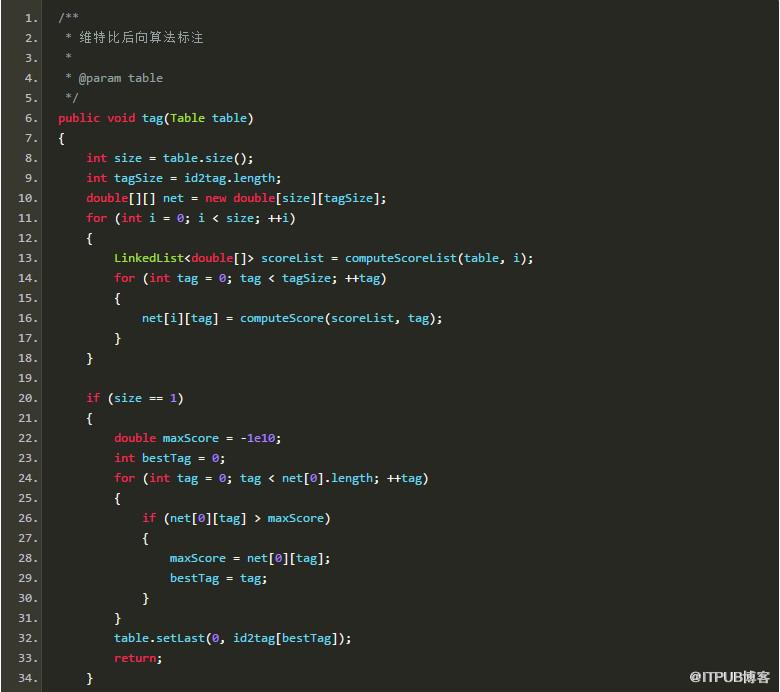
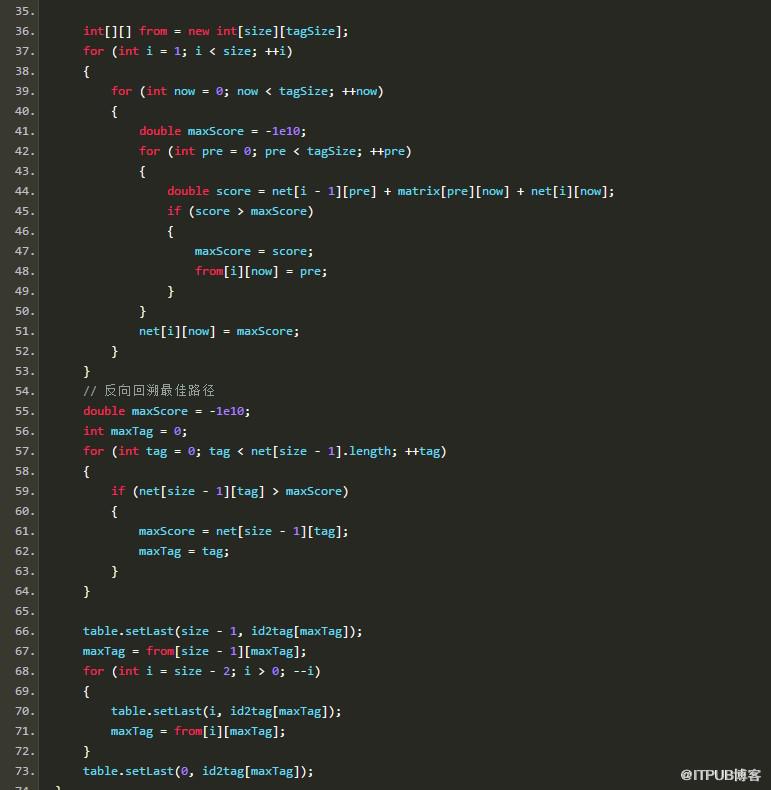
解码采用维特比算法实现。并且稍有改进,用中文伪码与白话描述如下:
首先任何字的标签不仅取决于它自己的参数,还取决于前一个字的标签。但是第一个字前面并没有字,何来标签?所以第一个字的处理稍有不同,假设第 个字的标签为 X ,遍历 X 计算第一个字的标签,取分数最大的那一个。
如何计算一个字的某个标签的分数呢?某个字根据 CRF 模型提供的模板生成了一系列特征函数,这些函数的输出值乘以该函数的权值最后求和得出了一个分数。该分数只是“点函数”的得分,还需加上“边函数”的得分。边函数在本分词模型中简化为 f(s',s) ,其中 s' 为前一个字的标签, s 为当前字的标签。于是该边函数就可以用一个 4*4 的矩阵描述,相当于 HMM 中的转移概率。
实现了评分函数后,从第二字开始即可运用维特比后向解码,为所有字打上 BEMS 标签。
实例
还是取经典的 “商品和服务”为例,首先 HanLP 的 CRFSegment 分词器将其拆分为一张表:
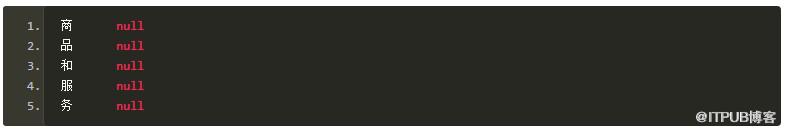
null 表示分词器还没有对该字标注。
代码
上面说了这么多,其实我的实现非常简练:
标注结果
标注后将 table 打印出来:
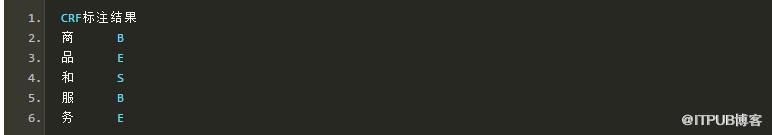
最终处理
将 BEMS 该合并的合并,得到:

然后将词语送到词典中查询一下,没查到的暂时当作 nx ,并记下位置(因为这是个新词,为了表示它的特殊性,最后词性设为 null ),再次使用维特比标注词性:

新词识别
CRF 对新词有很好的识别能力,比如:
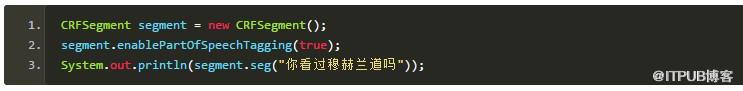
输出:
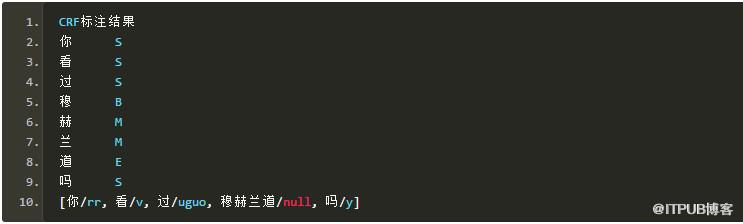
null表示新词。
转载自 hankcs的博客
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/31524777/viewspace-2216870/ ,如需转载,请注明出处,否则将追究法律责任。

