胖头鱼的技术专栏-474 从能跑到能上线:PG SplitJSON 0.2.0 和 0.1.0 差在哪
胖头鱼的技术专栏-474 从能跑到能上线:PG SplitJSON 0.2.0 和 0.1.0 差在哪(20261008)
作者:胖头鱼的鱼缸(尹海文)
Oracle ACE Pro: Database
PostgreSQL ACE
10年+数据库行业经验
拥有OCM 11g/12c/19c、MySQL 8.0 OCP、Exadata、CDP等认证
墨天轮MVP,ITPUB认证专家
圈内拥有“总监”称号,非著 名社恐(社交恐怖分子)
全网同名:胖头鱼的鱼缸
ITPUB:yhw1809
除授权转载并标明出处外,均为“非法”抄袭
在 《胖头鱼的技术专栏-473 改 JSON 的一个字段不再重写整篇:我给 PostgreSQL 18 写了个扩展(20261004)》中,我自己都有个疑问: 这玩意儿能上生产吗?
那篇文章里所有数字,即300 次更新、WAL 从 86,795,752 字节降到 64,144 字节,都是在一个全新独立实例上、单会话单事务跑出来的。
它证明的是"冷热分离这套机制到底能省多少",证明不了别的。回到头一篇, 《胖头鱼的技术专栏-468 JSON改一个字段,凭什么要重写整篇?(20260910)》讲的也是机制: 改一个字段为什么要重写整篇,以及各家为此付了多少钱。
而能不能上线是另一门课。
本期跟随总监,说说这两天我在干什么:
pg_splitjson 0.2.0。功能没加多少,补的全是"
能上线"这一课。
一、0.2.0 加的不是功能
冷热分离、专用更新 API、数组固定热槽、SELECT 自动查询改写、类型化业务列,这些 0.1.0 里就已经有了。
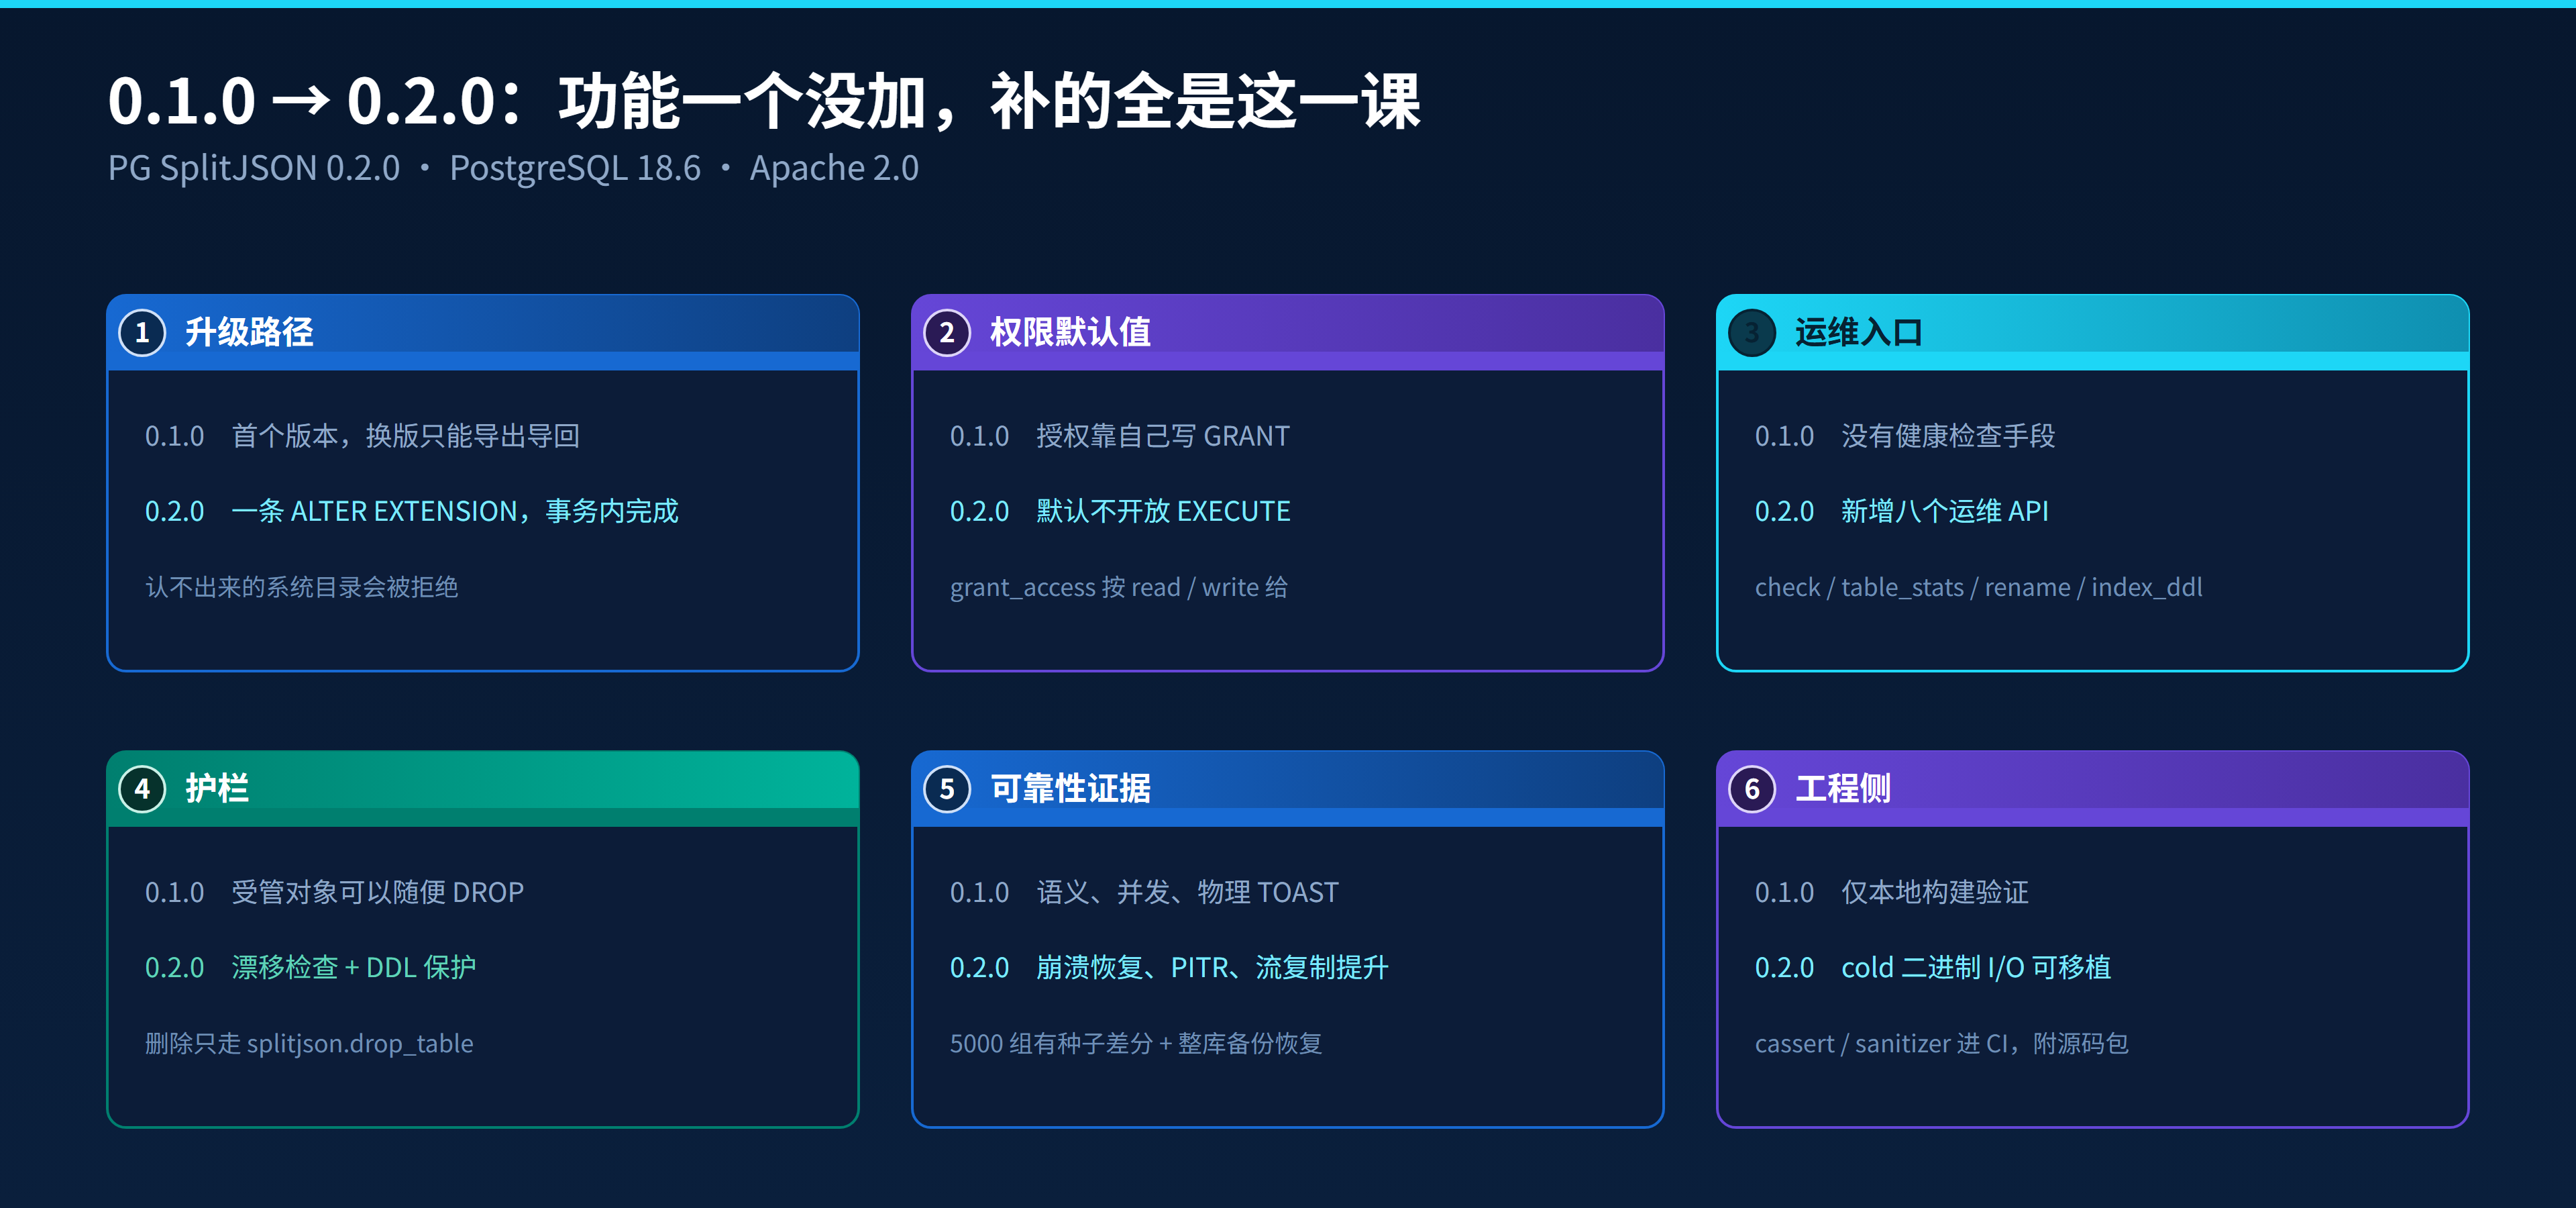
0.2.0 的功能清单没有新增,它干的是另一件事:把"我在自己机器上跑通了"补成"你在生产上敢装"。
具体来说是六块:
- 正式升级路径——0.1.0 到 0.2.0 有脚本了,不用导出再导回;
- 最小权限默认值——内部函数和管理函数不再对 PUBLIC 开放 EXECUTE;
- 运维入口——一致性检查、统计、受控重命名、可审阅索引 DDL 等八个新 API;
- 护栏——映射漂移检查,受管对象的 DDL 有人拦着了;
- 可靠性证据——崩溃恢复、PITR、流复制回放和提升、随机差分,全跑了一遍;
- 工程侧——cold 二进制 I/O 可移植、C 代码边界保护、cassert 和 sanitizer 构建进 CI。
二、如何进行升级
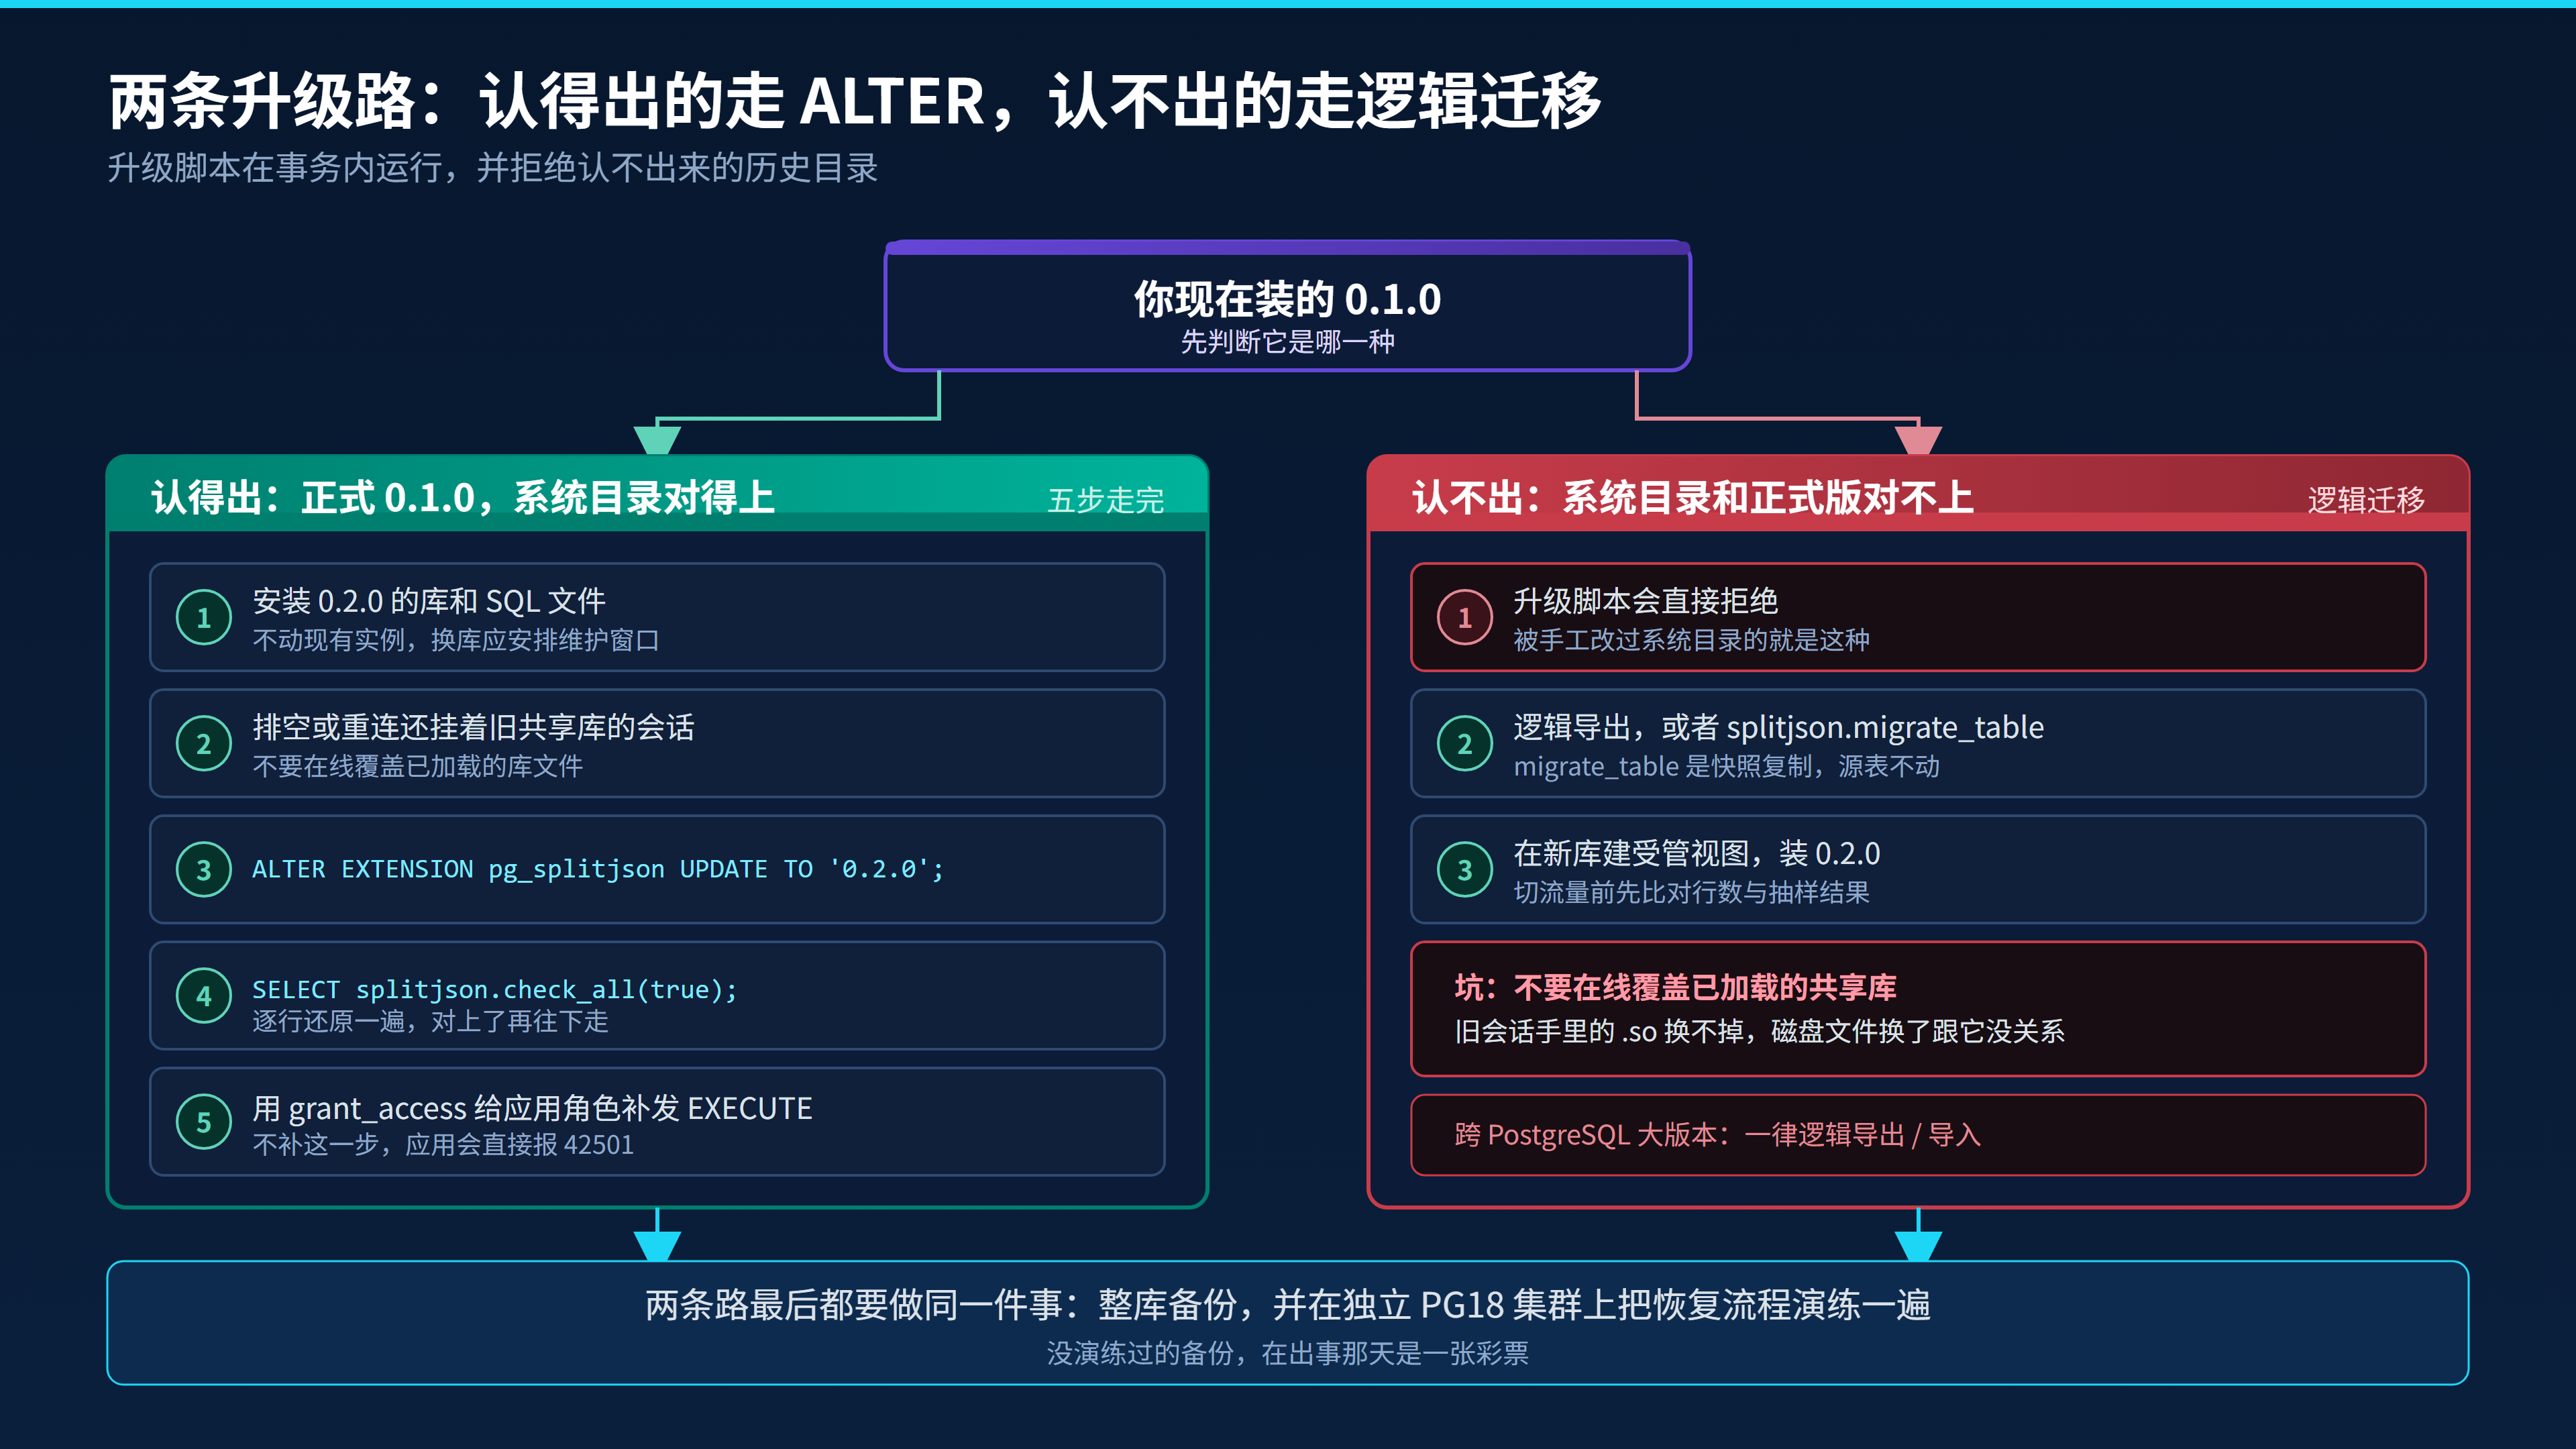
0.2.0 是第一个有"上一版"的版本,升级就是必需的功能:
ALTER EXTENSION pg_splitjson UPDATE TO '0.2.0';
SELECT splitjson.check_all(true);
升级在事务内完成,中途失败整体回滚。认不出来的目录脚本会直接拒绝,那种情况只能逻辑迁移—— 不要在线覆盖已加载的库文件,旧会话手里的 .so 换不掉。
升级完还有一步容易漏:0.2.0 收紧了默认权限,不给应用角色补发
grant_access,应用会直接报
42501。
三、权限变化
0.1.0 的授权方式是自己写 GRANT,给不给、给多少,全凭自觉。
0.2.0 反过来: 内部函数和管理函数默认不对 PUBLIC 开放 EXECUTE,响应权限需要显式授予。
-- read 或 write 两种模式
SELECT splitjson.grant_access('public.events','app_role','write');
它给的是"够用"那一档——业务视图的读写权限,加上这个模式必需的几个读写 API,
不给
splitjson_storage,也不给
splitjson._tables。
顺带把权限检查也补全了:
- 更新函数验证调用角色对视图
doc列的 UPDATE 权限, SET ROLE 和 SESSION AUTHORIZATION 也算数; - 读取函数检查 id/doc 的 SELECT 权限;
- 受管删除要求拥有视图。
建表、迁移、索引管理、计划检查这些,仍然只有扩展安装者能做。
四、八个运维入口
上次那篇文章里我列边界时写过"还有几项没测",其实 连"怎么知道它还健康"都没给。0.2.0 补上了:
| API | 干什么 |
|---|---|
grant_access |
按 read/write 授予最小权限 |
check_table |
校验单个受管映射,第二参数 true 时逐行还原 |
check_all |
校验所有受管映射,同样可选逐行还原 |
table_stats |
返回内部表的 PG 统计和关系大小 |
rename_table |
在业务 schema 内改受管视图名 |
set_business_default |
给业务列设默认值 |
set_business_not_null |
给业务列开关 NOT NULL |
add_field_check |
按热路径加字段类型检查,可设 required |
冷热分离之后,监控对象变成两张表了——业务视图只是个壳,真占地方的是
splitjson_storage 里那个内部 heap 表,
table_stats 看的就是它。
不看它,vacuum 和膨胀就全靠猜。
返回的是 JSONB:
SELECT splitjson.table_stats('public.orders');
SELECT * FROM splitjson.check_all(true);   -- 所有受管映射,逐行还原
check_all(true) 那个 true 是"要不要真去把每一行还原一遍"——
不传就是只校验映射结构,传了才验数据。数据量大的表,这个 true 是要花时间的,别放在业务高峰跑。
index_ddl
不替你建索引,只把 CREATE INDEX 的 SQL 吐给你先看一眼:
SELECT splitjson.index_ddl('public.orders','orders_state_idx','["state"]','text');
拿到的是文本,你在事务外自己执行(建议 CONCURRENTLY),完了记得查一下有没有 invalid index。
扩展不替你在生产库上执行 DDL。
五、漂移检查和受管 DDL
0.1.0 里有个隐患: 你直接去 DROP 或者 RENAME 那个受管视图,没人拦你。拦不住的后果是元数据里的映射和真实的存储表对不上号,视图没了、内部表还在,或者反过来。
0.2.0 加了两道:
-
映射漂移检查——元数据里声明的热路径和实际存储布局不一致就报出来,
check_table/check_all都走这一步; -
数据库级 DDL 保护——受管视图和存储表不许直接 DROP/RENAME,要删走
splitjson.drop_table(视图、内部表、映射一起清,事务内完成)。
这两道护栏不产生任何性能收益。但没有它们,前面那些数字就是纸糊的—— 一次误 DROP,映射和真实存储就对不上号,还得手工收拾。
六、能扛住什么:崩溃、PITR、流复制、备份
在独立的 PG18.6 集群上跑通的:
| 项目 | 结果 |
|---|---|
| 立即崩溃恢复 | 已提交的热/冷值和业务行都在,未提交的消失 |
| 命名恢复点 PITR | 在目标点之前停住,状态符合预期 |
| 流复制备库回放 | 通过 |
| 备库提升 | 提升后继续接受热字段更新 |
| 整库备份恢复 |
pg_dump -Fc /
pg_restore 保留 API、类型化列和权限 |
| 随机差分 | 5000 组有种子 JSONB 操作全部通过 |
物理恢复这条有硬前提:主库、备库、备份和恢复目标必须是
相同的 PostgreSQL minor 版本和 ABI,而且目标实例得装好对应的
pg_splitjson 库和 SQL 文件。
跨大版本没有捷径,走逻辑导出/导入,或者
migrate_table。
还有一个容易翻车的点:
往新库
pg_restore 必须按文档规定的
session_replication_role=replica 流程走,恢复完再跑一次
check_all(true),确认了才放流量进来。
恢复之后固定三步,顺序别乱:
- 按 dump 顺序走完
session_replication_role=replica的恢复流程; -
SELECT splitjson.check_all(true);; - 比对业务视图的抽样结果,确认了再放流量。
实测支持范围就是 Linux x86_64 上的 PostgreSQL 18.6,别的平台得自己构建、自己验证。
七、新的性能指标
上篇文章那组数字是"单会话、单事务、300 次更新",本质上是机制展示。
0.2.0 换成了有界负载:
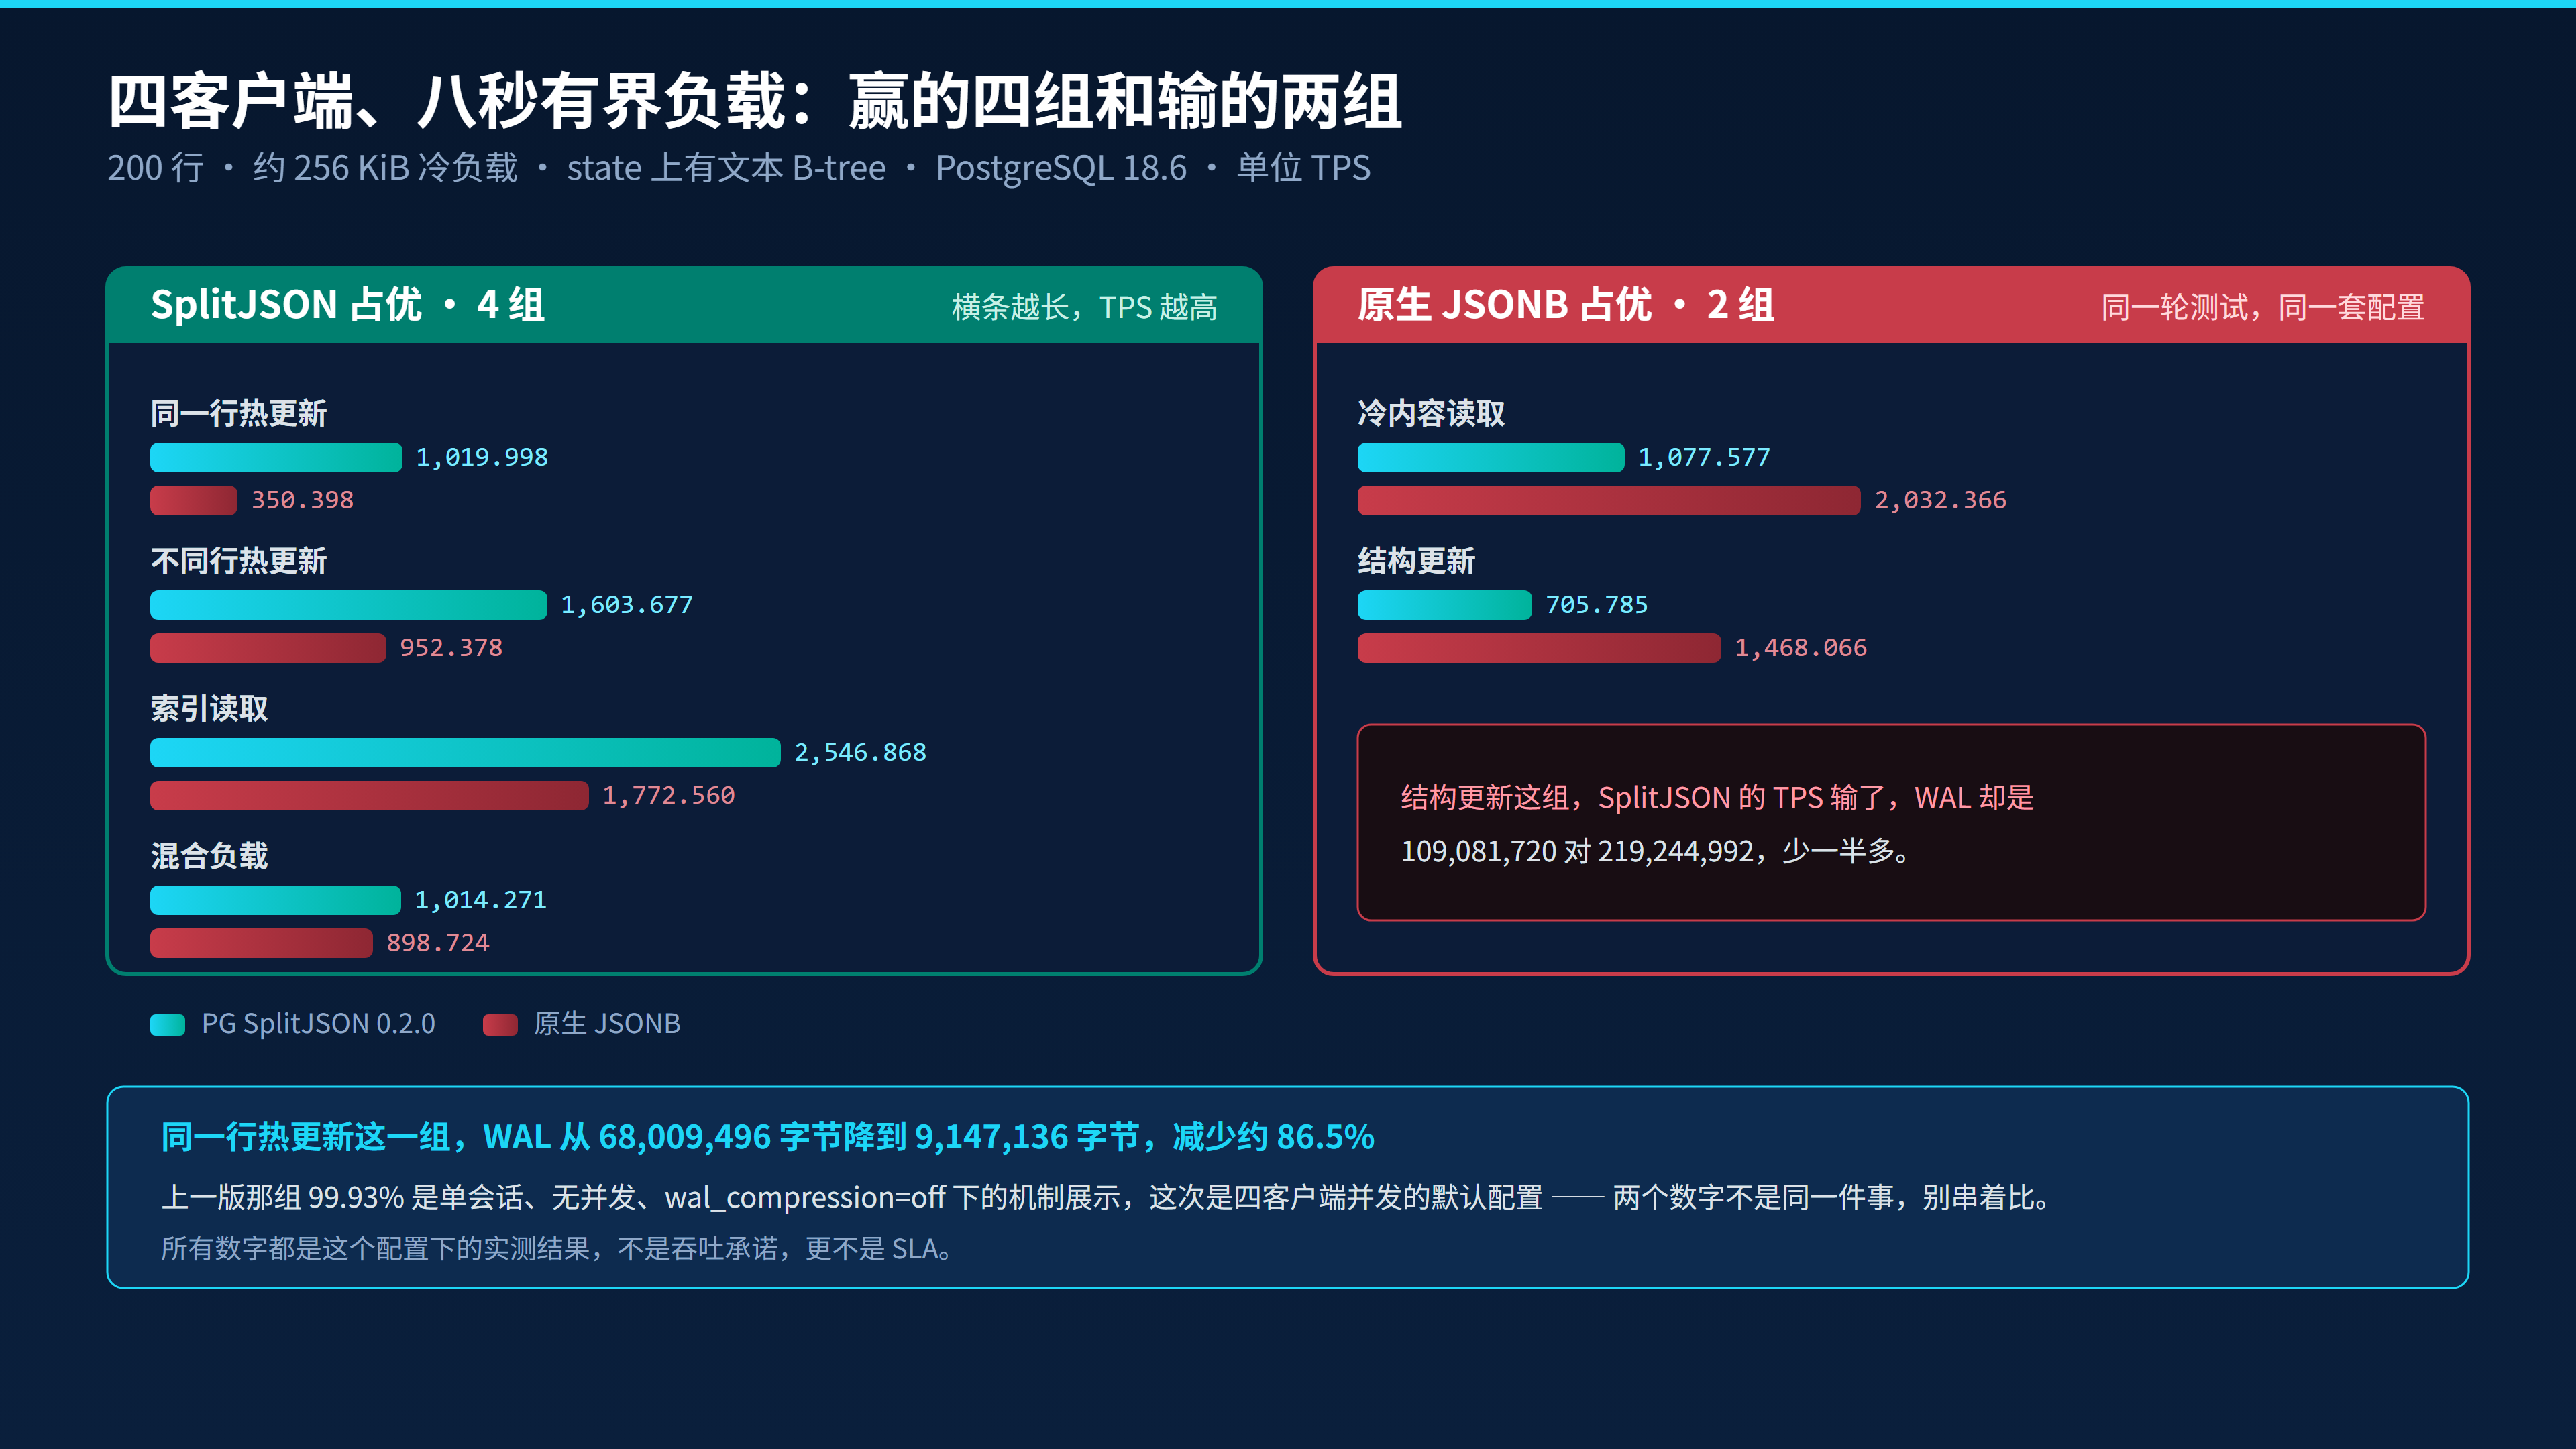
200 行数据、约 256 KiB 冷负载、四个 pgbench 客户端、每组八秒,
state 上建了文本 B-tree。
| 场景 | SplitJSON TPS | 原生 TPS | SplitJSON WAL(字节) | 原生 WAL(字节) |
|---|---|---|---|---|
| 同一行热更新 | 1,019.998 | 350.398 | 9,147,136 | 68,009,496 |
| 不同行热更新 | 1,603.677 | 952.378 | 16,327,648 | 280,014,456 |
| 索引读取 | 2,546.868 | 1,772.560 | 25,411,592 | 90,761,832 |
| 混合负载 | 1,014.271 | 898.724 | 17,873,592 | 137,084,872 |
同一行那个场景,WAL 减少约 86.5%。
两组口径别串着比:上次是 99.93%(单会话、无并发、
wal_compression=off),这次是 86.5%(四客户端并发、默认配置)。
八、输掉的两组
同一轮测试里,有两个场景 SplitJSON 是输的:
| 场景 | SplitJSON TPS | 原生 TPS | SplitJSON WAL(字节) | 原生 WAL(字节) |
|---|---|---|---|---|
| 冷内容读取 | 1,077.577 | 2,032.366 | 18,249,096 | 32,521,056 |
| 结构更新 | 705.785 | 1,468.066 | 109,081,720 | 219,244,992 |
冷读输了,一点都不意外——读完整文档要把冷模板和所有热列拼起来,原生 JSONB 读冷文档就是直接读,中间多一道工序。
结构更新输得更明显:改到结构(热子树外的位移、父替换、首 次创建缺失热槽)会触发一次重新打包,冷模板重新存储、热值和索引同步更新,这些活一件都少不了。
说白了,这个扩展的收益是有前提的: 冷内容大、热字段小、更新频繁、整篇读取不频繁、结构不常变。反过来用,就是给自己加活。
测试收尾执行了
VACUUM (ANALYZE)、
REINDEX、
check_all(true),维护后死元组为零。
这是短时观察,不代表长期膨胀结论,长期不膨胀还需要后续测试并验证结果。
九、没变的边界
0.2.0 是完善版,不是全能版。这些依然是"不做":
| 领域 | 状态 |
|---|---|
| RLS | 不支持 |
| 分区受管视图/表 | 不支持 |
视图
ON CONFLICT |
不支持 |
| 自动逻辑复制重组 | 不支持 |
| 完全 ORM 透明 | 不做 |
| 热路径动态修改 | 建表时声明,要换就
migrate_table 重建 |
运行期还有三条:
- 热索引列变化可能阻止 HOT——冷 TOAST 还能复用,但 HOT 没了;
-
只导出业务视图的
pg_dump -t不包含内部存储依赖,备份必须整库; - MVCC 照旧生成新的 heap tuple——省掉的是"大冷值被反复重写",不是"写"。
十、怎么用
| 你现在的情况 | 怎么办 |
|---|---|
| 还没装过 | 直接装 0.2.0,
CREATE EXTENSION 就行 |
| 装了正式 0.1.0,没动过内部结构 | 装库 → 排空会话 → ALTER →
check_all(true) →
grant_access 补授权 |
| 0.1.0 上手工改过内部表或布局 | 别升,新建受管关系 + 逻辑迁移 |
| 系统目录对不上,升级脚本拒绝 | 逻辑导出到新建的受管视图,或
migrate_table |
| 想跨 PostgreSQL 大版本 | 逻辑导出/导入 |
升之前两件事:整库备份,以及在 独立的 PG18 集群上把恢复流程演练一遍。
总结
回到开头那个问题: 这东西能上生产吗?
0.1.0 我的答案是"先在测试环境跑"。0.2.0 的答案往前挪了一格: 机制没变,但升级、权限、运维、护栏、恢复证据这几件事补齐了,可以在受控的场合上。
- 0.1.0 回答"能不能省",0.2.0 回答"敢不敢装";
- 加了正式升级路径和八个运维入口,收紧了默认权限,给受管对象加了护栏;
- 崩溃恢复、PITR、流复制提升、5000 组差分都过了,同一行热更新在四客户端八秒的有界负载下 WAL 减少约 86.5%—— 同时冷读和结构更新是输给原生 JSONB 的。
边界还是那些边界:RLS、分区、视图 UPSERT、逻辑复制重组不做,热路径建表定死,跨大版本走逻辑迁移。
项目地址: https://github.com/Haiwen-Yin/pg_splitjson ,Apache 2.0,PG18 可编译。
众所周知,写扩展最花时间的从来不是那个核心机制,而是机制之外那一圈——升级、权限、检查、恢复,全是没人看的活儿。
老规矩,知道写了些啥。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/31466763/viewspace-3184554/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- 胖头鱼的技术专栏-485 数据库把 AI 装进内核之后(20261104)
- 胖头鱼的技术专栏-484 一个数据库大版本,凭什么要熬七年?(20261029)
- 胖头鱼的技术专栏-483 索引里也掺了水分(20261028)
- 胖头鱼的技术专栏-482 Oracle AI DB 23.26.4新特性一览(20261027)
- 胖头鱼的技术专栏-481 MySQL 替代怎么选?聊聊 OceanBase 集中式的五个优势
- 胖头鱼的技术专栏-480 交付和运维不是低价值岗位,离客户最近的人才懂业务
- 胖头鱼的技术专栏-479 如何高效地将喂给 AI 的数据搬过去(20261015)
- 胖头鱼的技术专栏-478 Agent 成了新用户,数据库要接住它的下一步(20261014)
- 胖头鱼的技术专栏-477 26ai新特性实战:表达式分区(20261013)
- 胖头鱼的技术专栏-476 26ai新特性实战:聚合过滤(20261012)
