胖头鱼的技术专栏-464 是什么让数据库国产化迁移"进可攻,退可守"(20260826)
作者:胖头鱼的鱼缸(尹海文)
Oracle ACE Pro: Database
PostgreSQL ACE
10年+数据库行业经验
拥有OCM 11g/12c/19c、MySQL 8.0 OCP、Exadata、CDP等认证
墨天轮MVP,ITPUB认证专家
圈内拥有“总监”称号,非著 名社恐(社交恐怖分子)
全网同名:胖头鱼的鱼缸
ITPUB:yhw1809
除授权转载并标明出处外,均为“非法”抄袭
这几年聊国产化替代,我听得最多的一句话,不是"性能行不行",也不是"兼容性够不够"—— "切换那晚,睡不着怎么办?"
做数据库这行的都懂。选型可以慢慢比,POC 可以反复测,但切换那一下是"一次性动作":存量几十甚至上百 TB 怎么搬、搬迁期间新产生的数据怎么追平、搬完出了问题怎么回退——全部要压在有限的停机窗口里完成。窗口就那么几个小时甚至不到一小时,全组 DBA 熬夜待命,回退预案贴在墙上,说白了就是一场不允许失败的外科手术。
这个问题也不是国产化时代才有的。Oracle 时代做大版本升级、跨平台搬迁,靠的就是 OGG(Oracle GoldenGate)、XTTS 这类数据同步工具:先把存量搬过去,再实时追增量,最后挑个业务低峰切换,停机窗口从按天算变成按分钟算。
国产化替代要复刻这套打法,工具总得是国产的。金仓数据库的这个产品叫 KFS,全称 Kingbase FlySync,金仓异构数据同步软件。
这篇文章就来拆一拆 KFS:它是什么,怎么实现的,在国产化替代里能顶上哪些环节。
一、KFS 是个什么:异构数据库之间的搬家公司
先给定位: KFS 是中电科金仓推出的异构数据同步软件,对标的就是 OGG 这一档的产品——基于数据库日志解析技术,在异构数据平台之间做实时、增量的数据同步。
它面向的场景,官方列了一串:
- 同城/异地容灾备份;
- 数据库平滑迁移/升级(国产化替代的主战场);
- 数据集中 共享与分发(打破数据孤岛);
- 应用上云迁移;
- 数据库负载均衡。
这些场景看着杂,共同点就一个:业务不能停,数据得在两套系统之间持续流转。
打个比方:数据库是数据的"家",KFS 干的就是搬家公司的活——把家当从老房子搬进新房是本职;两套房之间保持物品实时同步、按需把一家的东西分给好几户人家,算增值服务。后两样后面细说。
几个我认为值得关注的点:
- 数据源覆盖面广——源端支持 Oracle、SQL Server、MySQL/MariaDB、DB2、PostgreSQL、Informix 这些国外主流库,也支持达梦、OceanBase、openGauss、Vastbase、TDSQL 等一众国产库;目标端在此基础上,还覆盖 Greenplum、ClickHouse、Kafka、Hive、Elasticsearch、MongoDB 这些分析类和大数据类目标。官方口径是 30 余种数据源,且仍在扩充;
- 低侵扰——不依赖数据库提供的增量接口(比如 Oracle Logminer、SQL Server CDC),而是直接解析物理日志,解析、缓存、排序这些重活全部在 KFS 侧完成,对生产库的 CPU/内存占用极低。这一点后面细说;
- 事务级一致性——同步过程保持事务的提交顺序和 ACID 属性,不是"数据大概齐";
- 校验修复内置——数据同步的同时能做一致性校验、自动修复,不用另买工具;
- 安全合规——产品代码自主率 100%,数据存储与传输支持国密算法加密。
二、怎么实现的:采集、KUFL、加载三段式
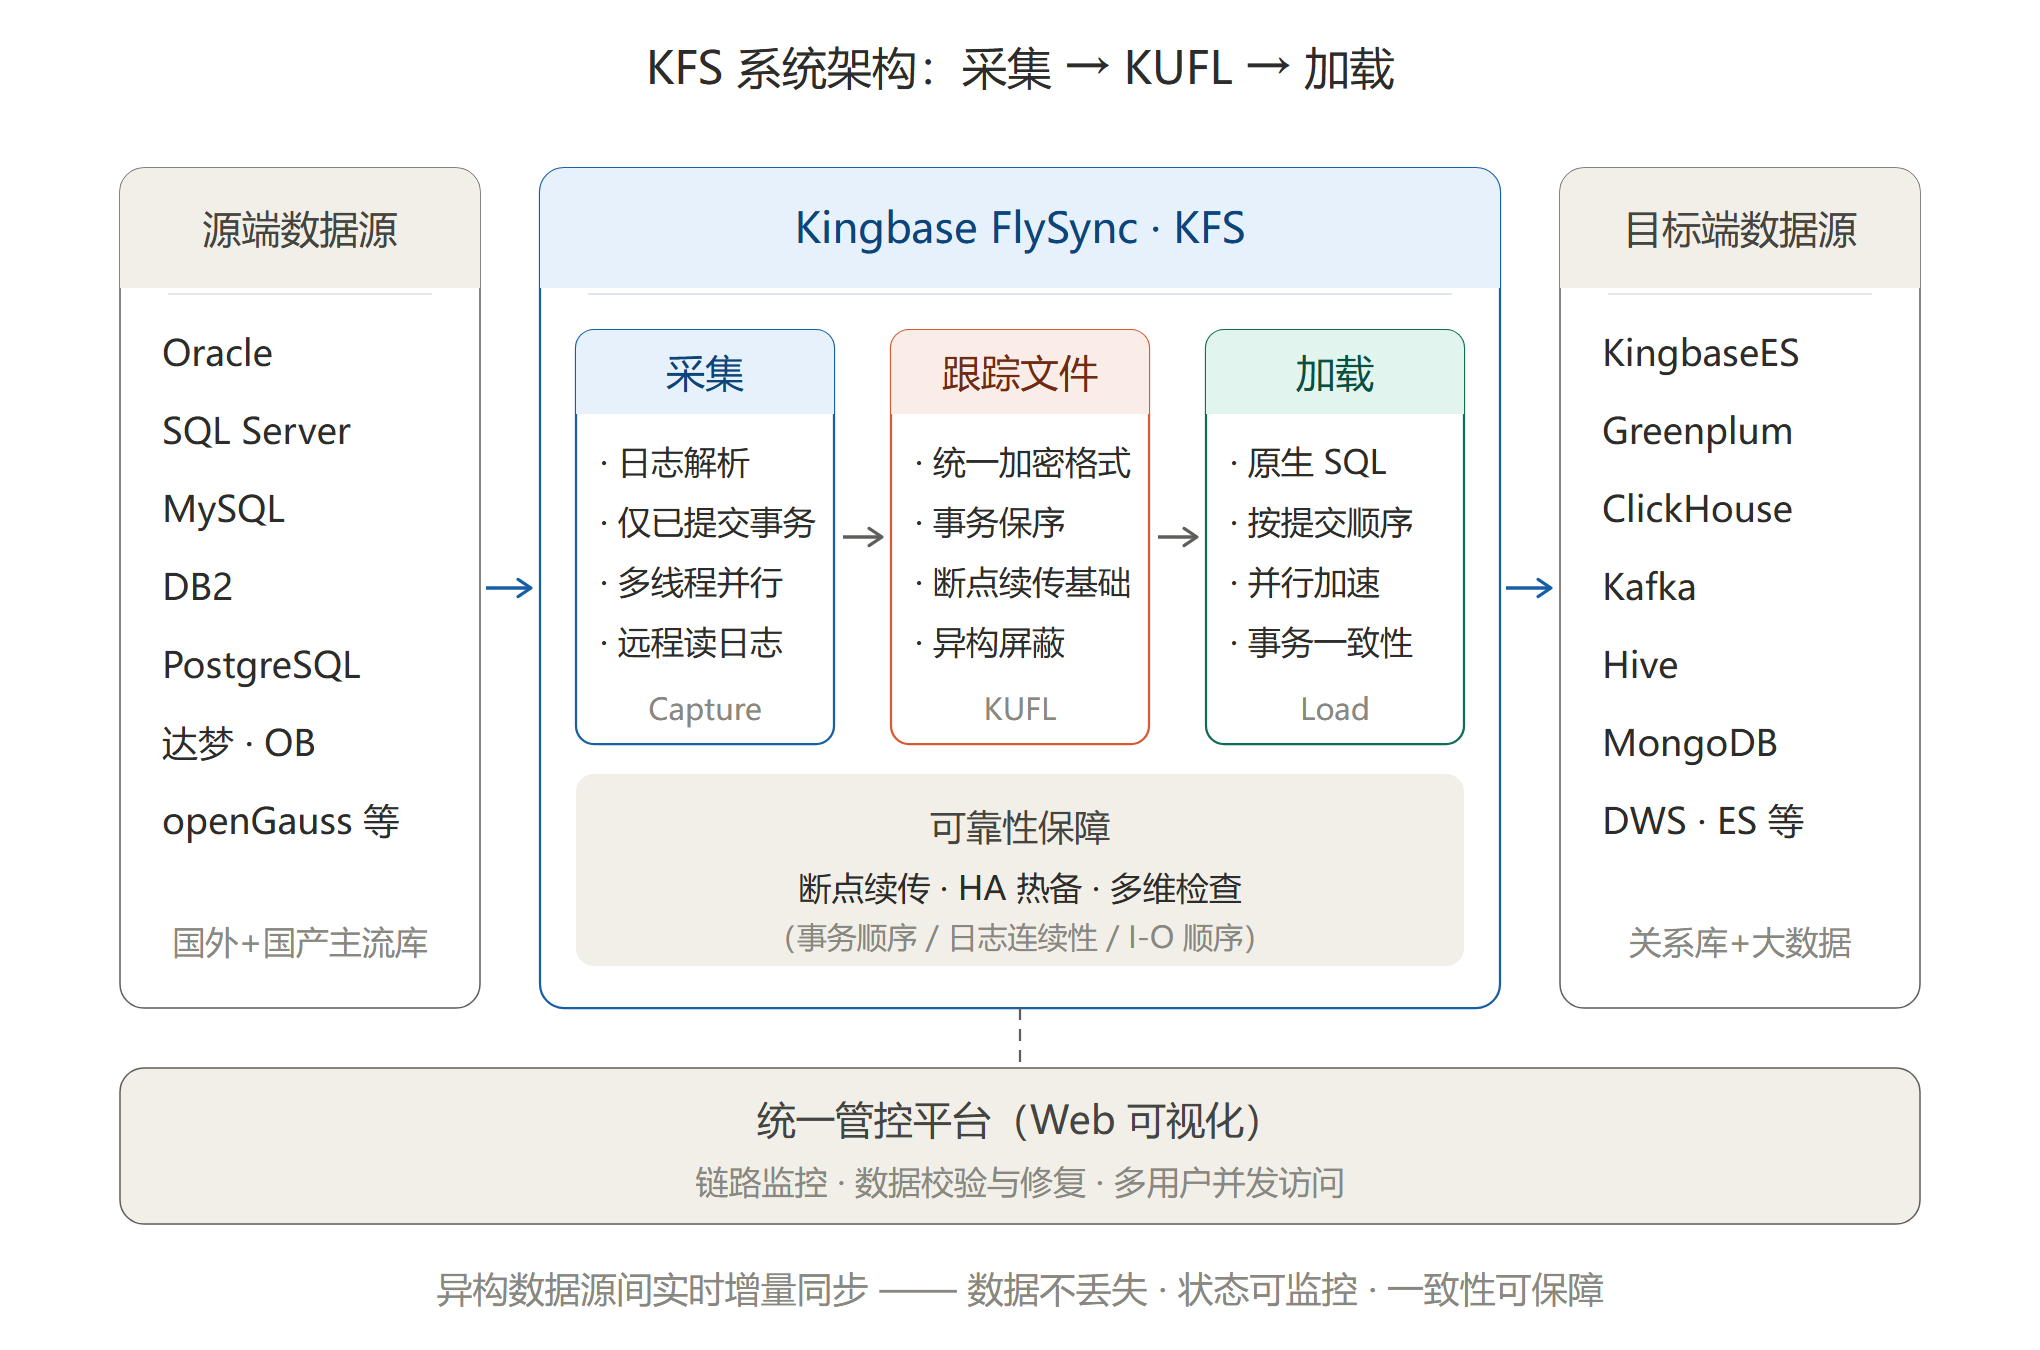
KFS 的技术架构,扒开看是三段式: 采集 → 跟踪文件(KUFL)→ 加载。
(用过 OGG 的朋友看到这里应该眼熟——Extract、Trail File、Replicat,路数基本一样。对老 DBA 来说学习成本很低,这也是官方敢讲"0 难度上手"的底气。)
第一段:采集。
采集模块部署在源端,直接访问数据库的事务日志(REDO)做实时解析,读取所有增、删、改操作。两个细节值得说:
- 只解析已提交的事务——未提交的中间活动和回滚操作直接忽略,既减少负载,也避免把"脏数据"同步出去;
- 解析本身并行化——多线程并发解析多路日志,应对高吞吐场景。
这里有个关键设计。传统方案里,日志解析、缓存、排序这些计算发生在生产库所在主机上(用 Logminer 就得在库内跑查询),高负载场景下对业务影响明显。KFS 把这一整套计算 搬到了自己的节点上——生产库只负责"交出日志",连归档日志都可以远程读取。官方给过一组数:KFS 采集进程单核 CPU 占用 70% 以内、内存 2GB 以内,就能扛住每天数百 GB 的增量。
第二段:KUFL 跟踪文件。
KUFL(Kingbase Unified Format Log)是 KFS 的中间枢纽——把从不同数据库解析出来的数据操作,统一成一种加密格式存储的中间文件。
可以把它理解成搬家过程中的 装箱单加中转仓:不管源端是 Oracle 还是 MySQL,进来都打包装箱、贴上统一标签,箱子上记着最关键的信息——事务的提交顺序。这个设计带来三件事:
- 异构屏蔽——下游加载时不用关心源端是什么库;
- 断点续传——网络中断、进程挂掉,KUFL 里保留着到中断那一刻的最新数据,恢复后从断点接着传,不用重来;
- 事务保序——每笔事务在源端的提交顺序被完整记录,目标端严格按这个顺序加载。
第三段:加载。
加载模块从 KUFL 读出变更,转换成目标库的原生 SQL 应用上去——按事务在源端的提交顺序和事务环境加载,保证目标端的事务一致性和引用完整性。加载阶段同样支持多线程并行加速。
围绕三段式,KFS 还有一整套可靠性保障,官方叫"多维检查":
| 检查项 | 干什么 |
|---|---|
| 事务同步顺序检查 | 源端事务的执行顺序 = 目标端的加载顺序 |
| 日志连续性检查 | 源端解析、目标端同步两端的日志序号对得上,防丢防重 |
| I/O 顺序检查 | 严格控制同步文件的持久化写入顺序 |
容错层面,断点续传、故障自动重启、连接重试都是标配;再往上还有 多实例 HA 热备——KFS 同步实例自身做主备,主实例故障,备实例自动接管。同步链路自己不能成为单点,这个产品设计我给好评。
还有一块必须单独说: 数据一致性校验与修复是内置的。
同步链路跑得再稳,客户心里还是会打鼓——"你怎么证明两端数据是一致的?"KFS 的做法是把校验模块直接做进产品:支持全量详细比对、抽样比对、MD5 摘要比对、多线程比对,发现差异可全自动修复,也可人工介入;校验还能与同步同时进行,不用停业务。
这一点在迁移场景里分量最重。多少迁移项目最后卡在"不敢切换",缺的就是一份拿得出手的一致性证明。
三、国产化浪潮中的三重价值
产品讲完了。落到国产化替代这件事上,我看 KFS 的价值就三句话: 搬得动、退得了、用得上。下面一个个说。
价值一:平滑迁移——把停机窗口从"天"级压到"分钟"级
金仓的平滑迁移方案是"工具组合拳",四步走:
| 步骤 | 工具 | 干什么 |
|---|---|---|
| ① 结构迁移 | KDMS(迁移评估工具) | 评估兼容性,完成表结构、对象迁移 |
| ② 全量搬迁 | KDTS(迁移工具) | 基于 SCN/LSN 快照,把存量数据搬往目标端 |
| ③ 增量缓存 | KFS | 全量搬迁期间,源端新产生的增量实时解析、缓存在 KFS 本地 |
| ④ 增量追平 | KFS | 全量完成后,把缓存增量加载到目标端;两端追平后切换应用 |
关键在后两步: 全量搬迁跑多久都行(TB 级数据搬几天没关系),因为业务产生的增量一直在被 KFS 接住。等全量搬完、增量追平,真正需要停业务的,只剩"暂停应用、把连接指向新库、重启应用"这一小段——分钟级。
下面是从金仓原厂案例中得到的信息:
- 某邮政客户:迁移停机从 10 小时以上降到 5 分钟;
- 某直辖市市政交通一卡通:12.3TB 存量、1.8 亿用户、早高峰 3 小时 5900 万笔交易,迁移耗时 3 天内,期间业务不停,日增 500GB 秒级同步;
- 某基金公司 TA 系统:60TB 存量、每日 1500 万笔事务,业务切换时长在 30 分钟内。
方案本身也在持续演进——从早期需要部署临时中间库的做法,到基于 SCN 的半无感方案,再到现在源端"全程无感"的版本(先缓存增量、再全量迁移、自动检测处理冲突,迁移时间还缩短了约三成)。对源库的侵扰。
价值二:双向同步 + 双轨并行——“进可攻,退可守”
搬得动解决的是体力活,客户心里真正的疙瘩在后面:切换之后出了问题怎么办?
单次切换做得再漂亮,也是条单行道:一旦业务切到新库,发现某个存储过程行为不一致、某个边缘场景性能崩了,没有任何退路——除非重新做一次反向迁移。
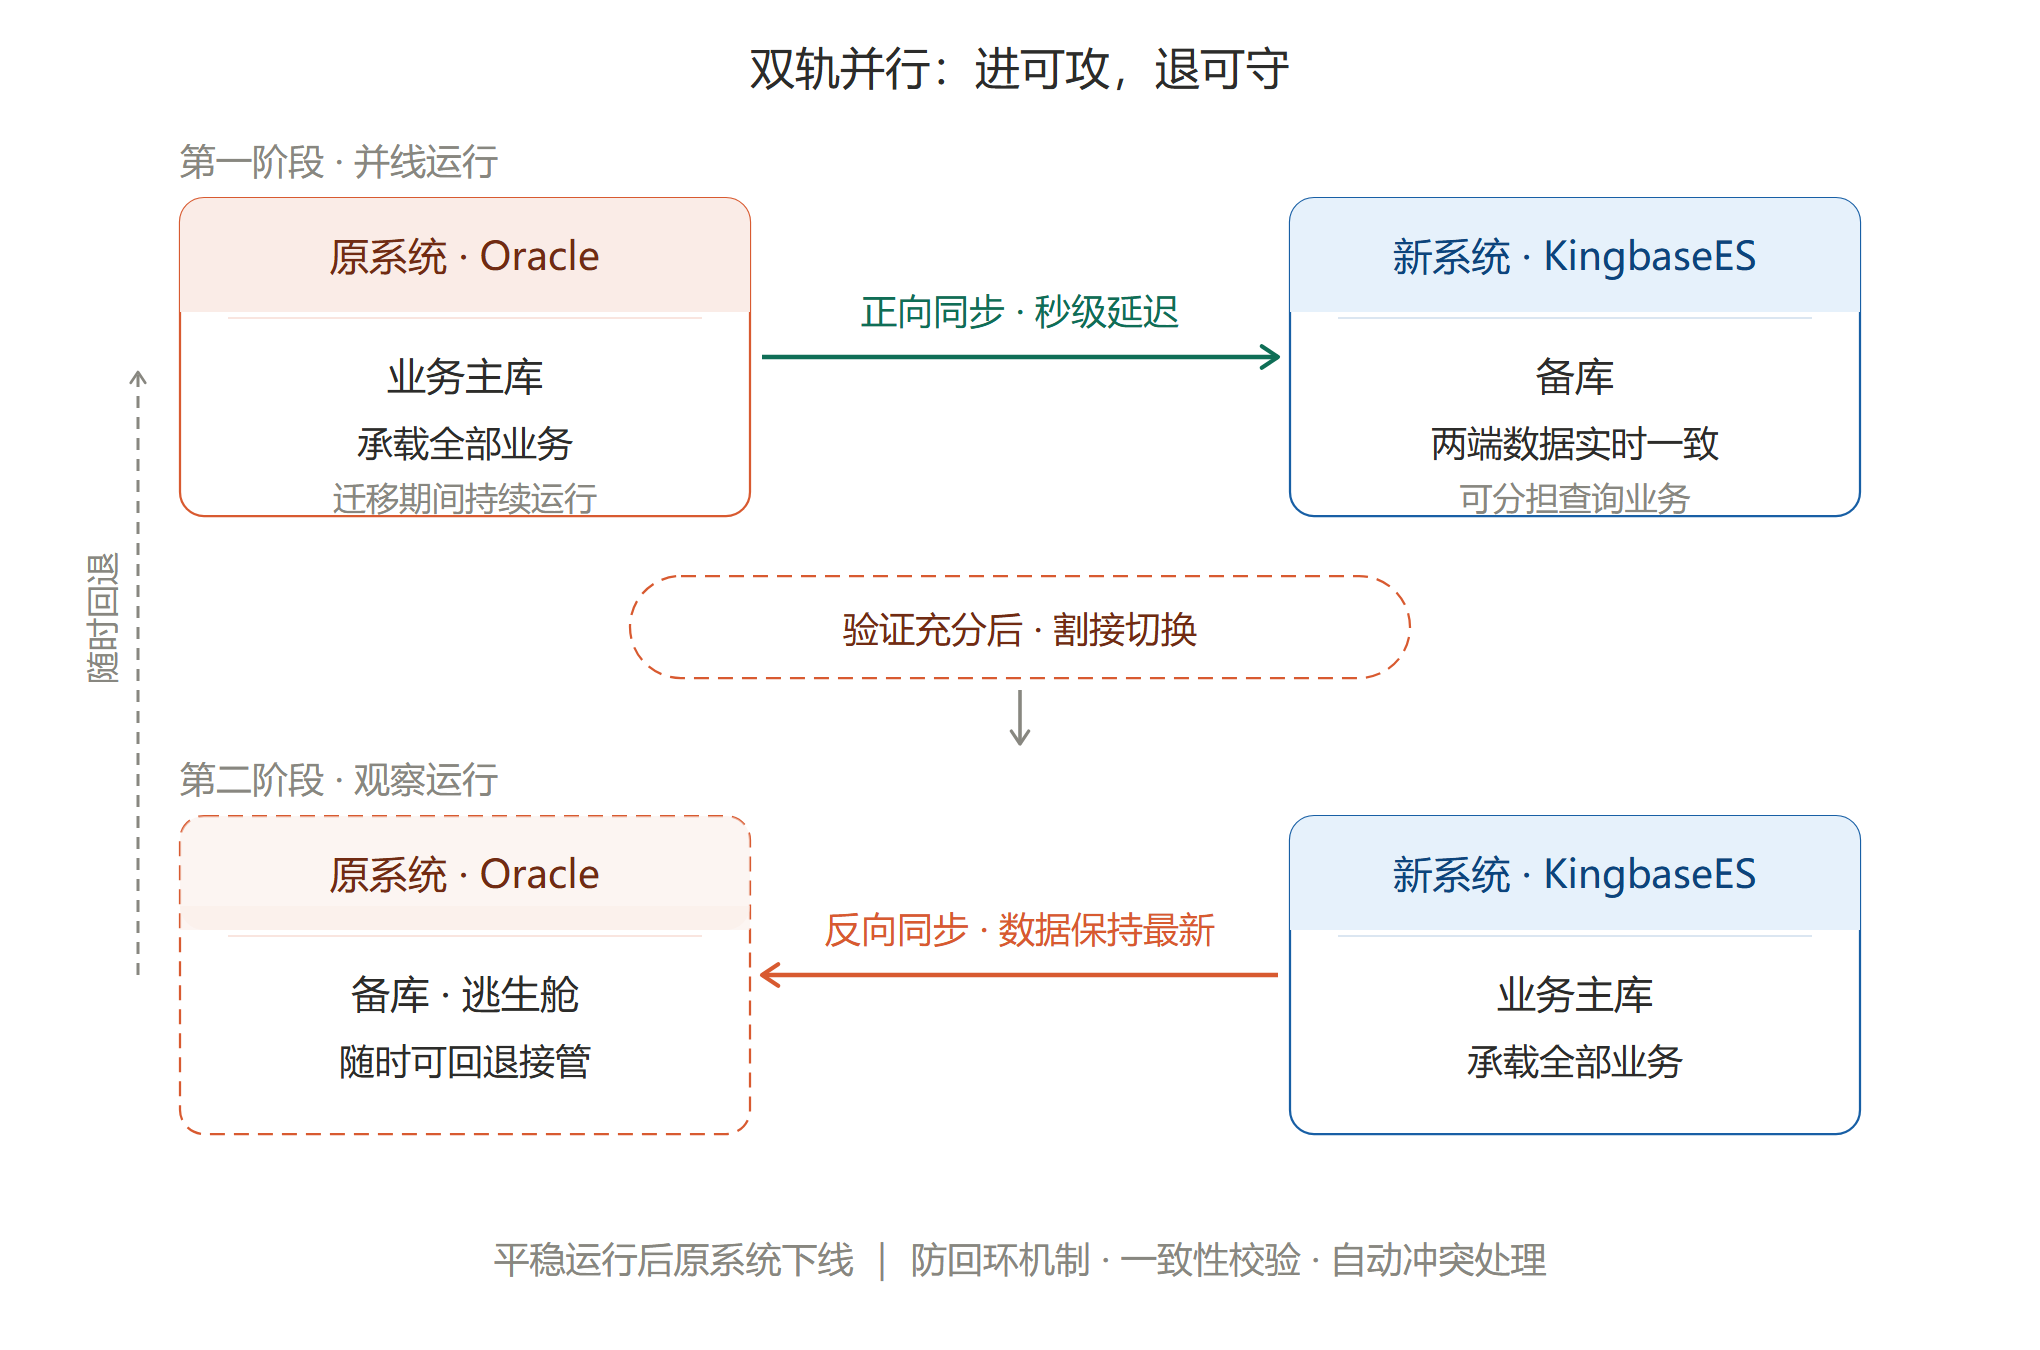
KFS 的方案是双向同步加双轨并行,分两个阶段:
- 第一阶段(正向同步):原系统继续当业务主库,KFS 把 Oracle 的数据实时同步到新搭建的 KingbaseES——新系统先当"备库"养着,期间还能分担一部分查询业务;
- 第二阶段(反向同步):验证得差不多了,割接切换。KingbaseES 升为业务主库, 同步方向调头——KFS 把 KES 上新产生的数据实时同步回 Oracle。
妙就妙在切换之后,老 Oracle 变成了你的"逃生舱"。新系统真出问题,随时把业务切回去——数据一直在通过反向同步保持最新。等新系统跑稳了、验证够了,再让老系统彻底下线。
还是搬家的比喻:先住进新房,老房子暂不退租。住新房期间,新添置的东西同步备份回老房;住着不对劲,随时搬回去,啥都不缺;住踏实了,再退老房。
(这里有个技术细节:双向同步最怕"数据回环"——A 同步到 B,B 又把这条同步回 A,无限循环。KFS 内置了防回环机制,这在多数据中心互相同步的场景里是刚需。)
更稳的做法是阶梯渐进式切换,不必"一夜全切"。某金融客户的公开案例:六个业务模块分四批走,先切两个模块到新系统(其余继续正向同步),观察验证;没问题再切一批;最后全部切完。每一批都看得住、退得回。对核心系统来说,这种小步快跑比一把梭稳太多了。
价值三:跨系统数据共享——换库之外的应用场景
前两个价值都围着"换库"转。但数据同步工具的用途不止换库——现实中不少客户的国产化项目,本来就是跟数据平台建设绑在一起做的:
- 一对多分发:省中心的数据实时分发给 N 个地市。某省发改委的公开案例:省级平台通过 KFS 向 16 个地市做跨广域网实时分发,网络条件只有 2M 带宽,同步延迟亚秒级——靠的是 4 倍传输压缩加断点续传这些硬功夫;
- 多对一汇聚:反过来,把分散各地的数据归集到统一平台。某大型医院的公开案例:8 个院区、400 多个业务系统、Oracle/SQL Server/MySQL 混部,60TB 以上存量、每天 300GB 以上增量,全部实时采集、清洗转换后入湖,采集加转换的延迟控制在 10 秒内;
- 异构投递:目标端不限于关系库——Kafka、Flink CDC、Greenplum、ClickHouse、Hive 都能作为目标。交易库的变更实时进 Kafka,下游大数据和流计算直接消费,这条链路如今很主流。
这些场景跟迁移没什么关系,用的却是同一套同步能力。
总结
回到开头那个问题:“切换那晚,睡不着怎么办?”
KFS 管不了所有风险,但切换之夜最要命的几件事,它都接走了:
- 平滑迁移——存量加增量一站式搬迁,停机窗口压到分钟级,解决"搬得动";
- 双向同步 + 双轨并行——正向养备库、反向留退路,随时可回退,解决"退得了";
- 跨系统共享分发——一对多、多对一、异构投递,替换完成后数据照样流动,解决"用得上"。
国产化替代走到今天,早过了争论"能不能替"的阶段,大家真正关心的是"怎么替得稳"。思路其实很朴素:别把切换搞成一次性豪赌,拆成小步走,每一步都看得住、退得回。KFS 这类工具,就是把这套朴素打法做成了产品。
老规矩,知道写了些啥。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/31466763/viewspace-3180753/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- 胖头鱼的技术专栏-478 Agent 成了新用户,数据库要接住它的下一步(20261014)
- 胖头鱼的技术专栏-477 26ai新特性实战:表达式分区(20261013)
- 胖头鱼的技术专栏-476 26ai新特性实战:聚合过滤(20261012)
- 胖头鱼的技术专栏-475 蹭到最后,就没人摆摊了(20261010)
- 胖头鱼的技术专栏-474 从能跑到能上线:PG SplitJSON 0.2.0 和 0.1.0 差在哪
- 胖头鱼的技术专栏-473 26ai新特性实战:日历函数(20261004)
- 胖头鱼的技术专栏-473 改JSON的一个字段不再重写整篇:我给PostgreSQL 18写了个扩展
- 胖头鱼的技术专栏-472 26ai新特性实战:无 FROM 子句的 SELECT 语句(20261003)
- 胖头鱼的技术专栏-471 数据库优化的三层楼——为什么多数人总在第二层打转
- 胖头鱼的技术专栏-470 那条跑了半年的 SQL,怎么说慢就慢了(20260925)
