胖头鱼的技术专栏-478 Agent 成了新用户,数据库要接住它的下一步(20261014)
作者:胖头鱼的鱼缸(尹海文)
Oracle ACE Pro: Database
PostgreSQL ACE
10年+数据库行业经验
拥有OCM 11g/12c/19c、MySQL 8.0 OCP、Exadata、CDP等认证
墨天轮MVP,ITPUB认证专家
圈内拥有“总监”称号,非著 名社恐(社交恐怖分子)
全网同名:胖头鱼的鱼缸
ITPUB:yhw1809
除授权转载并标明出处外,均为“非法”抄袭
9 月,我去杭州参加了云栖大会,现场听了王远的《Agentic Database:Agent 时代的数据库设计哲学》。后来拿到演讲材料,重新对着看了一遍,发现它和我最近写过的几个问题连在了一起:数据库能力该放在哪一层,Agent 的记忆怎么管,DBA 又该把精力花在哪儿。
听完这场演讲,我更在意的是操作者的变化。我们以前主要面对人写好的程序,现在还得面对会自己拆任务、调用工具、根据结果调整下一步的 Agent。它能替人干更多活,也可能把一个错误判断连续执行下去。
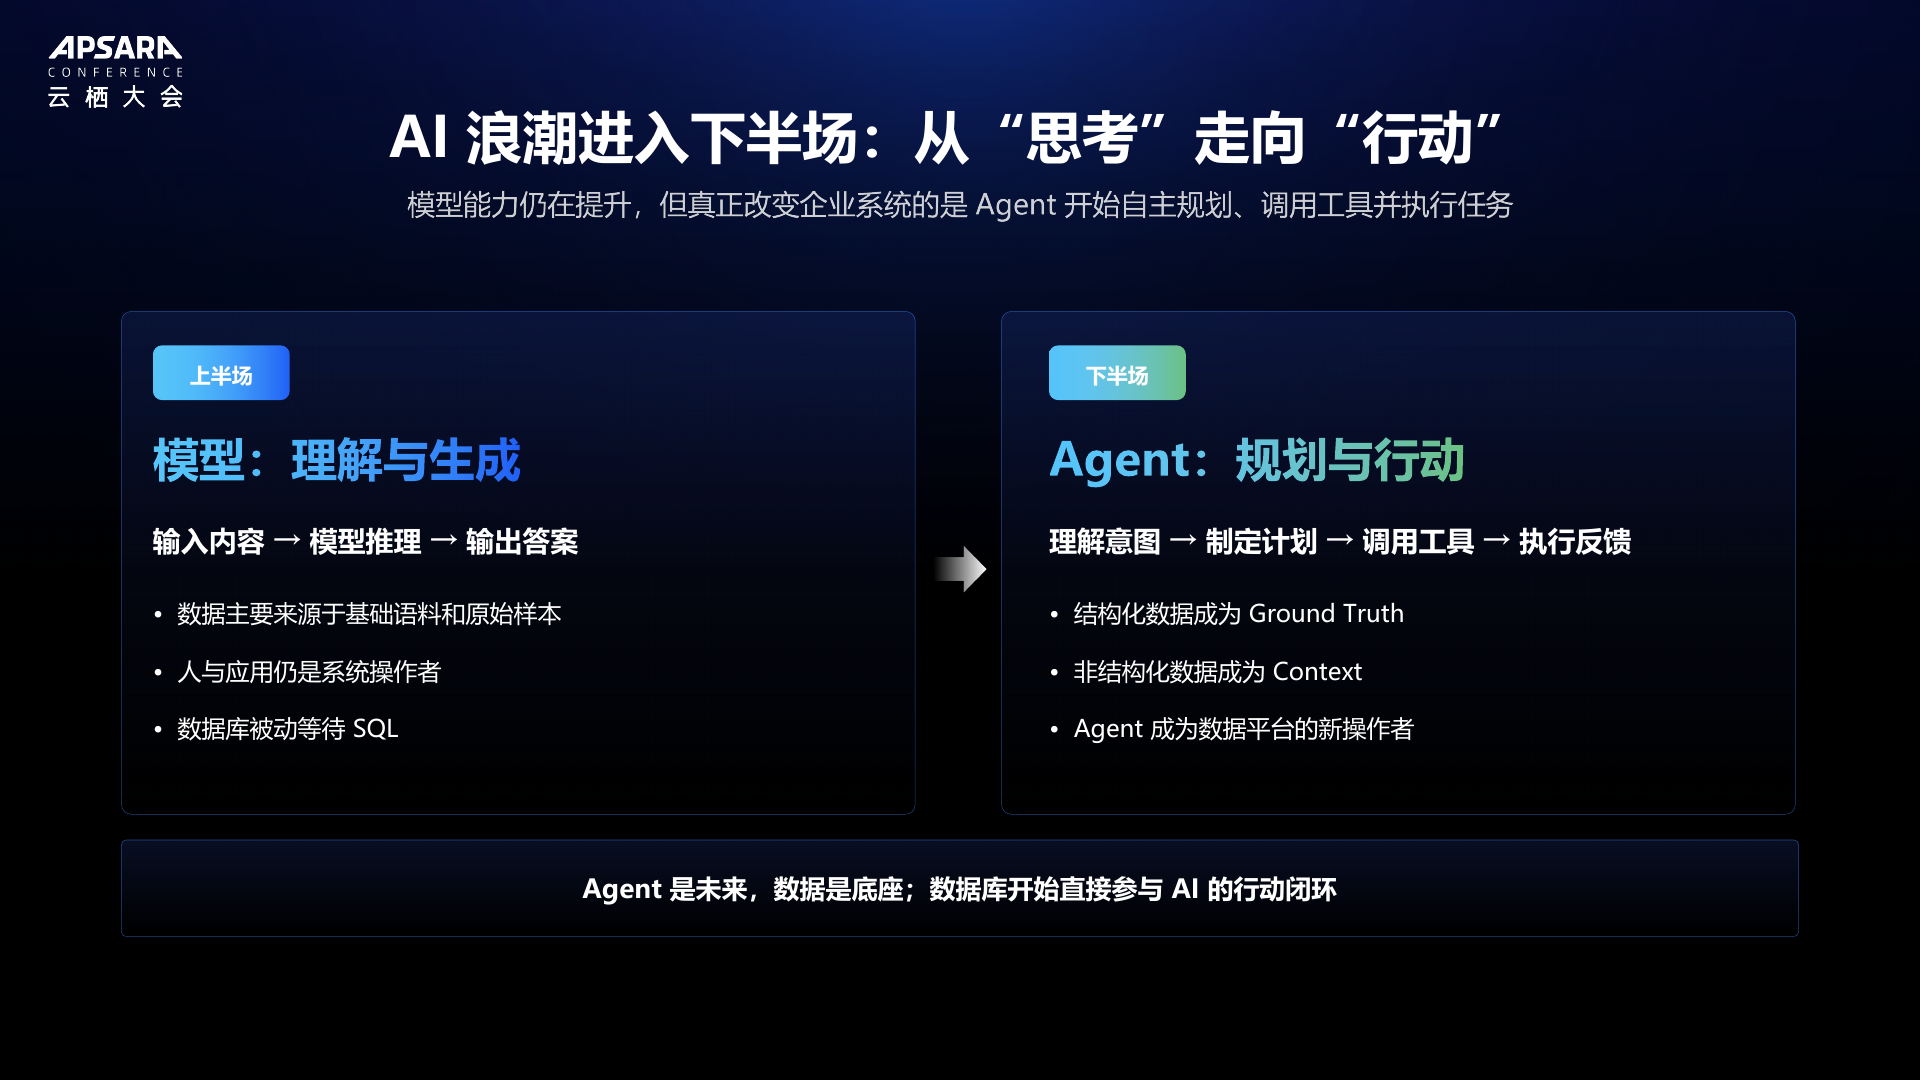
模型能不能写出 SQL,当然要看。但我还想知道:这条 SQL 凭什么执行,改完怎么验,执行错了怎么办?对做数据库的人来说,后面这些问题直接关系到能不能上线。
一、数据库少做的事,总得有人接着做
之前在 《胖头鱼的技术专栏-465 数据库能力上移还是下沉:库变弱了,应用就变重了(20260828)》里,我聊过一个取舍:数据库这一层少承担一些能力,上面的应用就得自己补。
Agent 应用也一样。事务状态、数据权限、记忆版本、任务隔离,这些需求不会因为换了一个更聪明的模型就消失。如果底层不提供公共能力,每个团队就得在应用里各自维护一遍,还要保证它们能配合工作。
现场讲的 Agentic Database,把这些需求放进了同一套设计里。回看下面这张架构图,我关注的是几个层之间怎么配合,而不只是其中列了多少组件。
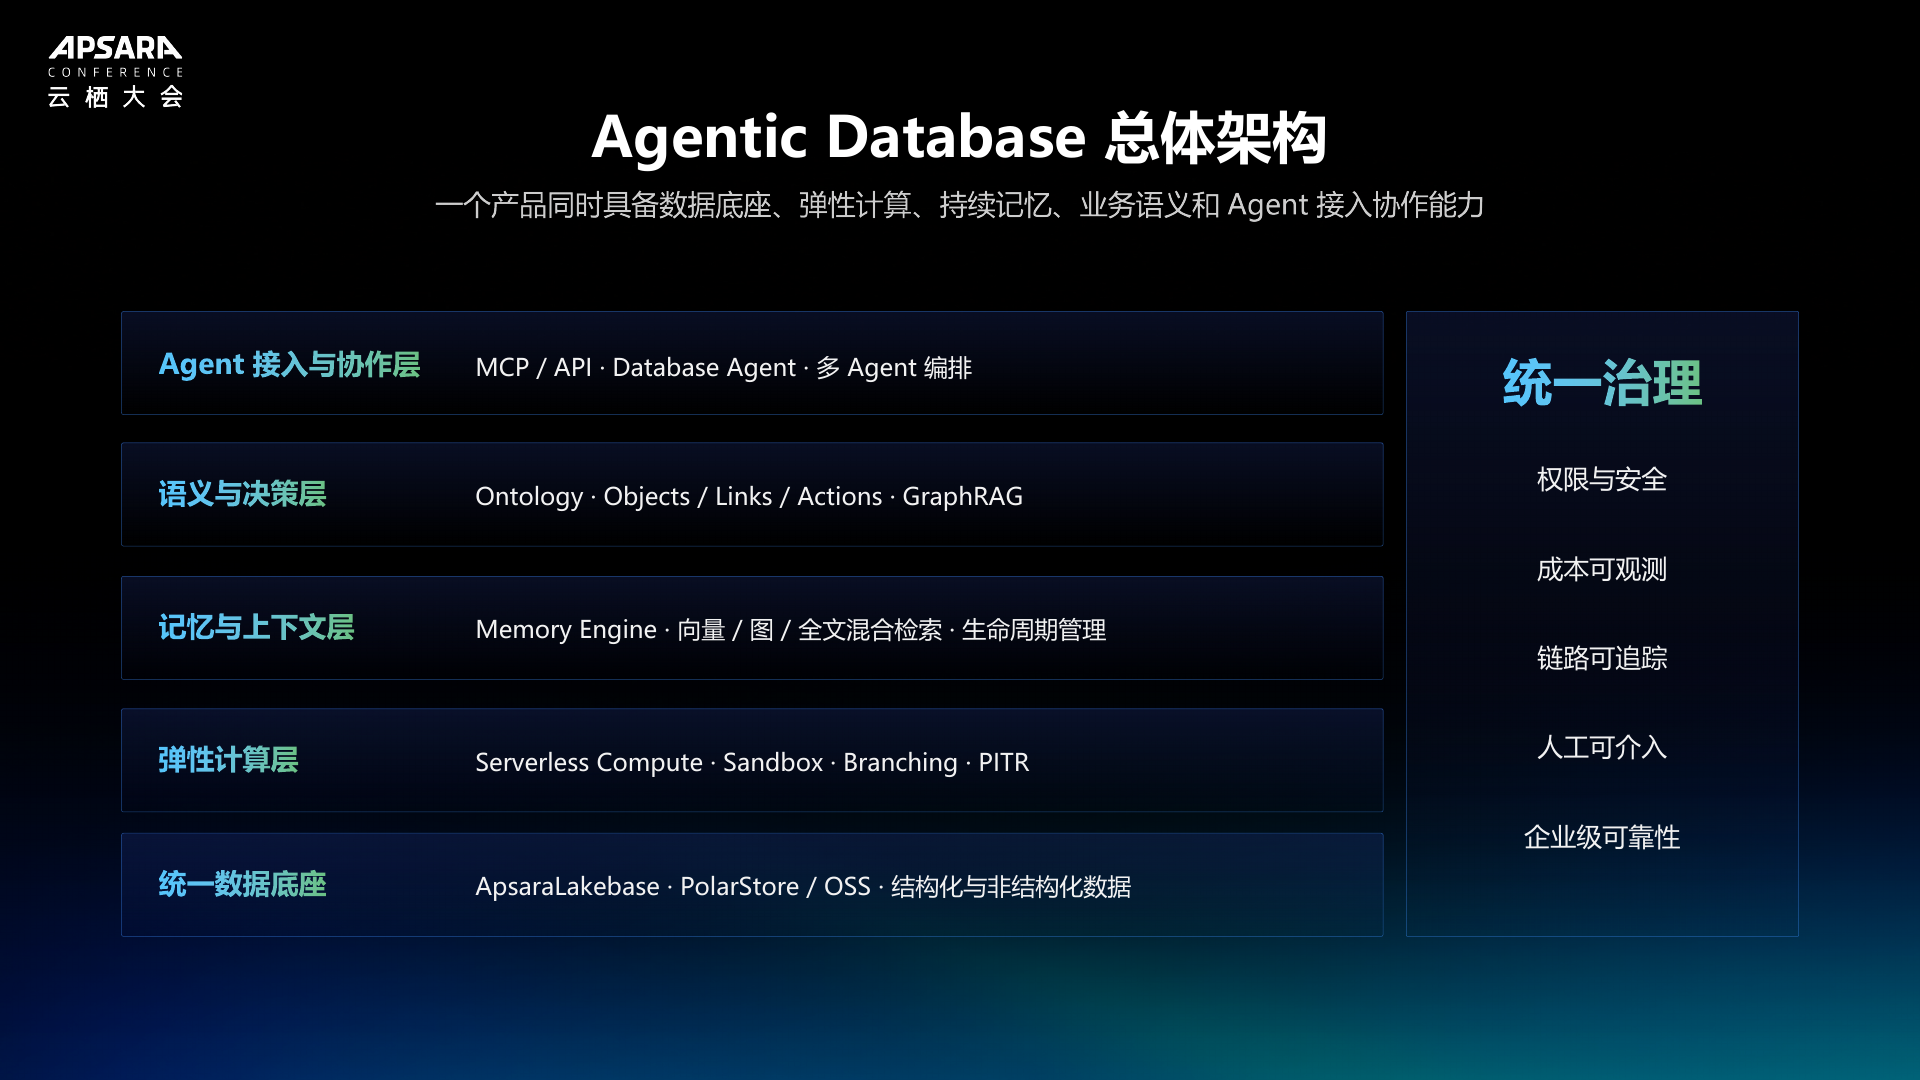
这有点像写字楼:供电、门禁、消防这些公共设施,由每家租户各装一套,管理起来会很麻烦;但物业也不可能替每家公司安排业务。数据库平台可以承担可靠存储、隔离和审计,业务怎么判断、哪些动作值得做,仍然需要业务系统和人来定义。
因此,我认同产品围绕 Agent 的需求扩展,也会继续追问实现边界。表、文件、向量、图可以由不同组件承载,统一访问和治理并不要求全部塞进同一个引擎。哪些能力适合下沉,哪些留在 Runtime 或应用里,要看谁能把一致性、成本和维护责任管清楚。
演讲里把结构化数据称作 Ground Truth,我的理解还要加一个前提:业务记录也可能过期或填错。能查到一行数据,不等于已经拿到了当前任务所需的正确事实,来源、时间和业务口径仍然要核对。
二、允许试错,不等于允许直连生产
任务级计算是我很关注的一部分。Sandbox、Branching、PITR 被放进 Agent 的执行过程里,让它有地方尝试,也有机会在失败后恢复。
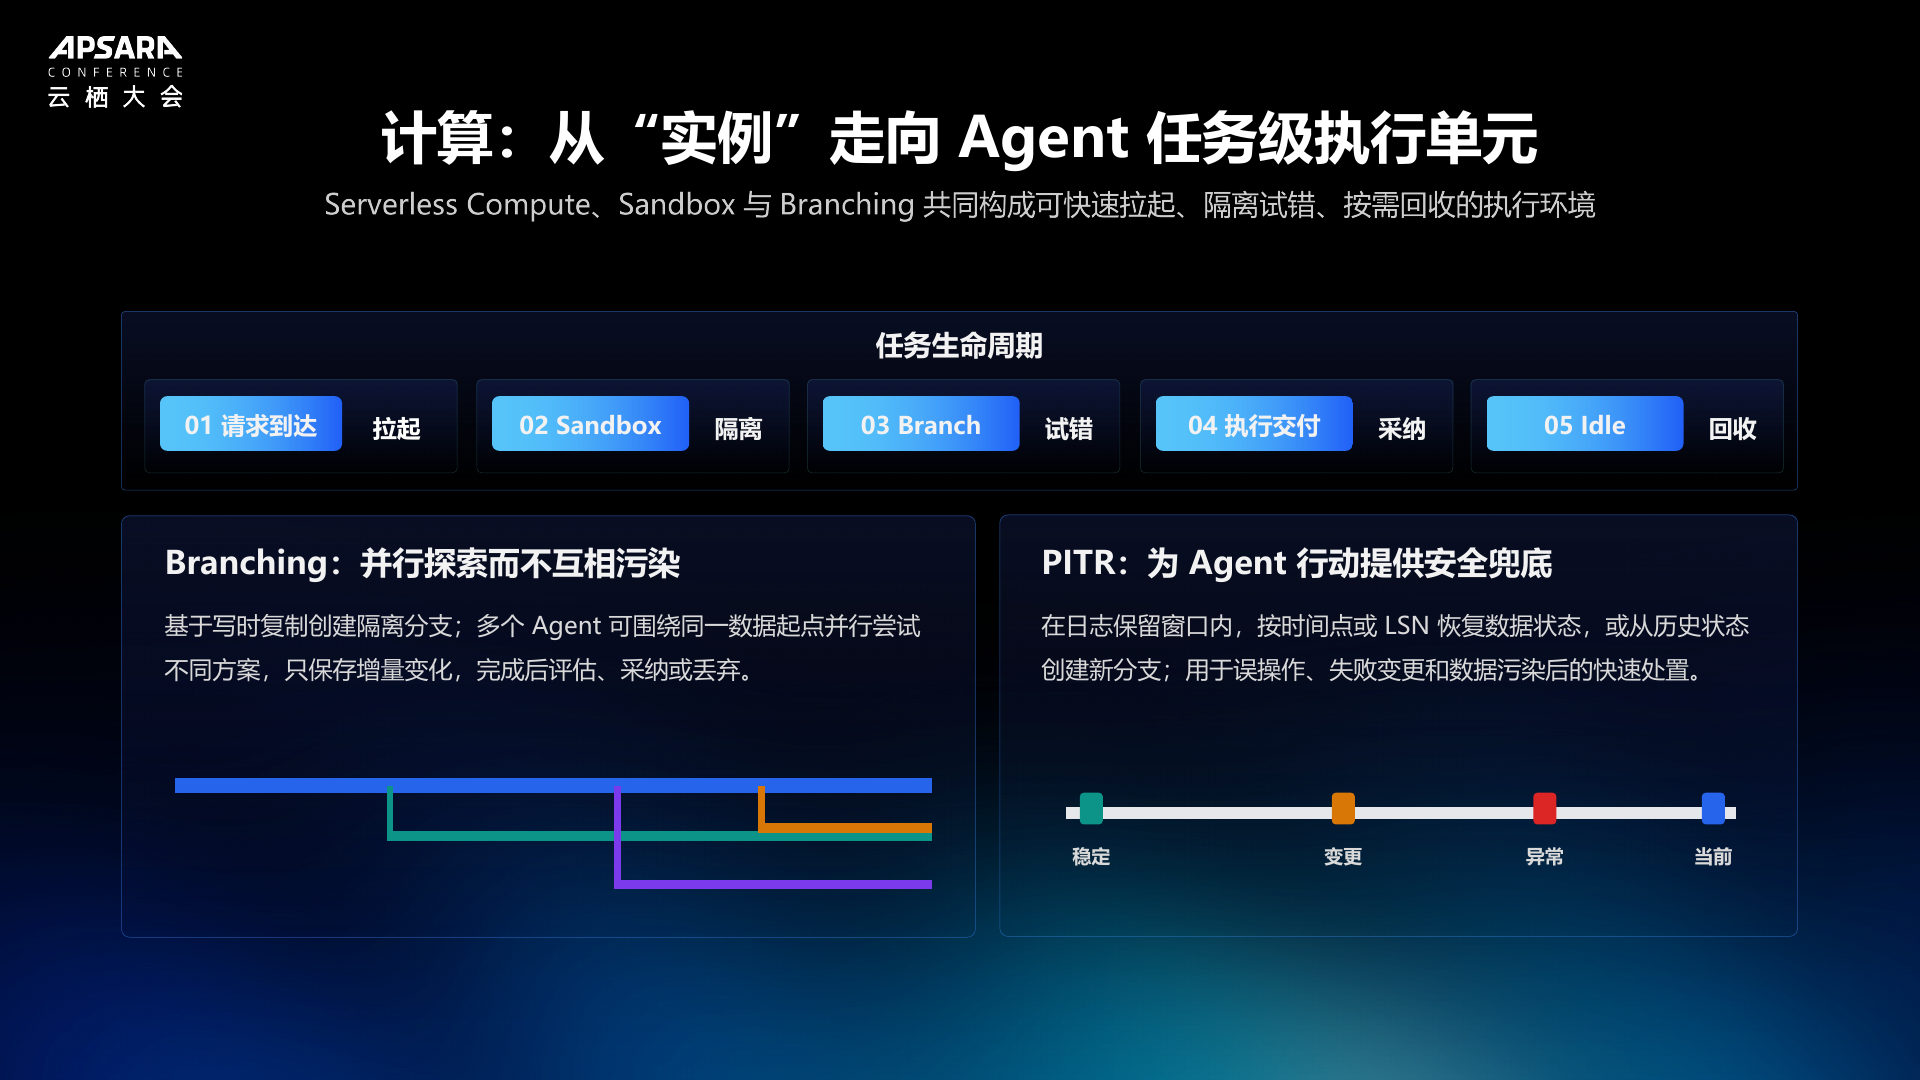
这些机制在数据库领域都有来路。这次值得讨论的是使用方式:把隔离和恢复提前安排进任务,而不只在事故发生后找备份。
拿一个假设的变更任务来说,Agent 想比较两种数据调整方案,可以从同一基线创建隔离分支,各自执行,再检查结果、约束和影响。评估通过以后,才决定怎样把方案用于正式环境。说白了,试错时不该默认拿生产数据当练习对象。
这里有个容易被“分支”两个字带过去的问题: 隔离分支上的结果,怎样采纳到生产环境? 数据库分支不能直接按代码分支的合并方式来理解。生产数据可能已经变化,约束可能冲突,还要重新检查授权和业务条件。这部分需要明确的执行策略,架构图本身不能代替验证。
PITR 也有范围。它能帮助恢复数据库状态,却不能自动撤回已经发出去的邮件,或取消另一个系统已经完成的操作。数据库事务之外的动作,要另外安排幂等、补偿或人工处置。
所以,我会把任务级隔离看作值得采用的设计,同时单独确认分支保留、资源回收、恢复范围和审批点。安全回退需要整条执行链配合。
三、记忆留得住,还得用得对
听到 Memory Engine 这一部分时,我很自然地想到了自己之前写的 《胖头鱼的技术专栏-460 输入给 Agent 记忆不是越多越好(20260813)》。
记忆存下来只是开始。当前任务能不能拿到正确、相关、仍然有效的内容,才决定这份记忆有没有用。
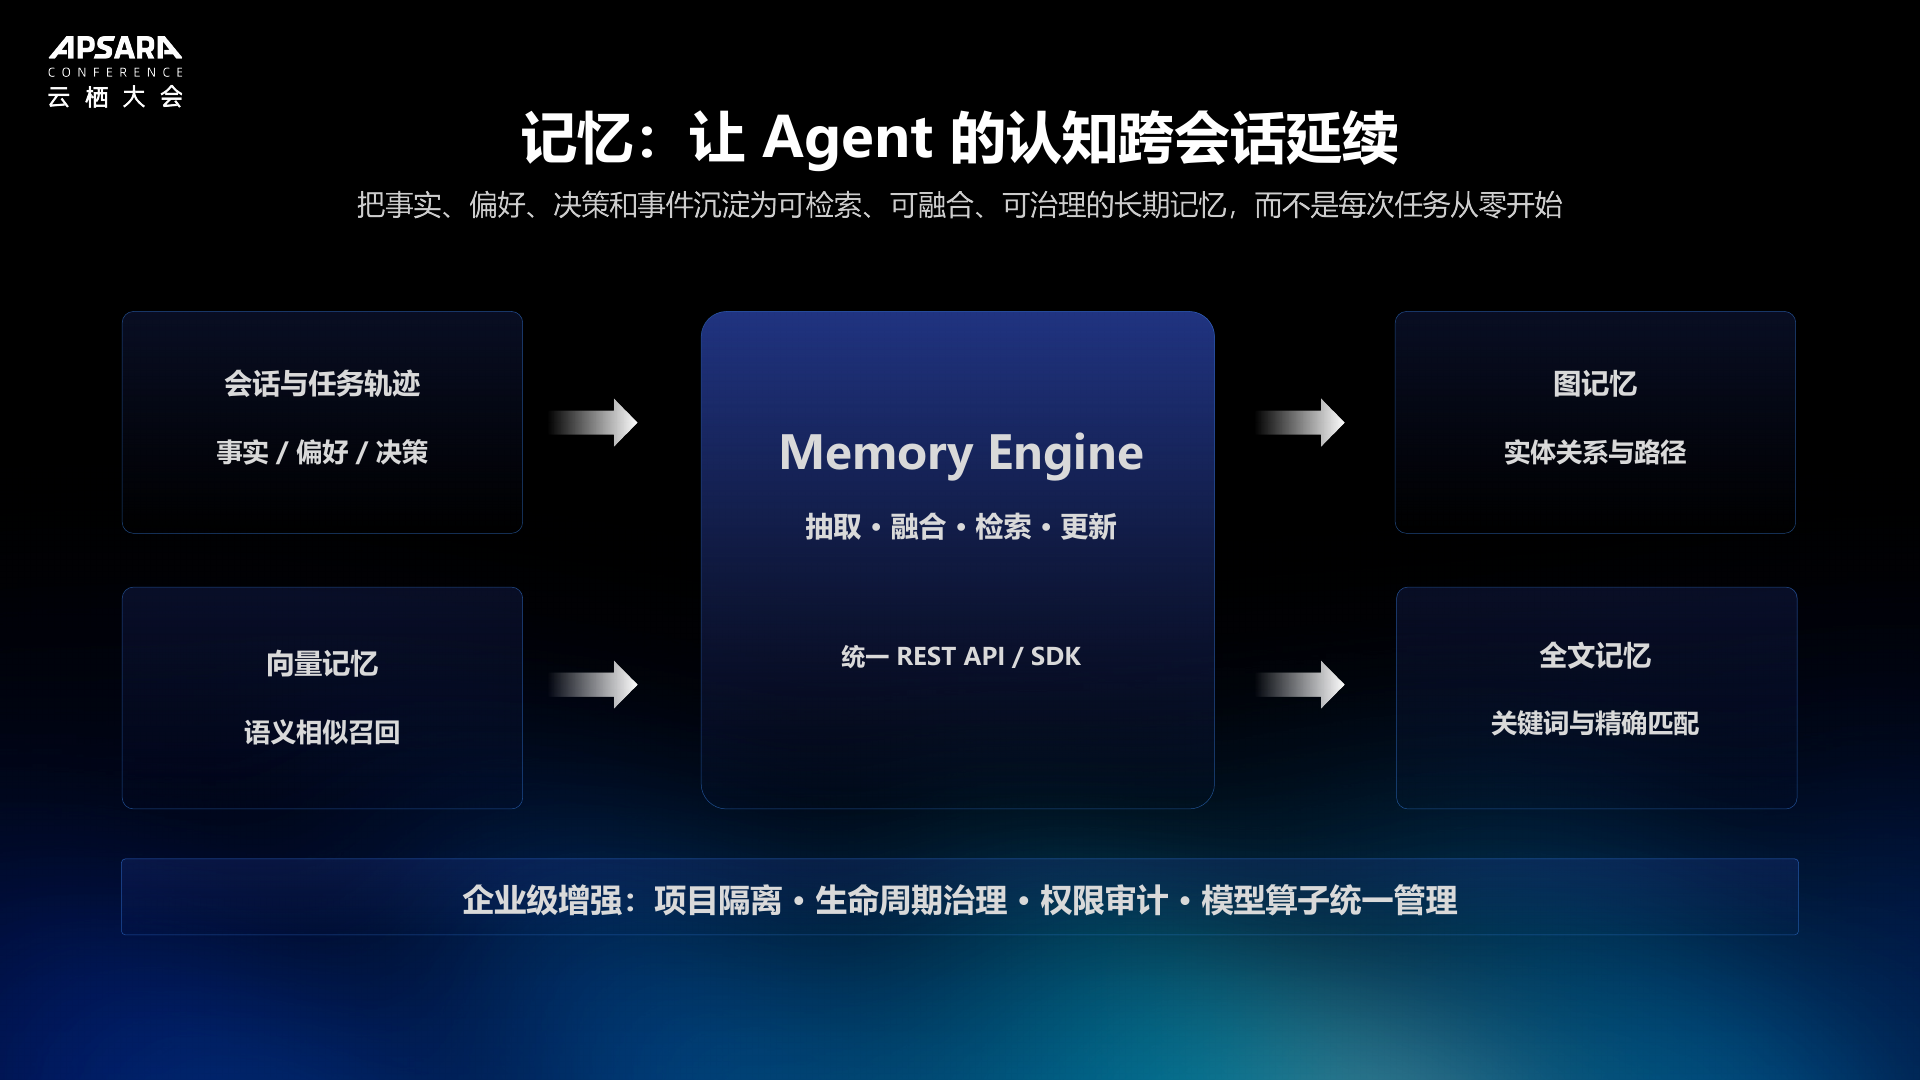
图里的几种检索方式,各有用途。我还会继续看检索之外的事情:一条记忆依据什么生成,谁修正过它,当前到底该用哪个版本,旧版本为什么退出使用。
例如,一条已经撤销的规则,旧文本仍可能与当前问题高度相似。单靠相似度排序,很难判断它还能不能用。有效期、状态、权限和版本需要参与选择,不能等内容进了上下文,再指望模型自己认出来。
我更倾向于保留可追溯的原始记录,整理时生成候选版本,复核以后再切换当前版本。历史保留多少、什么时候删除,则按数据用途和保留策略决定。保留历史,不等于每次都把历史读进上下文。
这也是我一直觉得数据库适合参与记忆治理的原因:版本发布、当前状态和审计记录之间有一致性要求,不能各改各的。向量检索负责找相关内容,事务、约束和授权负责让这些内容按规则使用,各有各的活。
四、懂业务这件事,不能只靠字段名
演讲里的语义层,把业务对象、关系和可执行动作连接起来。这一块让我想到 DBA 工作中经常遇到的情况:SQL 看得懂,业务含义却没那么容易从表结构里读出来。
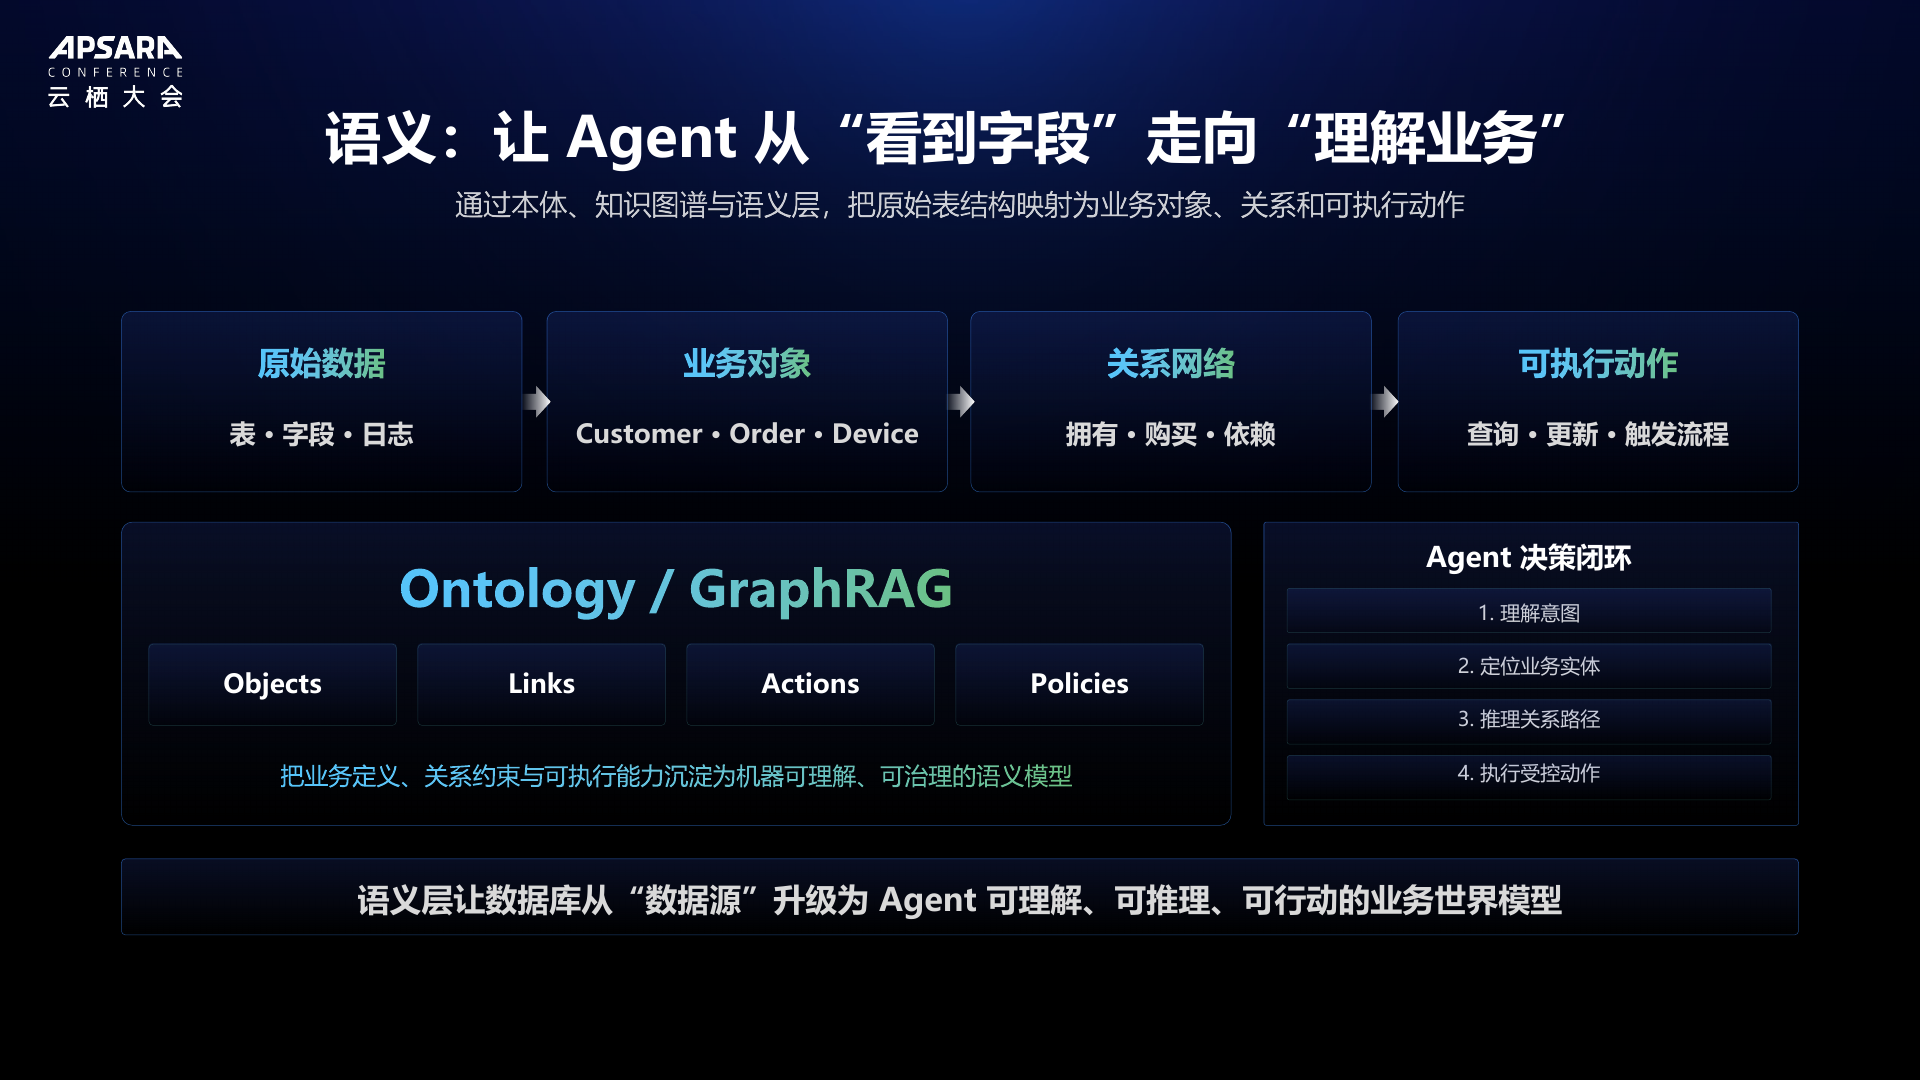
同样叫“已完成”的订单,可能指支付完成,也可能指发货或结算完成。模型能正确关联两张表,不代表它知道业务要的是哪一种口径。口径错了,SQL 跑得再快,算出来的也不是业务需要的结果。
本体(Ontology)和语义层有助于把这些约定明确表达出来。但定义仍然要由懂业务的人确认,业务变化以后也得有人更新。否则只是把原来藏在代码、文档和人脑中的歧义,换了一个地方存。
我在 《胖头鱼的技术专栏-466 别再把“救火“当本事——AI时代,DBA的核心竞争力该往哪放(20260907)》里谈过,DBA 需要关注跑在数据库上的业务。放到这里,工作就很具体了:确认哪些状态可以转换、什么数据能作为依据、哪个动作需要审批,再把这些约定写成可以检查的规则。
对我来说,能让 Agent 正确使用业务数据,比多记几个操作命令更值得投入。命令和方案可以让 AI 辅助生成,执行条件和结果还得有人判断。
五、自动化越多,越要能停下来
现场听到接入与协作这一部分,我的关注点落在了调用之后。MCP、API、SQL 把能力交给 Agent,接下来谁确认身份,谁检查授权,谁决定它可以继续执行?
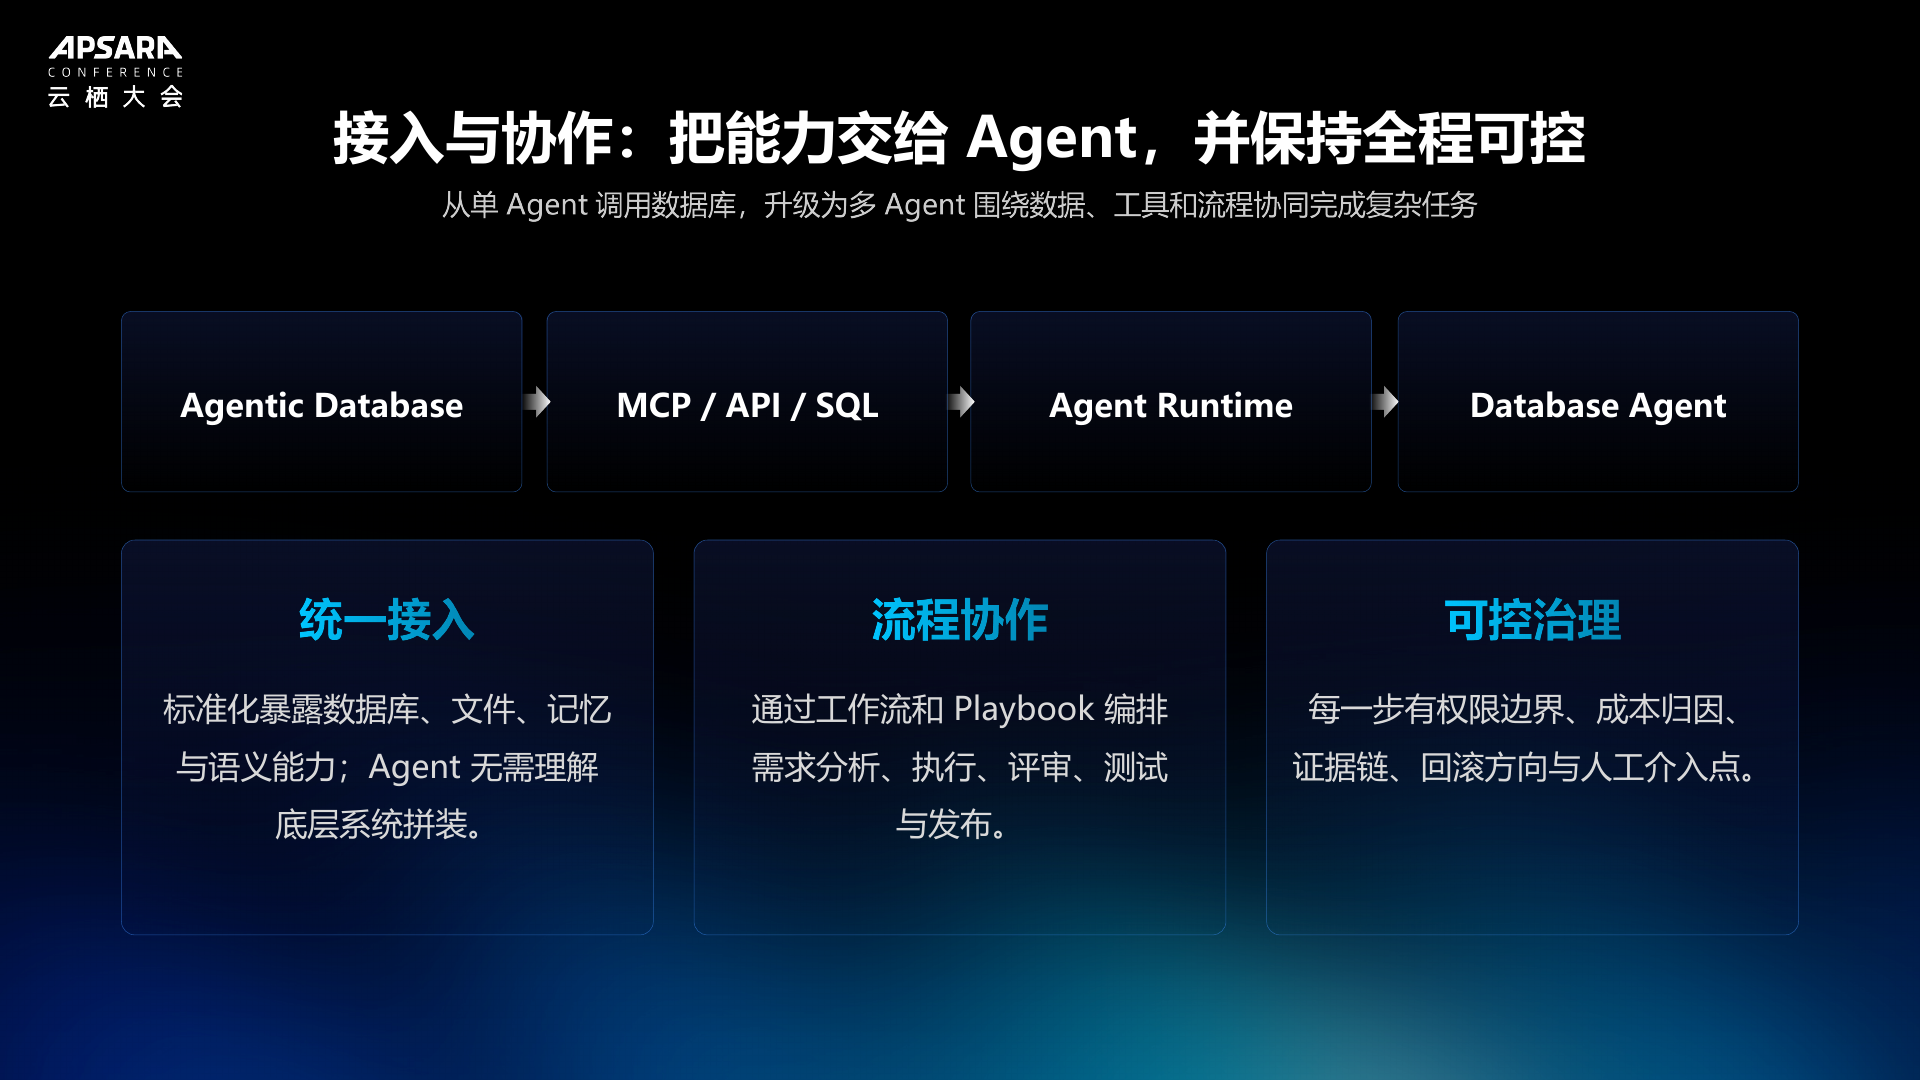
MCP 可以规范工具和能力的接入,具体到业务数据,仍然要落实到可执行的权限边界。用户能看什么,Agent 代表谁做事,哪些操作必须复核,都不能只写进提示词里。
我也希望执行记录能回答具体问题:它读了哪些数据,依据哪个版本的规则,调用了哪个工具,修改了哪些对象,结果是否符合预期。只留一段聊天记录,往往解释不了生产系统究竟发生了什么。
成本同样要按任务看。一条 SQL 很快,不代表整个任务便宜;Agent 可能反复检索、多次重试、长期保留分支。哪些行为消耗了资源、是否需要限制,要从完整任务中观察。
如果让我安排落地顺序,我会先从只读任务和隔离环境开始,把身份、权限、审计与结果校验跑通,再逐步开放影响面明确的写操作。每多放开一种动作,都要确认失败时怎么停、怎么恢复,而不只看成功演示能不能跑完。
总结
听完演讲、再回看材料,我更明确了自己对 Agentic Database 的期待:它应该让 Agent 更容易找到合适的数据,让尝试发生在可控环境里,也让已经执行的动作能够复核。
具体做到哪些,还是要看实际产品和工作负载。我会继续看分支结果怎样采纳、错误记忆怎样修正、业务口径由谁维护,以及跨系统动作出了问题怎样处置。这些细节会影响一套方案能承担多少真实业务。
对数据库从业者来说,事务、权限、恢复这些经验仍然有用,只是要把它们放进 Agent 的整条任务里考虑。数据库这一头可靠,业务那一头也能解释清楚,我才愿意把更多操作交给 Agent。
老规矩,知道写了些啥
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/31466763/viewspace-3185351/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- 胖头鱼的技术专栏-477 26ai新特性实战:表达式分区(20261013)
- 胖头鱼的技术专栏-476 26ai新特性实战:聚合过滤(20261012)
- 胖头鱼的技术专栏-475 蹭到最后,就没人摆摊了(20261010)
- 胖头鱼的技术专栏-474 从能跑到能上线:PG SplitJSON 0.2.0 和 0.1.0 差在哪
- 胖头鱼的技术专栏-473 26ai新特性实战:日历函数(20261004)
- 胖头鱼的技术专栏-473 改JSON的一个字段不再重写整篇:我给PostgreSQL 18写了个扩展
- 胖头鱼的技术专栏-472 26ai新特性实战:无 FROM 子句的 SELECT 语句(20261003)
- 胖头鱼的技术专栏-471 数据库优化的三层楼——为什么多数人总在第二层打转
- 胖头鱼的技术专栏-470 那条跑了半年的 SQL,怎么说慢就慢了(20260925)
- 胖头鱼的技术专栏-469 事务号也会用完:从操作系统的 3.25GB 内存说起(20260914)
