TDSQL for MySQL 集群部署及初始化(详细版)
1. 安装组件
1.1 控制与管控层
-
chitu(赤兔管理平台):全生命周期运营管理控制台,提供实例创建、扩容、销毁及高可用运维的 Web 界面。 -
OSS(Operation Support System):运营支撑系统后台,作为 Web 服务的核心后端,接收并分发来自chitu的请求,调度各底层模块。 -
Scheduler(任务调度器):核心后台调度引擎,负责分布式任务(如备份、扩容、故障切换、定时巡检)的状态机流转与异步执行。 -
Zookeeper(配置中心):分布式协调服务,负责存储集群的全局元数据信息、节点状态、路由表,以及提供高可用主备选举。
1.2 流量与数据层
-
LVS(四层负载均衡):位于最前端,负责将客户端(应用层)的大并发网络流量,均匀、高可用地分发到后端的各个 Proxy 节点。 -
Proxy(数据库网关/代理):分布式计算与数据路由节点。解析 SQL 协议,负责读写分离、分布式数据分片路由(Sharding)、全局唯一键生成以及分布式事务的两阶段提交控制。 -
DB(数据节点引擎):底层核心数据库实例(如存储节点组/Shard)。负责数据的实际落地存储、事务ACID特性保证、主从高可用复制以及本地索引维护。
1.3 监控与审计日志层
-
monitor(监控采集器):轻量级监控 Agent(常驻各物理节点),采集主机、容器及数据库实例的 CPU、内存、I/O 等数百项核心性能指标。 -
Kafka(分布式消息队列):高吞吐日志缓冲流水线,接收来自monitor采集的监控数据以及DB/Proxy产生的全量 SQL 审计日志,进行流量削峰。 -
Consumer(日志消费器):流处理或专项消费程序,负责从Kafka中准实时拉取日志并进行清洗、结构化解析、归类分类。 -
ELK(日志分析堆栈):由 Elasticsearch、Logstash 和 Kibana 组成。负责对消费后的审计日志、错误日志进行分布式存储、全文检索与可视化看板展示。 -
HDFS(大容量分布式存储):冷数据归档中心,用于长期保存、持久化备份历史全量 SQL 审计日志、慢日志或数据库物理/逻辑冷备文件。
2. 集群规划
此次安装选择四个节点,各个节点安装的组件如下:
| 主机名 | tdsql1 | tdsql2 | tdsql3 | tdsql4 |
|---|---|---|---|---|
| IP地址 | 192.168.182.129 | 192.168.182.131 | 192.168.182.132 | 192.168.182.133 |
| ZooKeeper | Y | Y | Y | |
| OSS | Y | Y | ||
| Chitu | Y | Y | ||
| Monitor | Y | Y | ||
| DB | Y | Y | Y | |
| Proxy | Y | Y | Y | |
| Kafka | ||||
| HDFS | Y | |||
| Consumer | Y | |||
| ELK | Y | |||
| LVS | Y | Y |
3. 安装准备
3.1 配置主机名
hostnamectl set-hostname tdsql1
hostnamectl set-hostname tdsql2
hostnamectl set-hostname tdsql3
hostnamectl set-hostname tdsql4
3.2 添加主机名IP映射
sudo tee -a /etc/hosts << 'EOF'
192.168.182.129 tdsql1
192.168.182.131 tdsql2
192.168.182.132 tdsql3
192.168.182.133 tdsql4
EOF
3.3 开启时间同步
- 安装
ntp软件包
yum install ntp -y
server 127.127.1.0 iburst
systemctl restart ntpd
systemctl status ntpd
后面三台机器配置:
server 192.168.182.129
restrict 192.168.182.129 mask 255.255.255.0 nomodify notrap
systemctl restart ntpd
3.4 规划存储目录
mkdir -p /data
mkdir -p /data1
3.5 上传 TDSQL 安装包并解压
4. 安装前配置
4.1 配置免密登录
填入机器 IP 地址和对应的 root 密码
cd /root/tdsql_10.3.17.3.0/tdsql_install/scripts
vim ip_passwd_list
192.168.182.129 ******
192.168.182.131 ******
192.168.182.132 ******
192.168.182.133 ******
sh nokey.sh
4.2 修改 tdsql_hosts 文件
- 使用 UTF-8 字符集
export LANG='en_US.UTF-8'
- 按该文件模板,填入所有组件安装的服务器 IP 地址
vim /root/tdsql_10.3.17.3.0/tdsql_install/tdsql_hosts
[tdsql_allmacforcheck]
tdsql_mac1 ansible_ssh_host=192.168.182.129
tdsql_mac2 ansible_ssh_host=192.168.182.131
tdsql_mac3 ansible_ssh_host=192.168.182.132
tdsql_mac4 ansible_ssh_host=192.168.182.133
# zookeeper机器ip地址, 数量只能是1、3、5, 正式环境建议3台或者5台
[tdsql_zk]
tdsql_zk1 ansible_ssh_host=192.168.182.129
tdsql_zk2 ansible_ssh_host=192.168.182.131
tdsql_zk3 ansible_ssh_host=192.168.182.132
# scheduler机器的ip地址,正式环境建议2个
[tdsql_scheduler]
tdsql_scheduler1 ansible_ssh_host=192.168.182.131
tdsql_scheduler2 ansible_ssh_host=192.168.182.132
# oss机器的ip地址, 正式环境建议2个
[tdsql_oss]
tdsql_oss1 ansible_ssh_host=192.168.182.131
tdsql_oss2 ansible_ssh_host=192.168.182.132
# 赤兔机器的ip地址, 正式环境建议2个
[tdsql_chitu]
tdsql_chitu1 ansible_ssh_host=192.168.182.131
tdsql_chitu2 ansible_ssh_host=192.168.182.132
# 监控采集模块的IP地址,正式环境建议2个
[tdsql_monitor]
tdsql_monitor1 ansible_ssh_host=192.168.182.131
tdsql_monitor2 ansible_ssh_host=192.168.182.132
# db机器地址,有多少台就填多少个ip地址, 注意tdsql_db序号逐个递增,不要跳跃
[tdsql_db]
tdsql_db1 ansible_ssh_host=192.168.182.129
tdsql_db2 ansible_ssh_host=192.168.182.131
tdsql_db3 ansible_ssh_host=192.168.182.132
# proxy机器地址
[tdsql_proxy]
tdsql_proxy1 ansible_ssh_host=192.168.182.129
tdsql_proxy2 ansible_ssh_host=192.168.182.131
tdsql_proxy3 ansible_ssh_host=192.168.182.132
# HDFS 地址
[tdsql_hdfs]
tdsql_hdfs1 ansible_ssh_host=192.168.182.123
# lvs机器地址,数量固定2台
[tdsql_lvs]
tdsql_lvs1 ansible_ssh_host=192.168.182.131
tdsql_lvs2 ansible_ssh_host=192.168.182.132
# kafka机器地址,数量固定3台
[tdsql_kafka]
tdsql_kafka1 ansible_ssh_host=192.168.182.129
tdsql_kafka2 ansible_ssh_host=192.168.182.131
tdsql_kafka3 ansible_ssh_host=192.168.182.132
# 多源同步消费者服务ip地址,数量固定1台
[tdsql_consumer]
tdsql_consumer1 ansible_ssh_host=192.168.182.133
#es机器地址
[tdsql_es]
tdsql_es1 ansible_ssh_host=192.168.182.133
# 保持默认
[tdsql_mc]
tdsql_mc1 ansible_ssh_host=1.1.1.1
tdsql_mc2 ansible_ssh_host=1.1.1.1
tdsql_mc3 ansible_ssh_host=1.1.1.1
[tdsql_newdb]
tdsql_newdb1 ansible_ssh_host=1.1.1.1
tdsql_newdb2 ansible_ssh_host=2.2.2.2
tdsql_newdb3 ansible_ssh_host=3.3.3.3
[tdsql_ansible_test]
tdsql_ansible_test1 ansible_ssh_host=1.1.1.1
tdsql_ansible_test2 ansible_ssh_host=2.2.2.2
tdsql_ansible_test3 ansible_ssh_host=3.3.3.3
4.4 修改 ansible 变量
cd /root/tdsql_10.3.17.3.0/tdsql_install/group_vars
vim all
#scheduler,oss机器网卡
tdsql_sche_netif: ens33
#操作系统账号tdsql的明文密码
tdsql_os_pass: a+complex+password
#赤兔监控库配置, 赤兔初始化完成后需要将监控库信息在这里更新
tdsql_metadb_ip: 192.168.182.131
tdsql_metadb_port: 15001
tdsql_metadb_ip_bak: 192.168.182.132
tdsql_metadb_port_bak: 15001
tdsql_metadb_user: hanlon
tdsql_metadb_password: 123456
#多源同步消费服务的机器网卡
tdsql_consumer_netif: ens33
#一致性读MC机器的网卡, 需要安装MC时配置
tdsql_mc_netif: ens33
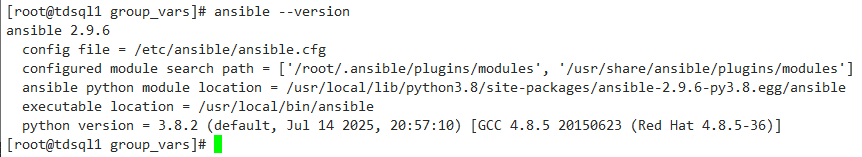
4.5 安装 ansible
cd /root/tdsql_10.3.17.3.0/tdsql_install/scripts
source environment_set
sh install_ansible.sh
验证安装成功:
5. TDSQL安装
使用如下命令 执行安装:
cd /root/tdsql_10.3.17.3.0/tdsql_install
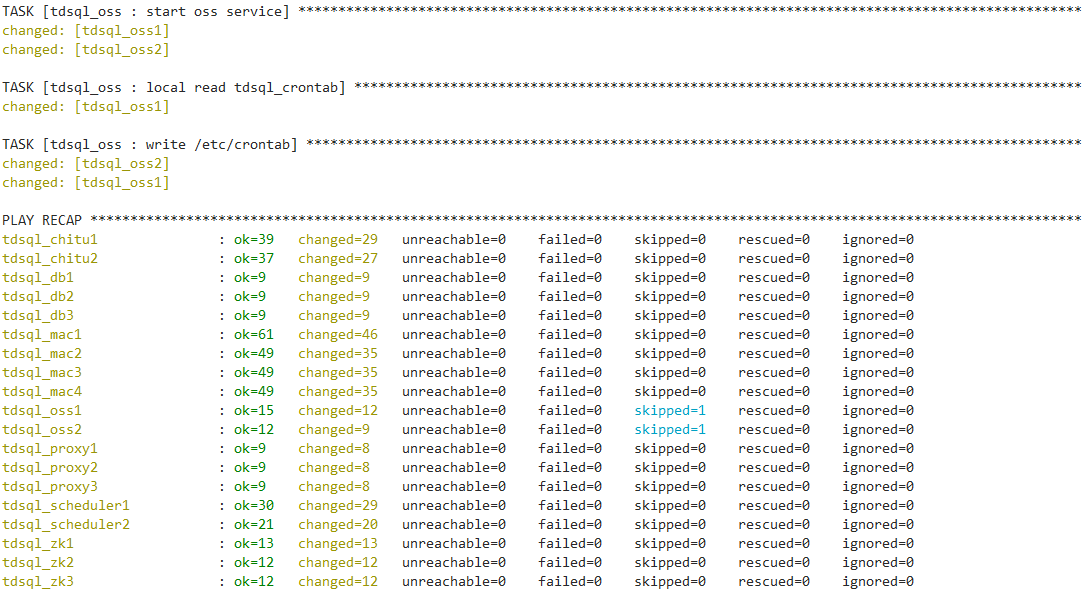
ansible-playbook -i tdsql_hosts playbooks/tdsql_part1_site.yml
安装成功截图:
6. 赤兔初始化
网页访问安装 赤兔模块的机器地址,进行赤兔初始化
http://192.168.182.131/tdsqlpcloud
6.1 同意许可
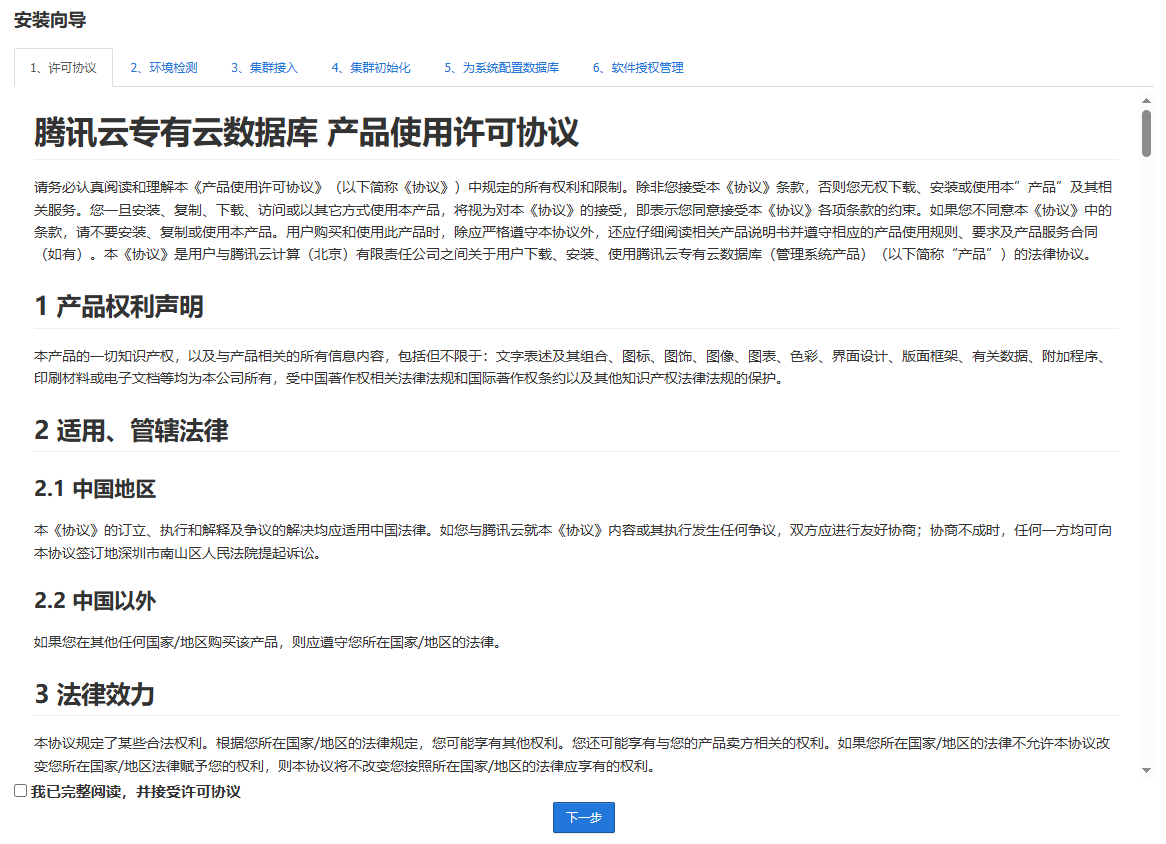
勾选同意,下一步
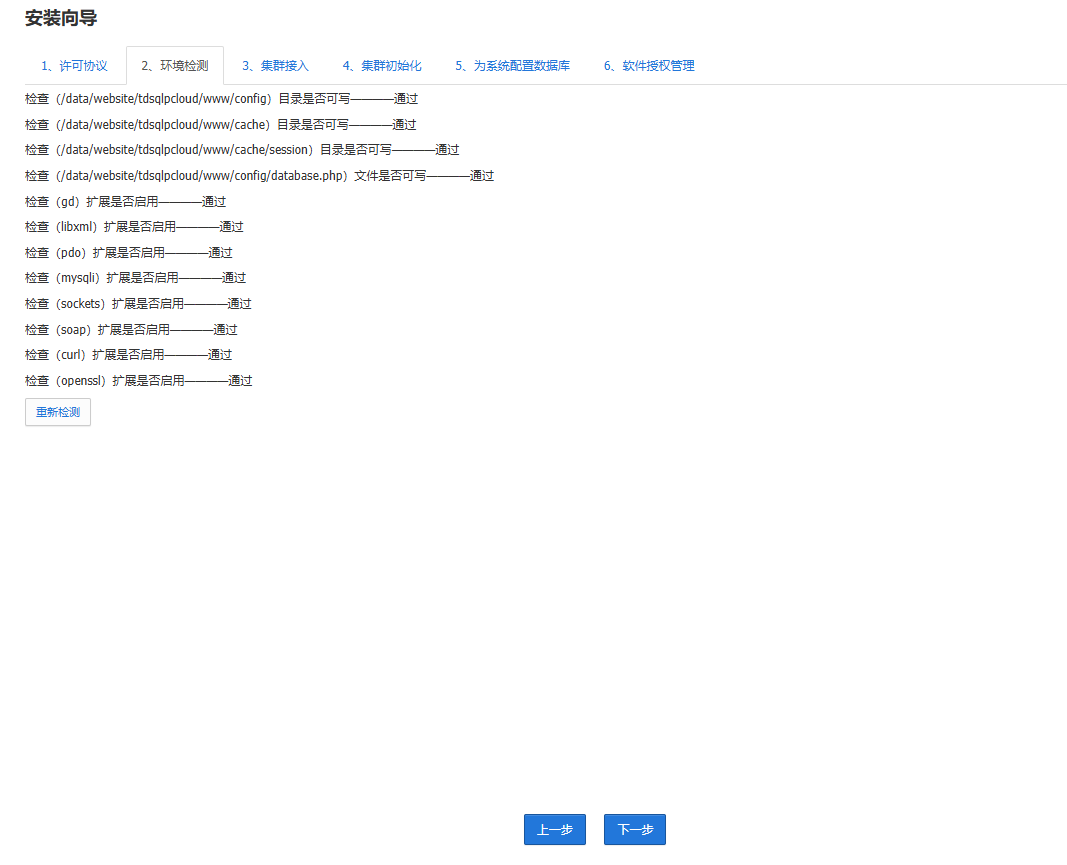
6.2 环境检测
安装完成后,环境检测都是“通过”的,然后下一步;
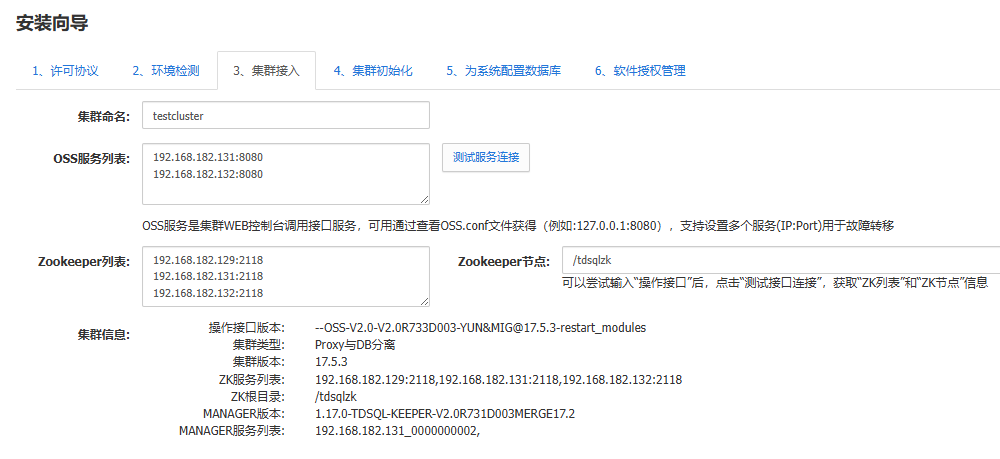
6.3 集群配置
- 第一步:集群命名,此名称全局唯一的,这里命名为
testcluster - 第二步:配置 OSS 服务列表,前面配置了几个 OSS 节点,这里就填几个,格式如提示那样“IP:PORT”形式
192.168.182.131:8080
192.168.182.132:8080
- 第三步:测试 OSS 服务连接,点击旁边的“测试服务连接”按钮,
zookeeper列表会自动显示,zookeeper节点目录也会自动显示出来。
192.168.182.129:2118
192.168.182.131:2118
192.168.182.132:2118
- 第四步:检查集群信息,点击“测试服务连接”后,集群信息也是自动显示。
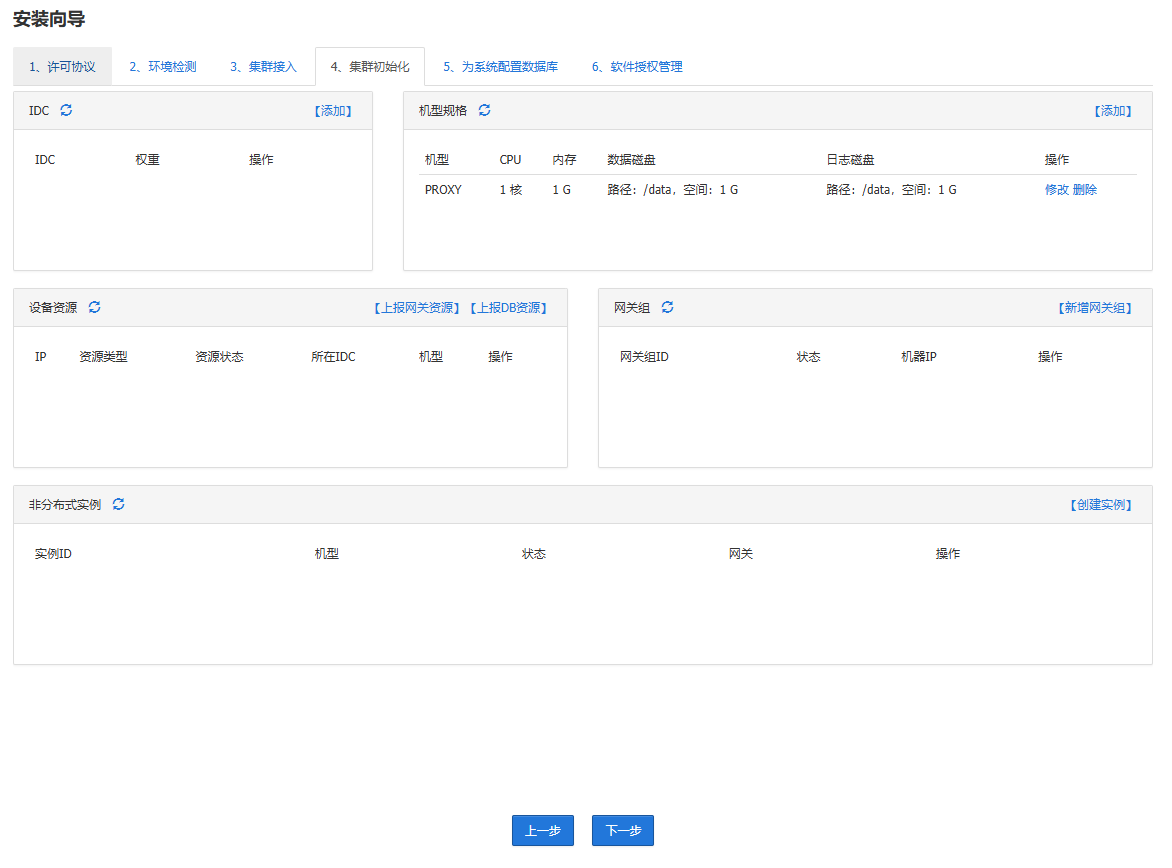
6.4 集群初始化
接下来对每一项内容初始化
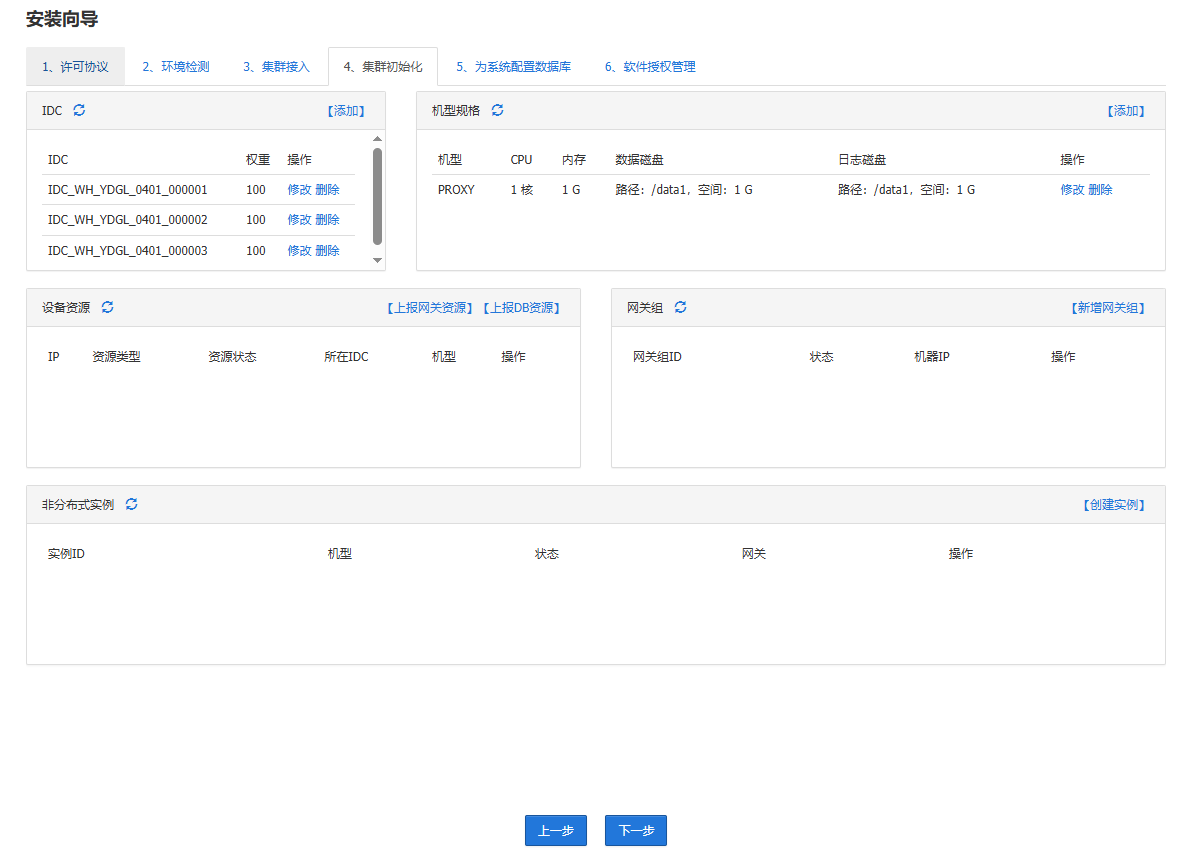
6.5 新增IDC配置
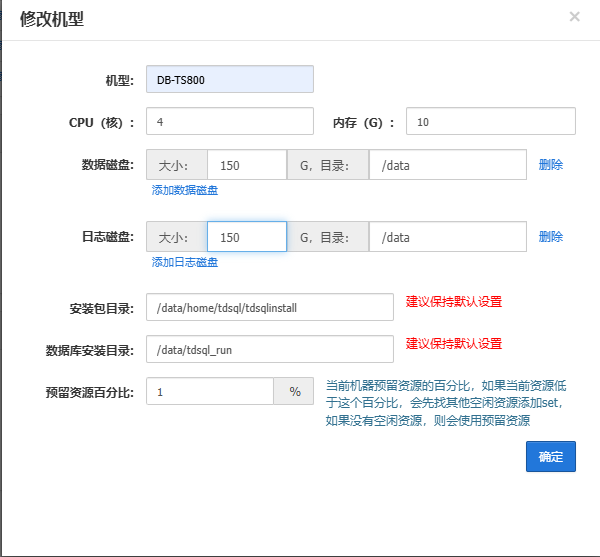
6.6 新增 DB 机器的机型
- 设置 CPU、内存和磁盘大小:
- CPU:cpu 核数和实际逻辑数量一致;
- 内存:设置为实际内存的75%;
- 磁盘总空间设置为实际空间的90%。数据盘和日志盘的大小比例应该是 3:1,数据盘+日志盘 = 服务器实际空间*90%
- 数据磁盘目录:建议设置为:/data1/tdengine/data
- 日志磁盘目录:建议设置为:/data1/tdengine/log
- 安装包目录:/data/home/tdsql/tdsqlinstall
- 数据库安装目录:/data/tdsql_run,固定不变。
- 预留资源百分比:1%
- 设置完成,点击右上角添加
6.7 新增网关机器的机型
网关机型已经自动创建好,不需要手动创建,也不用修改。
6.8 上报DB设备资源
- IP:填写实际的DB机器的通信ip地址。
- 机型:选择刚才创建的机型,如TS80。
- IDC:根据实际情况,选择其归属于哪一个IDC。
- fenceid、frame、zone:都默认即可。
- 将规划的数据库IP上报,各对应一个数据中心。
192.168.182.129  IDC_WH_YDGL_0401_000001
192.168.182.131  IDC_WH_YDGL_0401_000002
192.168.182.132  IDC_WH_YDGL_0401_000003
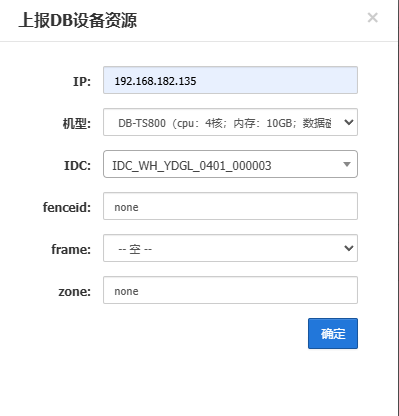
点击完成,其他两个节点同上。
6.9 上报网关资源
IP:填写实际的
PROXY 机器的 IP 地址。
跟我们创建
OceanBase 集群时候一样,一个
Zone 划分一个节点,这里上报三台 Proxy,各对应一个数据中心。
192.168.182.129  IDC_WH_YDGL_0401_000001
192.168.182.131  IDC_WH_YDGL_0401_000002
192.168.182.132  IDC_WH_YDGL_0401_000003
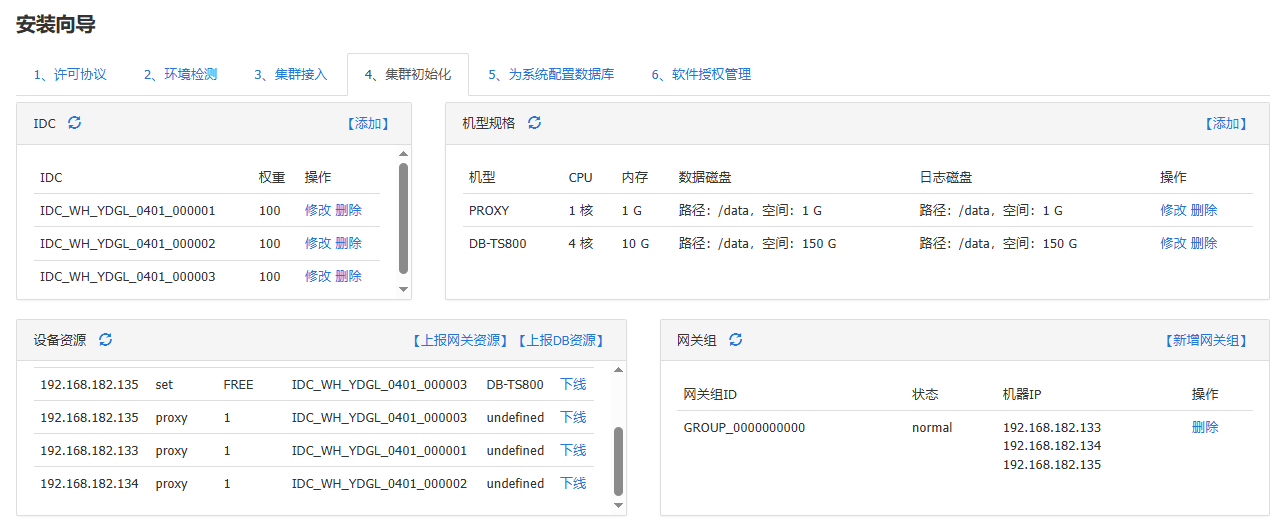
6.10 新增网关组
如下图,因为之前上报了3台proxy机器,从 3 个IDC中 选择 3台机器
6.11 创建实例(监控库实例)
监控库实例建议的规格为:
- CPU:4C
- 内存:8G
- 数据盘:100G
- 日志盘:50G
注意:必须是5.7版本
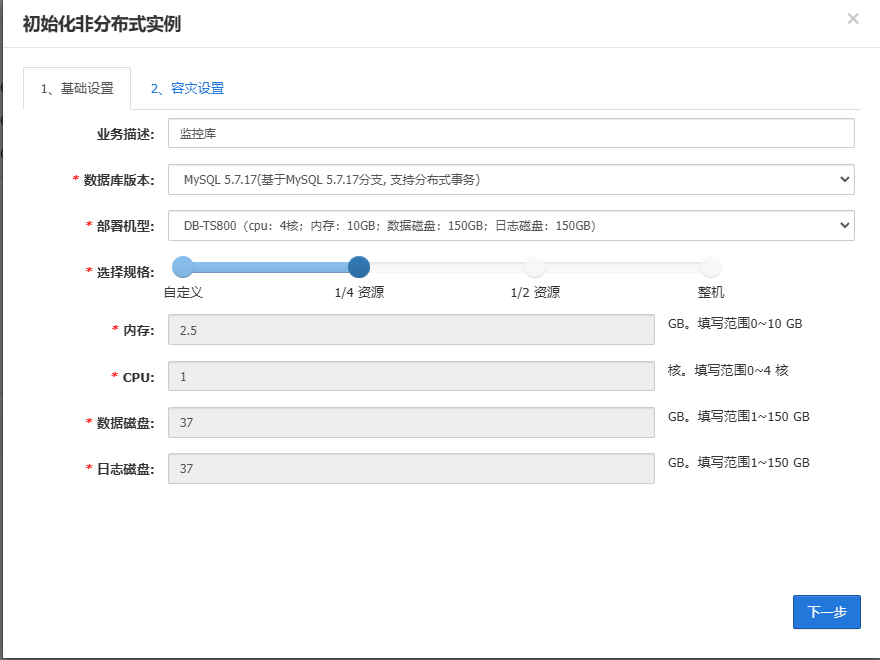
资源不够,选的单机,创建比较慢,首先创建 Proxy,才会创建DB
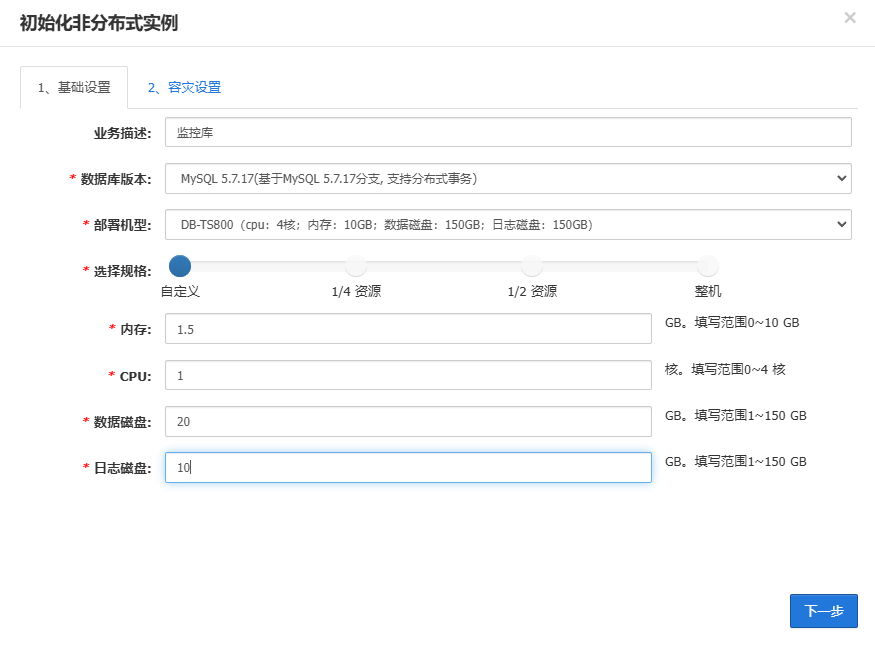
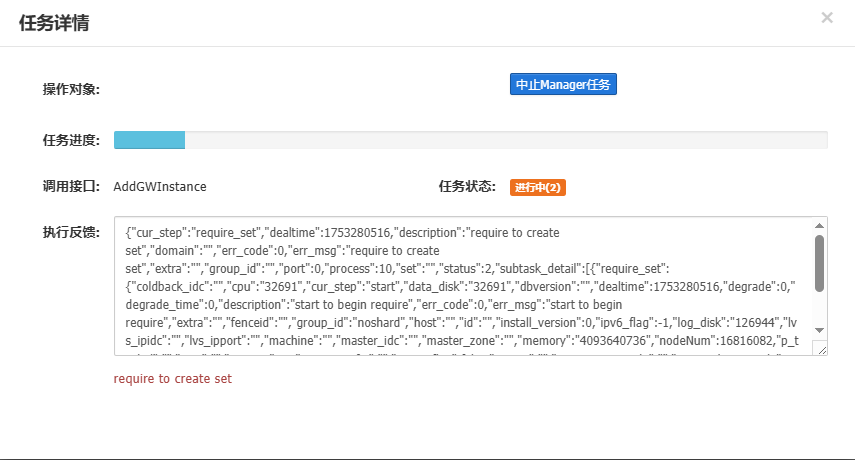
安装完成提示,赤兔数据库安装完成,点击初始化。
6.12 为系统配置数据库
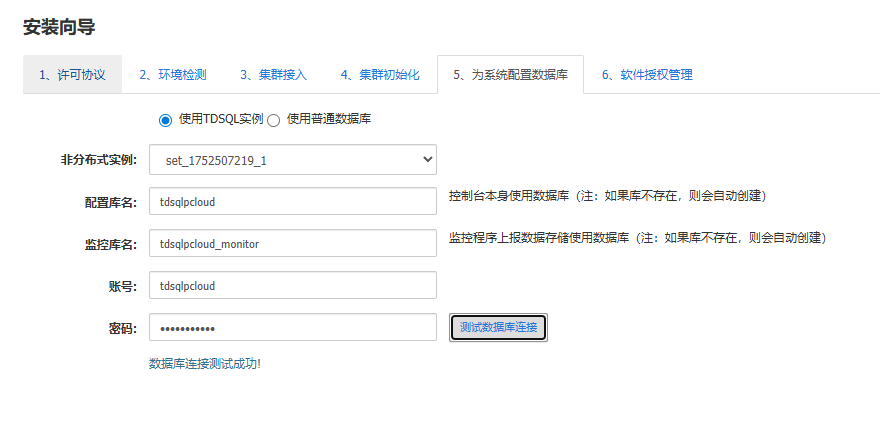
密码和用户名相同,点击开始安装。
6.13 授权许可文件:
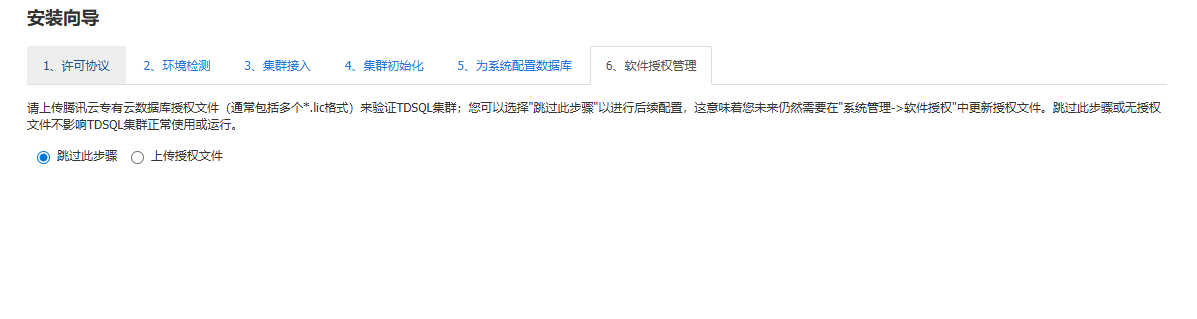
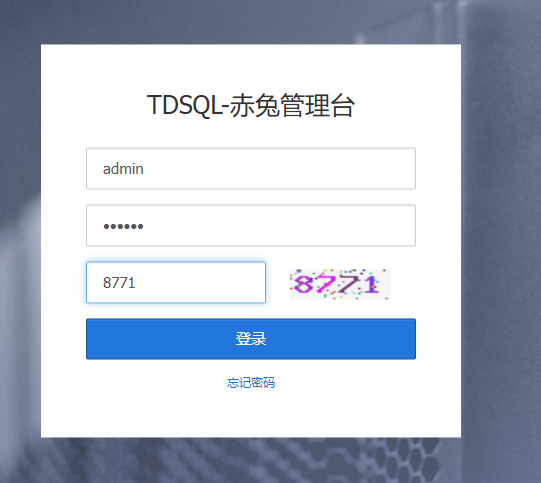
6.14 登录赤兔管理平台
安装完成,登录赤兔管理台:admin/123456
6.15 再次修改ansible变量
- 在赤兔的页面点击刚才的监控库实例(初始状态只有这一个实例)
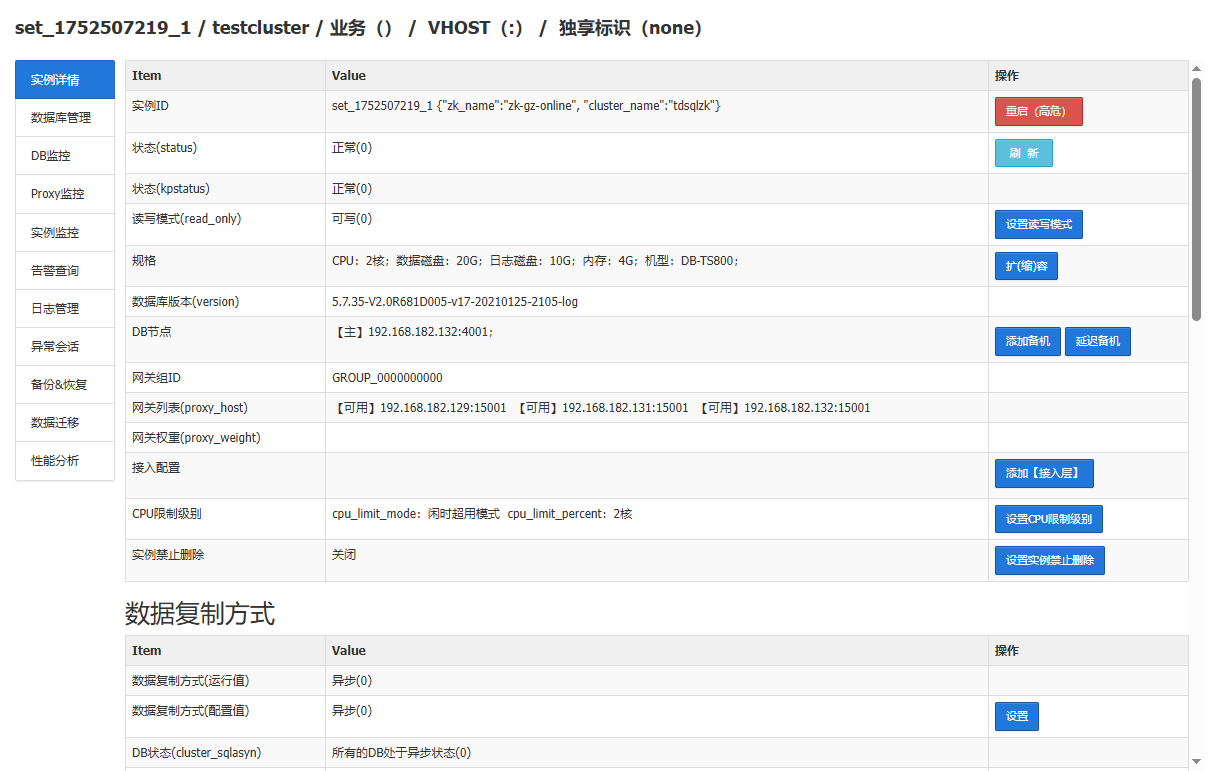
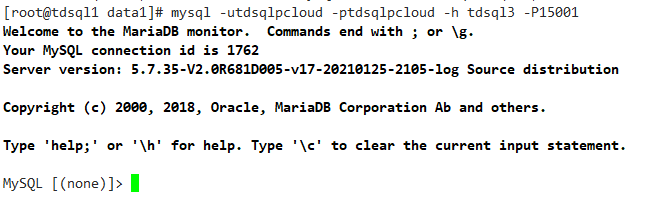
- 根据得到的连接参数,用 mysql 客户端测试一下监控库是否可以连接
mysql -utdsqlpcloud -ptdsqlpcloud -h tdsql3 -P15001
- 将监控库的连接参数写入到变量文件
group_vars/all中
vim group_vars/all
#修改如下参数
tdsql_metadb_ip: 192.168.182.131
tdsql_metadb_port: 15001
tdsql_metadb_ip_bak: 192.168.182.132
tdsql_metadb_port_bak: 15001
tdsql_metadb_user: tdsqlpcloud
tdsql_metadb_password: tdsqlpcloud
- 安装大约4分钟左右,日志路径/var/log/ansible.log,最终显示failed任务数为0表示安装成功。
- 最后一步安装
ansible-playbook -i tdsql_hosts playbooks/tdsql_part2_site.yml
到这里,必选模块已经安装完成,后面是
HDFS、
Kafka 等可选组件的安装。
7、可选安装模块
7.1 安装 HDFS
安装 HDFS 的机器数量只能是 1 台或 3台。如果只部署1台,只能保留配置 tdsql_hdfs1 的配置。
- 修改文件
vim tdsql_hosts
[tdsql_hdfs]
tdsql_hdfs1 ansible_ssh_host=192.168.182.133
- 修改hdfs变量
修改group_vars/all中下面的相关变量
vim group_vars/all
tdsql_hdfs_ssh: 36000
tdsql_hdfs_datadir: /data2/hdfs,/data3/hdfs,/data4/hdfs
- 192.168.182.133节点上创建目录:
mkdir -p /data2/hdfs
mkdir -p /data3/hdfs
mkdir -p /data4/hdfs
- 安装hdfs
执行如下命令安装:
ansible-playbook -i tdsql_hosts playbooks/tdsql_hdfs.yml
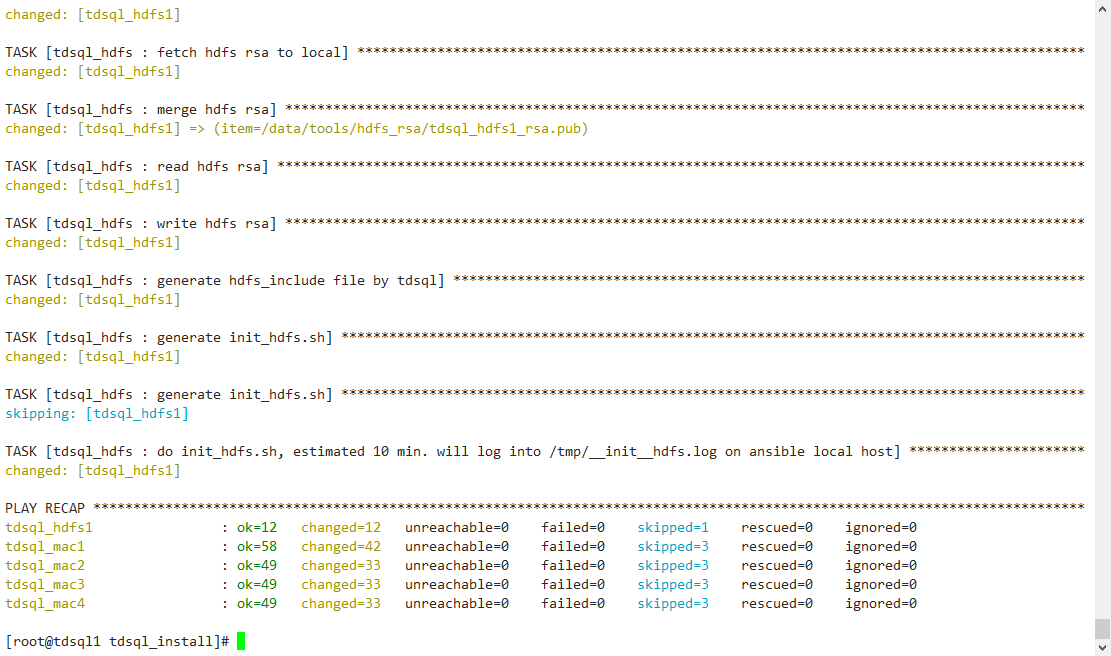
ansible 任务最终显示 failed 任务数为 0 表示安装成功。
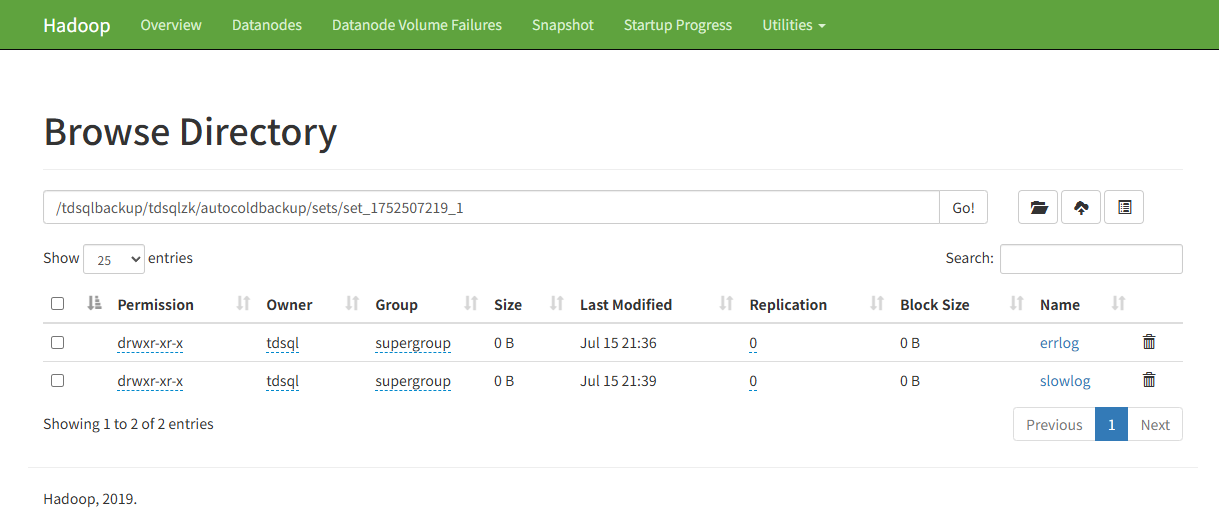
- 在 hdfs 集群下查看 /tdsqlbackup 路径
用
tdsql 用户执行以下命令
su - tdsql
#查看/tdsqlbackup目录是否已经被自动创建,权限是否如下
hadoop fs -ls /
如果目录不在或者权限不对,用下面命令修改:
hadoop fs -mkdir/tdsqlbackup
hadoop fs -chown tdsql.supergroup /tdsqlbackup
- 管理
HDFS集群
使用
tdsql 用户执行以下命令,查看所有namenode节点状态,及主备情况(只适用于高可用3节点架构)
hdfs haadmin -getAllServiceState
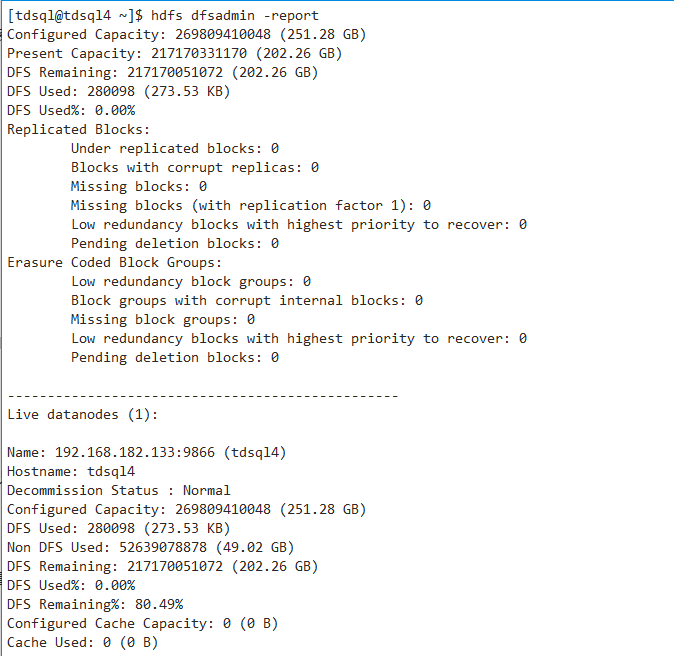
查看所有datanode节点的状态,及上报的容量情况
hdfs dfsadmin -report
- 检查进程
用
tdsql 用户执行
jps 命令,可以看到
hdfs 的进程名称
http://192.168.182.133:9870/dfshealth.html#tab-overview
7.2 安装 Kafka
- 检查 tdsql_hosts 文件
vim tdsql_hosts
# kafka机器地址,数量固定3台
[tdsql_kafka]
tdsql_kafka1 ansible_ssh_host=192.168.182.129
tdsql_kafka2 ansible_ssh_host=192.168.182.131
tdsql_kafka3 ansible_ssh_host=192.168.182.132
- 修改多源同步变量
修改
group_vars/all 中下面的相关变量
vim group_vars/all
tdsql_kafka_logdir: /data2/kafka,/data3/kafka,/data4/kafka   #kafka的日志文件路径,需要较大的磁盘空间
mkdir -p /data2/kafka
mkdir -p /data3/kafka
mkdir -p /data4/kafka
- 执行安装Kafka
ansible-playbook -i tdsql_hosts playbooks/tdsql_kafka.yml
- 验证是否安装成功
cd /data/application/kafka/logs
cat  server.log
后面的可选组件
Consumer、
ELK 的安装跟
HDFS 和
Kafka 类似,就不一一介绍了。
总体来说,通过
ansible 工具安装还是比较方便的,安装完后就是在赤兔页面进行数据库和组件的管理。
这里是《实战派K8S&DB》,更多干货敬请关注公众号。如果本文对你有所帮助,欢迎点赞、推荐和转发,也欢迎关注后续文章,一起考证、一起学习数据库技术。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/31444449/viewspace-3184569/ ,如需转载,请注明出处,否则将追究法律责任。

