一、分区裁剪的定义
说到分区裁剪(也称分区消除),自然离不开分区表。而分区表,其实质是采用化整为零的思想,将一个大对象,划分为若干个小的对象。当数据的访问,被限定在几个较小的对象,甚至只发生在1个小对象上时,其性能较未分区时,会得到极大的提升。因为这时所访问的数据量,只是原来的几分之一,几十分之一、几百分之一,甚至更少。当发生这种情况时,我们称之为分区裁剪(或分区消除)。
二、构建测试环境
下面我们先用样例,演示分区裁剪的作用,以及存储有同样内容的分区表和普通表,在不同条件下的资源开销情况:
我们创建一个分区表stu_part
这个分区表是用于存储学生信息的,其上共有四列:其中第一列stu_year,表示学生的入学年份;第二列是stu_no,表示学号,是5位序号。每年的新生,都从00001开始;第三列是stu_name,表示学生的姓名;第四列是stu_memo列,存储备注信息。该表按入学年份,即stu_year列进行了分区,分区的类型为列表分区。
create table stu_part (
stu_year varchar2(4),
stu_no varchar2(5) ,
stu_name varchar2(16),
stu_memo varchar2(2000))
partition by list(stu_year)
(partition p_2012 values('2012'),
partition p_2013 values('2013'),
partition p_2014 values('2014'),
partition p_2015 values('2015'),
partition p_2016 values('2016'));
再创建一个同样列信息的普通表:
create table stu_normal (
stu_year varchar2(4),
stu_no varchar2(5) ,
stu_name varchar2(16),
stu_memo varchar2(2000));
用如下SQL,向两个表中插入模拟数据
我们用如下SQL,向两个表中插入模拟数据。总共5000行数据,每个学年的学生人数为1000人。每个学年内,学号是不重复的,但整体来看,每个学号,都是5个重复值。
insert all
into stu_part (stu_year,stu_no,stu_name,stu_memo)
values (stu_year,stu_no,stu_name,stu_memo)
into stu_normal(stu_year,stu_no,stu_name,stu_memo)
values (stu_year,stu_no,stu_name,stu_memo)
select ceil(rownum/1000)+2011 stu_year,
lpad(case when mod(rownum,1000)=0 then 1000
else mod(rownum,1000) end,5,'0') stu_no,
dbms_random.string('u',15) stu_name,
rpad(rownum,2000,'*') stu_memo
from dual
connect by rownum<=5000;
commit;
执行上述操作后,分区表stu_part 和普通表stu_normal中拥有了完全相同的数据。
在分区表和普通表查询入学年份
我们使用如下的SQL,分别在分区表stu_part 和普通表stu_normal查询入学年份为2015年,学号为00001的学生姓名:
分区表查询用SQL:
Select /*+ gather_plan_statistics */ stu_name
from stu_part
where stu_year='2015'
and stu_no='00001';
非分区表查询用SQL:
Select /*+ gather_plan_statistics */ stu_name
from stu_normal
where stu_year='2015'
and stu_no='00001';
我们这里采用了加gather_plan_statistics 提示的方法来执行,并在执行后,在同一个会话窗口中,立即通过dbms_xplan.display_cursor()的方法来获取相应的执行计划及每一步的逻辑读消耗。
--在分区表上执行后,得到的执行计划和运行统计信息如下:
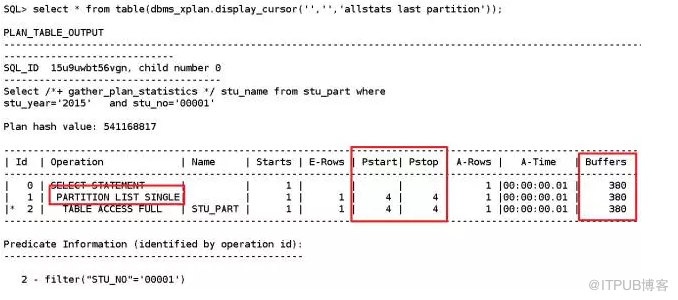
如上图所示,我们可以看到只访问了第4个分区,整个执行下来,消耗的逻辑读是380个块次。
--在普通表上执行后,得到的执行计划和运行统计信息如下:
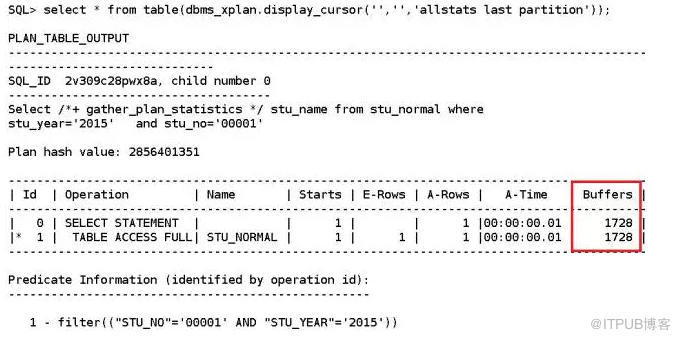
如上图所示,对于普通表的访问,虽然同样是全表扫描,但由于这里的全表扫描,是要对5000行数据的全扫,所以,逻辑读是1728个。而对于分区表的全表扫描,由于只发生在其中的一个分区上,是对1000行数据的全表扫描。因此,这时,发生了分区裁剪的分区表上的资源开销是更小的。
--下面,我们再看一下当把分区键的条件,从WHERE子句中去除后,又会是什么样的情况
。
分区表查询用SQL:
Select /*+ gather_plan_statistics */ stu_name
from stu_part
where stu_no='00001';
非分区表查询用SQL:
Select /*+ gather_plan_statistics */ stu_name
from stu_normal
where stu_no='00001';
--在分区表上执行后,得到的执行计划和运行统计信息如下:
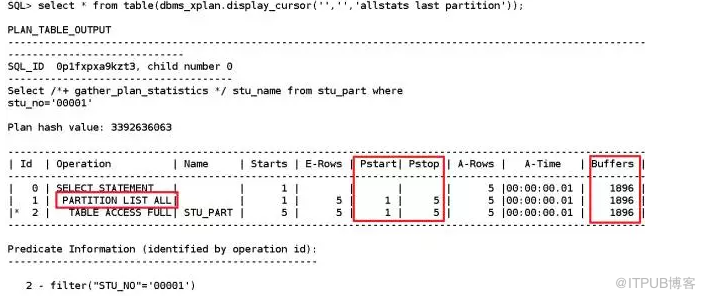
从上图可见,
由于去除了分区键列条件
,造成对分区表的扫描是要访问所有分区,即全部5个分区都要扫描。可以看到此时的逻辑读消耗是1896个块次。
--在普通表上执行后,得到的执行计划和运行统计信息如下:
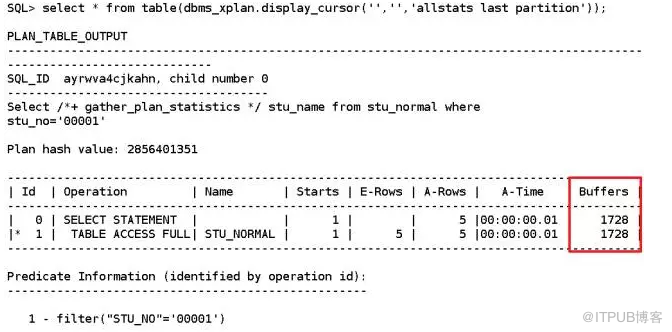
从上图可知,仍然是全表扫描。 与未去除分区键列条件时的情况是一样的 。逻辑读的开销仍然是1728个块次。但是,我们可以看到,这里, 由于分区表要访问所有的分区,其逻辑读的开销是1896个,是高于同样数据量的普通表的访问开销的。
--再进一步,如果我们在stu_no学号列上,创建索引后,又会是什么情况呢?
在分区表的STU_NO列上创建本地分区索引:
CREATE INDEX IND_STU_PART_NO_LOCAL ON STU_PART(STU_NO)
LOCAL
;
在普通表的STU_NO列上创建索引:
CREATE INDEX IND_STU_NORMAL_NO ON STU_NORMAL(STU_NO) ;
--我们先来看看
有分区键列条件时的情况
:
--在分区表上执行后,得到的执行计划和运行统计信息如下:
Select /*+ gather_plan_statistics */ stu_name
from stu_part
where stu_year='2015'
and stu_no='00001';
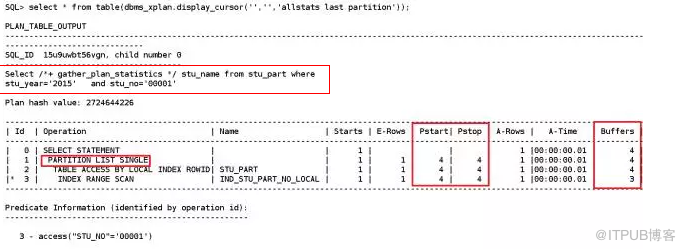
如上图所示,只访问了单个分区(即第4个分区)。而且,不仅只访问了分区表上的第4个分区,而且,也只访问了5个本地分区索引中的第4个。即在分区表和分区索引上,都发生了分区裁剪。由于上述原因,逻辑读的开销大幅下降到只有4个块次了。
--在普通表上执行后,得到的执行计划和运行统计信息如下:
Select /*+ gather_plan_statistics */ stu_name
from stu_normal
where stu_year='2015'
and stu_no='00001';
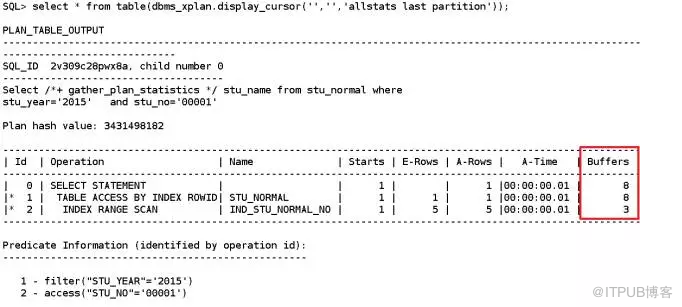
如上图所示,这里采取了对
普通表上的STU_NO列上的索引的范围扫描
。其逻辑读的开销是8个块次。
较前面分区的逻辑读开销要大,但同时要比之前未建索引走全表扫描的普通表的执行计划的开销要小。
--我们再来看看无分区键列条件时的情况:
--在分区表上执行后,得到的执行计划和运行统计信息如下:
Select /*+ gather_plan_statistics */ stu_name
from stu_part
where stu_no='00001';
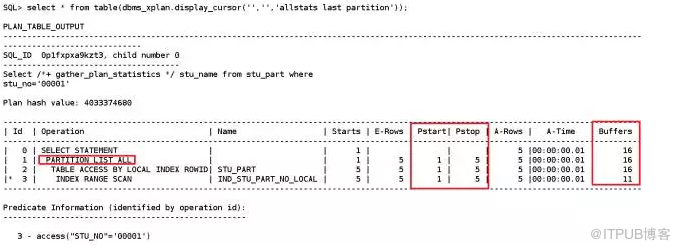
如上图所示,由于
没有了分区键列条件的限制
,需要对全部分区进行扫描。即先对
5个本地分区的索引进行扫描
,根据得到的满足学号条件的记录的ROWID,再回表去获取STU_NAME列的数据并返回。所以,对分区表也是全部5个分区都访问到了。其逻辑读的全部开销是16个块次。
--在普通表上执行后,得到的执行计划和运行统计信息如下:
Select /*+ gather_plan_statistics */ stu_name
from stu_normal
where stu_no='00001';
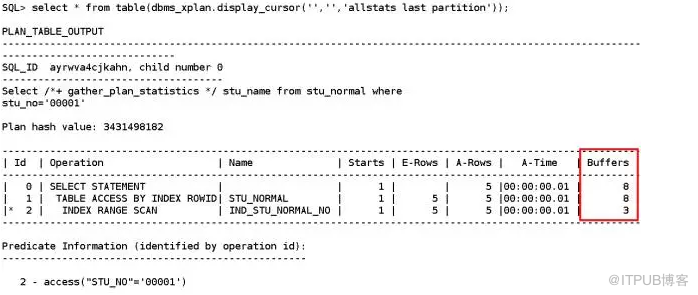
如上图所示,其结果 与未去除分区键列条件时的情况是一样 的。逻辑读的开销是8个块次。 相较于前面分区表的开销,分区表的开销更大。
通过上面的测试
,我们可以得到一个结论:当
未发生分区裁剪时
(即所有分区均要访问时),其资源开销要高于同样行数的普通表和普通索引。
--那么,如果在分区表的STU_NO列上,创建一个
非分区索引
,还会有分区裁剪的作用吗?
我们继续通过实验来寻找答案。
首先,我们在STU_NO列上创建非分区索引。由于此前已经在该列上创建过本地分区索引,所以,需要先把该索引删除后,才能创建同一列上的非分区索引。
DROP INDEX IND_STU_PART_NO_LOCAL;
CREATE INDEX IND_STU_PART_NO_
GLOBAL
ON STU_PART(STU_NO);
然后执行带
分区键列条件的SQ
L,得到如下的执行计划和运行统计信息:
Select /*+ gather_plan_statistics */ stu_name
from stu_part
where stu_year=2015 --注意是数值型
and stu_no='00001';
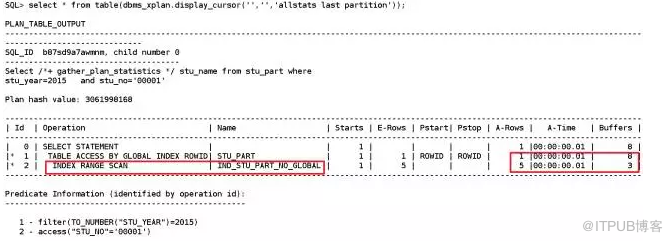
如上图中红框中内容所示,我们可知,该SQL的执行顺序是先通过索引IND_STU_PART_NO_GLOBAL找到5条学号为00001的记录(对应执行计划中ID为2的步骤)。由于最终查询结果是学生姓名,且还要满足SUT_YEAR=2015这个条件,而这两列并未在索引中出现,所以,需要通过索引中存储的,对应记录的ROWID回表,从表中获取相应5 行记录的这两列,并使用STU_YEAR列,过滤出等于2015的记录(对应执行计划中ID为1的步骤)。
同时,我们可以看到ID为2的步骤,发生了3个块次的逻辑读。通过前面的数据构建,我们可知,会有5条学号为00001的记录。所以,通过索引,我们可以找到5条索引键值为00001的索引记录,并得到这5条记录的ROWID。在ID为1的步骤,通过这5个ROWID,直接访问对应的5个数据块。因为这5条记录,是属于不同的入学年份,所以,一定是在不同的5个分区中,因此,一定是5个数据块。此外,通过下面的操作,我们也可以验证这5条记录,确实属于不同的数据块:
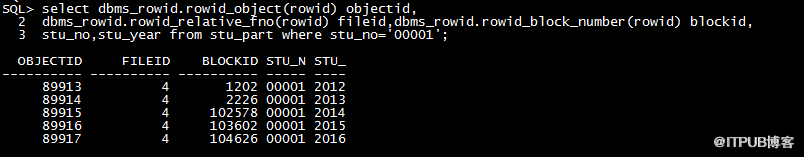
加上上一步中消耗的3个块次逻辑读,至此,总共消耗了8(3+5)个块次的逻辑读。
细心的,或者是有经验的同学,一定发现了我这次执行的查询中,由于在分区键列条件中传入的值的
数据类型(数值型)与分区键列的数据类型(字符型)不一致
,从而发生了
隐式转换
,并造成了分区键并未发挥出分区裁剪的作用。这一点,可以从执行计划中谓词信息中确认。如下图中红框所示:
Select /*+ gather_plan_statistics */ stu_name
from stu_part
where stu_year='2015' --注意是字符型
and stu_no='00001';
但考虑到这里访问
的是
非分区索引
,且
索引列上也没有分区键列
,这个分区键列应该发挥不出什么作用。
但我们实际验证后,发现情况不是我们想的那样了。如下图所示:
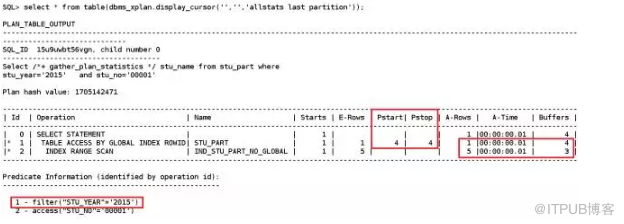
从上图中,我们可以发现,
在ID为2的那一步,与之前没有区别,仍是访问同样的索引,消耗的逻辑读仍是3
。但ID为1的那一步,显示至此步止,共发生了4个块次的逻辑读。减去其上一步的3个块次的逻辑读,实际这一步,只发生了一个块次的逻辑读。相比于此前的写法,整整少了4个。
其原因应该是由于我们这次的写法,没有在分区键列上发生隐式转换,使得分区键列发挥了作用
(这一点,从Pstart和Pstop列中的数值4,也可以证明,在这次执行过程中,只访问了第4个分区。)。
但是我的
执行计划的第一步是访问一个非分区的索引
,获得了5条学号为00001的记录的ROWID,由于还要用STU_YEAR列上的条件进一步过滤,以及要获取STU_NAME列上的值,所以,需要通过ROWID回表,去获取这两列上的值,并进行过滤。
但回表这一步只访问了一个数据块,也就是说,ORACLE一定是通过某种方法,知道这五行记录中只有一行是需要回表的
。
那么它又是如何做到的呢?
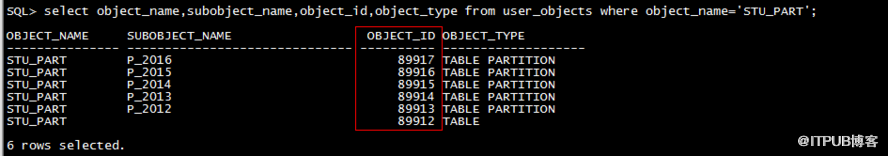
经过思考,其实,由于不同的分区有不同的对象号(OBJECT_ID)。如下图所示:
而
ROWID又是由对象号、文件号、块号和块内行号所组成的
。所以,在进行这一步操作时,根据条件,数据库就知道只有这个分区内的数据才可能满足这个条件。通过数据字典,还可以知道这个分区的对象ID,从获取到的5个ROWID中,可以解析出相应的对象ID。
所以,属于另外4个分区的ROWID是没有必要回表访问的
。这也就造成索引虽然返回了5个ROWID,但只有其中1个ROWID才是可能满足条件的,才是需要回表的。因此,也就发生了我们前边看到的,在这一步中,只发生了1个块次的逻辑读。
结论
综上,我们可以认识到,在分区表上,通过访问
非分区索引
回表时,
分区键列条件
依然
有
分区裁剪
的作用
,可以明显减少数据访问的开销。
对“分区裁剪”作用的“新”认知
即使访问的是一个分区表上的
非分区索引
,在SQL的WHERE条件中
限定分区条件
,在通过索引回表时,
也是可以发挥出“分区裁剪”的作用的。
强化SQL编码指导原则
对于分区表,我们在编写SQL时,要尽可能地把分区键列上的条件带上,并正确书写,即避免在分区键列上进行函数或算术运算,避免出现数据类型不一致等可能造成分区键列失效的情况。这对于充分发挥分区表上的分区裁剪作用,提升SQL性能是大有裨益的。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/31397003/viewspace-2145124/ ,如需转载,请注明出处,否则将追究法律责任。

