这里是维基百科对网络爬虫的词条页面。网络爬虫以叫网络蜘蛛,网络机器人,这是一个程序,其会自动的通过网络抓取互联网上的网页,这种技术一般可能用来检查你的站点上所有的链接是否是都是有效的。当然,更为高级的技术是把网页中的相关数据保存下来,可以成为搜索引擎。
从技相来说,实现抓取网页可能并不是一件很困难的事情,困难的事情是对网页的分析和整理,那是一件需要有轻量智能,需要大量数学计算的程序才能做的事情。下面一个简单的流程:
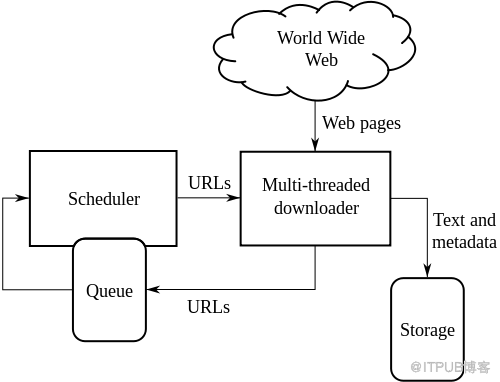
在这里,我们只是说一下如何写一个网页抓取程序。
首先我们先看一下,如何使用命令行的方式来找开网页。
telnet somesite.com 80
GET /index.html HTTP/1.0
按回车两次
使用telnet就是告诉你其实这是一个socket的技术,并且使用HTTP的协议,如GET方法来获得网页,当然,接下来的事你就需要解析HTML文法,甚至还需要解析Javascript,因为现在的网页使用Ajax的越来越多了,而很多网页内容都是通过Ajax技术加载的,因为,只是简单地解析HTML文件在未来会远远不够。当然,在这里,只是展示一个非常简单的抓取,简单到只能做为一个例子,下面这个示例的伪代码:
取网页
for each 链接 in 当前网页所有的链接
{
if(如果本链接是我们想要的 || 这个链接从未访问过)
{
处理对本链接
把本链接设置为已访问
}
}
require “rubygems”
require “mechanize”
class Crawler < WWW::Mechanize
attr_accessor :callback
INDEX = 0
DOWNLOAD = 1
PASS = 2
def initialize
super
init
@first = true
self.user_agent_alias = “Windows IE 6″
end
def init
@visited = []
end
def remember(link)
@visited << link
end
def perform_index(link)
self.get(link)
if(self.page.class.to_s == “WWW::Mechanize::Page”)
links = self.page.links.map {|link| link.href } - @visited
links.each do |alink|
start(alink)
end
end
end
def start(link)
return if link.nil?
if(!@visited.include?(link))
action = @callback.call(link)
if(@first)
@first = false
perform_index(link)
end
case action
when INDEX
perform_index(link)
when DOWNLOAD
self.get(link).save_as(File.basename(link))
when PASS
puts “passing on #{link}”
end
end
end
def get(site)
begin
puts “getting #{site}”
@visited << site
super(site)
rescue
puts “error getting #{site}”
end
end
end
上面的代码就不必多说了,大家可以去试试。下面是如何使用上面的代码:
require “crawler”
x = Crawler.new
callback = lambda do |link|
if(link =~/\\.(zip|rar|gz|pdf|doc)
x.remember(link)
return Crawler::PASS
elsif(link =~/\\.(jpg|jpeg)/)
return Crawler::DOWNLOAD
end
return Crawler::INDEX;
end
x.callback = callback
x.start(”http://somesite.com”)
下面是一些和网络爬虫相关的开源网络项目
arachnode.net is a .NET crawler written in C# using SQL 2005 and Lucene and is released under the GNU General Public License.
DataparkSearch is a crawler and search engine released under the GNU General Public License.
GNU Wget is a command-line-operated crawler written in C and released under the GPL. It is typically used to mirror Web and FTP sites.
GRUB is an open source distributed search crawler that Wikia Search ( http://wikiasearch.com ) uses to crawl the web.
Heritrix is the Internet Archive’s archival-quality crawler, designed for archiving periodic snapshots of a large portion of the Web. It was written in Java.
ht://Dig includes a Web crawler in its indexing engine.
HTTrack uses a Web crawler to create a mirror of a web site for off-line viewing. It is written in C and released under the GPL.
ICDL Crawler is a cross-platform web crawler written in C++ and intended to crawl Web sites based on
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/31365439/viewspace-2677454/ ,如需转载,请注明出处,否则将追究法律责任。

