目标:
1、了解有哪些组函数
2、学会使用组函数
3、学会使用GROUP BY子句
4、学会使用HAVING子句
Agenda:
一、介绍组函数
---类型和语法
---使用AVG、SUM、MIN、MAX、COUNT
---使用DISTINCT关键字
---组函数中的NULL值
二、grouping rows
---GROUP BY子句
---HAVING子句
三、组函数的嵌套
一、介绍组函数
组函数:在多行中操作从而得到一个结果
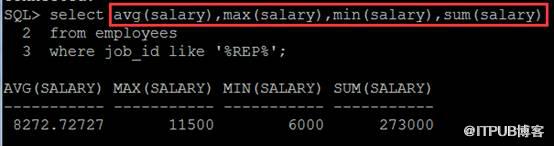
AVG ---> 求平均值
COUNT ---> 计数
MAX ---> 取最大值,既可以针对数值型,也可以针对日期型
MIN ---> 取最小值,既可以针对数值型,也可以针对日期型
STDDEV ---> 取标准方差
SUM ---> 取总和
VARIANCE ---> 方差
语法
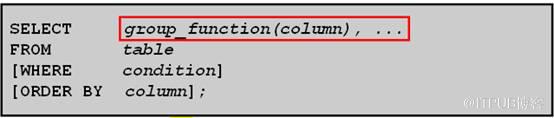
注意:
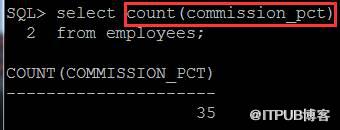
1、组函数不包括NULL值,遇到NULL值会抛弃掉,只计算非NULL值
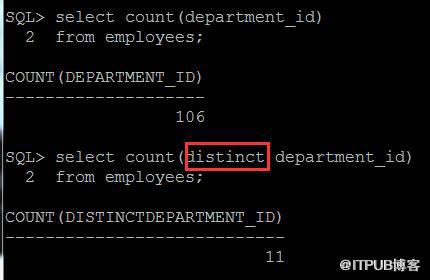
2、计算重复行加ALL,不计算重复行加DISTINCT,即“DISTINCT
column”,默认是计算
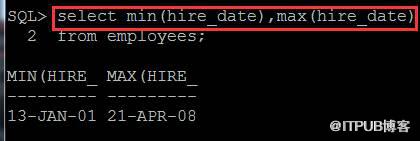
MIN和MAX针对日期型,示例:
COUNT:计数
示例:计算employees有多少行
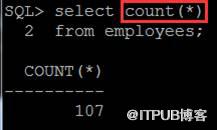
或者:
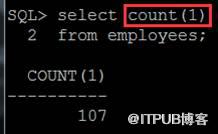
COUNT语法 ---> COUNT(expr):计算出符合这个表达式所有非空行的行数
示例:
DISTINCT关键字:不计算重复行
示例:
组函数对NULL值的处理
组函数通常情况下会忽略包含NULL值的行
示例:
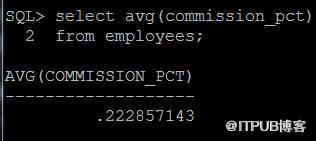
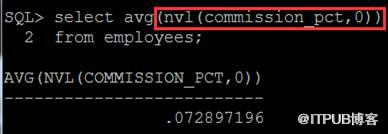
不计算带有NULL值的行
若想计算带有NULL值的行的话,需要NVL函数:
二、grouping rows
GROUP BY子句:把表分配成更小的组
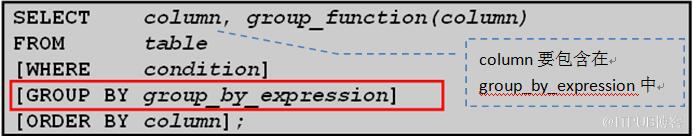
注意:1、在WHERE和GROUP BY中不可以使用别名,ORDER BY可以使用别名
2、WHERE和GROUP BY放一起先执行WHERE
3、通常按某一列执行GROUP BY的时候,这一列也写在SELECT中
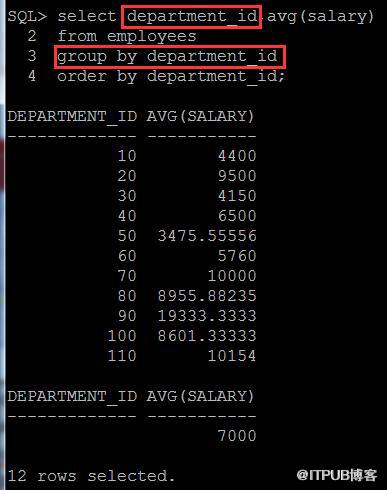
示例:列出部门分组,并把每个部门的平均薪资
注意:如果SELECT查询的列不在组函数中,那么它一定要包含在GROUP BY子句中
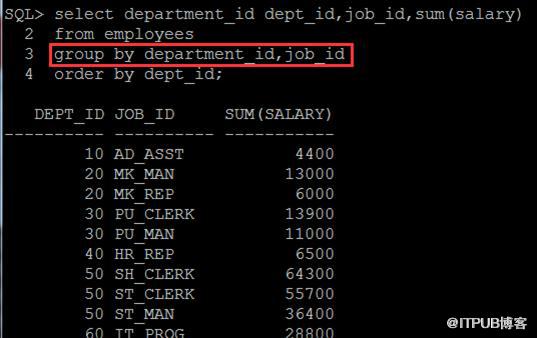
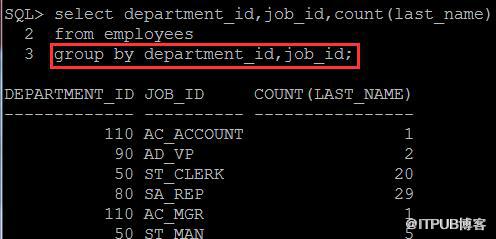
GROUP BY和更高级应用:对多列进行分组
比如第一次按部门分组,第二次按岗位分组,然后在进行求平均值等等
示例:
使用组函数的常见错误
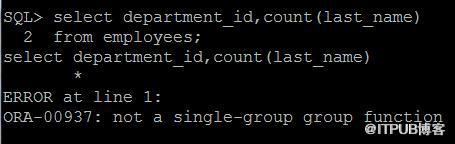
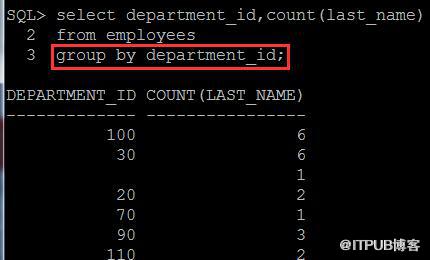
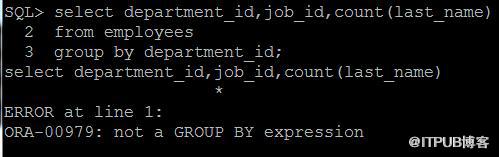
如果SELECT子句列表中有组函数,但是在组函数以外还有其他column,那么这些column需要放在GROUP BY子句中(通用规则)
示例1:
错误的:
正确的:
示例2:
错误的:
正确的:
示例3:
错误的:
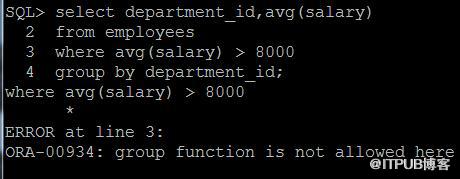
WHERE子句中不能使用组函数
正确的:引入HAVING子句
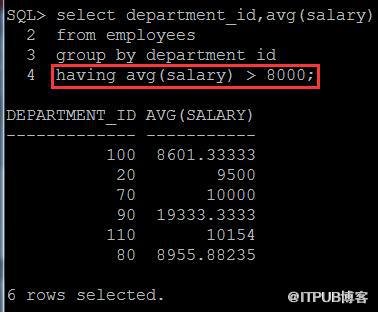
HAVING子句:对分组的表再进行限制
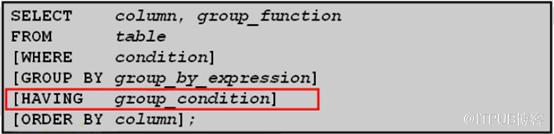
先执行GROUP BY子句,然后再执行“group_function”,接着再执行HAVING子句
示例:
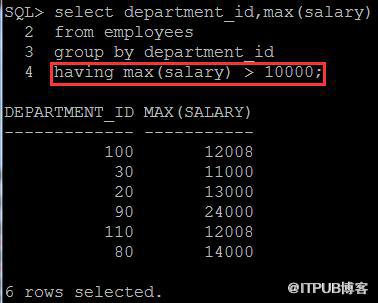
示例:
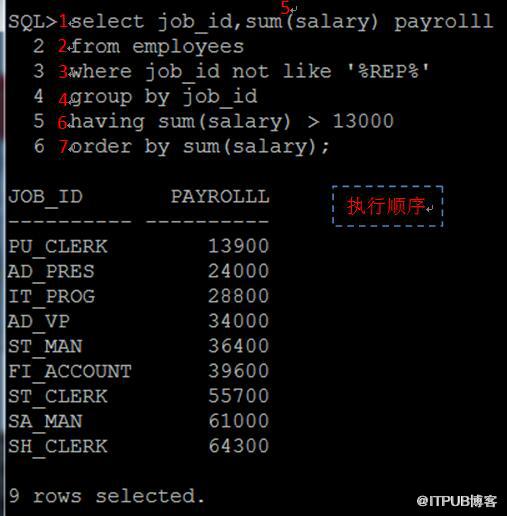
三、组函数的嵌套
示例:

来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/30197839/viewspace-1974345/ ,如需转载,请注明出处,否则将追究法律责任。

