如何主动避免问题发生及做好诊断信息的收集
有些问题是无法预见的,但大部分其它的问题如果及早发现一些征兆其实是可以避免的。同时,如果问题确实发生了,那么收集问题发生时的信息就非常重要。有关于如何主动避免问题及诊断信息的收集.
对于数据库整体的性能问题,AWR的报告是一个非常有用的诊断工具。
一般来说,当检测到性能问题时,我们会收集覆盖了发生问题的时间段的AWR报告-但是最好只收集覆盖1个小时时间段的AWR报告-如果时间过长,那么AWR报告就不能很好的反映出问题所在。还应该收集一份没有性能问题的时间段的AWR报告,作为一个参照物来对比有问题的时间段的AWR报告。这两个AWR报告的时间段应该是一致的,比如都是半个小时的,或者都是一个小时的。
Interpretation
在处理性能问题时,我们最关注的是数据库正在等待什么。
当进程因为某些原因不能进行操作时,它需要等待。花费时间最多的等待事件是我们最需要关注的,因为降低它,我们能够获得最大的好处。
AWR报告中的"Top 5 Timed Events"部分就提供了这样的信息,可以让我们只关注主要的问题。
-
Top 5 Timed Events
正如前面提到的,"Top 5 Timed Events"是AWR报告中最重要的部分。它指出了数据库的sessions花费时间最多的等待事件,如下:
Top 5 Timed Events                                         Avg %Total

~~~~~~~~~~~~~~~~~~                                        wait   Call

Event                                 Waits    Time (s)   (ms)   Time Wait Class

------------------------------ ------------ ----------- ------ ------ ----------

db file scattered read           10,152,564      81,327      8   29.6   User I/O

db file sequential read          10,327,231      75,878      7   27.6   User I/O

CPU time                                         56,207          20.5

read by other session             4,397,330      33,455      8   12.2   User I/O

PX Deq Credit: send blkd             31,398      26,576    846    9.7      Other

         -------------------------------------------------------------
Top 5 Events部分包含了一些跟Events(事件)相关的信息。它记录了这期间遇到的等待的总次数,等待所花费的总时间,每次等待的平均时间;这一部分是按照每个Event占总体call time的百分比来进行排序的。
根 据Top 5 Events部分的信息的不同,接下来我们需要检查AWR报告的其他部分,来验证发现的问题或者做定量分析。等待事件需要根据报告期的持续时间和当时数据 库中的并发用户数进行评估。如:10分钟内1000万次的等待事件比10个小时内的1000万等待更有问题;10个用户引起的1000万次的等待事件比 10,000个用户引起的相同的等待要更有问题。
就像上面的例子,将近60%的时间是在等待IO相关的事件。
- 事件"db file scattered read"一般表明正在做由全表扫描或者index fast full scan引起的多块读。
- 事件"db file sequential read"一般是由不能做多块读的操作引起的单块读(如读索引)
其他20%的时间是花在使用或等待CPU time上。过高的CPU使用经常是性能不佳的SQL引起的(或者这些SQL有可能用更少的资源完成同样的操作);对于这样的SQL,过多的IO操作也是一个症状。关于CPU使用方面,我们会在之后讨论。
在以上基础上,我们将调查是否这个等待事件是有问题的。若有问题,解决它;若是正常的,检查下个等待事件。
过多的IO相关的等待一般会有两个主要的原因:
- 数据库做了太多的读操作
- 每次的IO读操作都很慢
-
是否数据库做了大量的读操作:
上面的图显示了在这段时间里两类读操作都分别大于1000万,这些操作是否过多取决于报告的时间是1小时或1分钟。我们可以检查AWR报告的elapsed time如果这些读操作确实是太多了,接下来我们需要检查AWR报告中 SQL Statistics 部分的信息,因为读操作都是由SQL语句发起的。 -
是否是每次的IO读操作都很慢:
上面的图显示了在这段时间里两类读操作平均的等待时间是小于8ms的
至于8ms是快还是慢取决于底层的硬件设备;一般来讲小于20ms的都可以认为是可以接受的。
我们还可以在AWR报告"Tablespace IO Stats"部分得到更详细的信息
Tablespace IO Stats                       DB/Inst: VMWREP/VMWREP  Snaps: 1-15

-> ordered by IOs (Reads + Writes) desc


Tablespace

------------------------------

                Av      Av     Av                       Av     Buffer Av Buf

        Reads Reads/s Rd(ms) Blks/Rd       Writes Writes/s      Waits Wt(ms)

-------------- ------- ------ ------- ------------ -------- ---------- ------

TS_TX_DATA

   14,246,367     283    7.6     4.6  145,263,880    2,883  3,844,161    8.3

USER

      204,834       4   10.7     1.0   17,849,021      354     15,249    9.8

UNDOTS1

       19,725       0    3.0     1.0   10,064,086      200      1,964    4.9

AE_TS

    4,287,567      85    5.4     6.7          932        0    465,793    3.7

TEMP

    2,022,883      40    0.0     5.8      878,049       17          0    0.0

UNDOTS3

    1,310,493      26    4.6     1.0      941,675       19         43    0.0

TS_TX_IDX

    1,884,478      37    7.3     1.0       23,695        0     73,703    8.3

>SYSAUX

      346,094       7    5.6     3.9      112,744        2          0    0.0

SYSTEM

     101,771       2    7.9     3.5       25,098        0        653    2.7
如上图,我们关心Av Rd(ms)的指标。如果它高于20ms并且同时有很多读操作的,我们可能要开始从OS的角度调查是否有潜在的IO问题。
注:对于一些比较空闲的tablespace/files,我们可能会得到一个比较大的Av Rd(ms)值;对于这样的情况,我们应该忽略这样的tablespace/files;因为这个很大的值可能是由于硬盘自旋(spin)引起的,没有太大的参考意义。比如对
于一个有1000万次读操作而且很慢的系统,引起问题的基本不可能是一个只有10次read的tablespace/file.
虽 然高"db file scattered read"和"db file sequential read"等待可以是I / O相关的问题,但是很多时候这些等待也可能是正常的;实际上,对一个已经性能很好的数据库系统,这些等待事件往往在top 5等待事件里,因为这意味着您的数据库没有那些真正的“问题”。
诀窍是能够评估引起这些等待的语句是否使用了最优的访问路径。如果"db file scattered read"比较高,那么相关的SQL语句可能使用了全表扫描而没有使用索引(也许是没有创建索引,也许是没有合适的索引);相应的,如果"db file sequential read"过多,则表明也许是这些SQL语句使用了selectivity不高的索引从而导致访问了过多不必要的索引块或者使用了错误的索引。这些等待可 能说明SQL语句的执行计划不是最优的。
接下来就需要通过AWR来检查这些top SQL是否可以进一步的调优,我们可以查看AWR报告中 SQL Statistics 的部分.
上面的例子显示了20%的时间花在了等待或者使用CPU上,我们也需要检查 SQL statistics 部分来进一步的分析。
同样的,因为我们并没有看到latch相关的等待,latch在我们这个例子里并没有引发严重的性能问题;那么我们接下来就完全不需要分析latch相关的信息。
一 般来讲,如果数据库性能很慢,TOP 5等待事件里"CPU", "db file sequential read" 和"db file scattered read" 比较明显(不管它们之间的顺序如何),我们总是需要检查Top SQL (by logical and physical reads)部分;调用SQL Tuning Advisor或者手工调优这些SQL来确保它们是有效率的运行。 -
SQL Statistics
AWR包含了一些不同的SQL统计值:
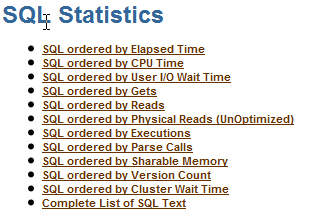
根据Top 5 部分的Top Wait Event不同,我们需要检查不同的SQL statistic。
在我们这个例子里,Top Wait Event是"db file scattered read","db file sequential read"和CPU;我们最需要关心的是SQL ordered by CPU Time, Gets and Reads。
我们会从"SQL ordered by gets"入手,因为引起高buffer gets的SQL语句一般是需要调优的对象。
SQL ordered by Gets

-> Resources reported for PL/SQL code includes the resources used by all SQL

  statements called by the code.

-> Total Buffer Gets:   4,745,943,815

-> Captured SQL account for     122.2% of Total


                               Gets              CPU     Elapsed

 Buffer Gets   Executions    per Exec   %Total Time (s)  Time (s)    SQL Id

-------------- ------------ ------------ ------ -------- --------- -------------

1,228,753,877          168  7,314,011.2   25.9  8022.46   8404.73 5t1y1nvmwp2

SELECT ADDRESSID",CURRENT$."ADDRESSTYPEID",CURRENT$URRENT$."ADDRESS3",

CURRENT$."CITY",CURRENT$."ZIP",CURRENT$."STATE",CURRENT$."PHONECOUNTRYCODE",

CURRENT$."PHONENUMBER",CURRENT$."PHONEEXTENSION",CURRENT$."FAXCOU


1,039,875,759   62,959,363         16.5   21.9  5320.27   5618.96 grr4mg7ms81


Module: DBMS_SCHEDULER


INSERT INTO "ADDRESS_RDONLY" ("ADDRESSID","ADDRESSTYPEID","CUSTOMERID","
ADDRESS1","ADDRESS2","ADDRESS3","CITY","ZIP","STATE","PHONECOUNTRYCODE","PHONENU

   854,035,223          168  5,083,543.0   18.0  5713.50   7458.95 4at7cbx8hnz

SELECT "CUSTOMERID",CURRENT$."ISACTIVE",CURRENT$."FIRSTNAME",CURRENT$."LASTNAME",CU<
RRENT$."ORGANIZATION",CURRENT$."DATEREGISTERED",CURRENT$."CUSTOMERSTATUSID",CURR
ENT$."LASTMODIFIEDDATE",CURRENT$."SOURCE",CURRENT$."EMPLOYEEDEPT",CURRENT$.
对这些Top SQL,可以手工调优,也可以调用SQL Tuning Advisor。
分析:
-
-> Total Buffer Gets: 4,745,943,815
假设这是一个一个小时的AWR报告,4,745,943,815是一个很大的值;所以需要进一步分析这个SQL是否使用了最优的执行计划 -
Individual Buffer Gets
上面的例子里单个的SQL的buffer get非常多,最少的那个都是8亿5千万。这三个SQL指向了两个不同的引起过多buffers的原因:
-
单次执行buffer gets过多
SQL_ID为'5t1y1nvmwp2'和'4at7cbx8hnz'的SQL语句总共被执行了168次,但是每次执行引起的buffer gets超过500万。这两个SQL应该是主要的需要调优的候选者。 -
执行次数过多
SQL_ID 'grr4mg7ms81' 每次执行只是引起16次buffer gets,减少这条SQL每次执行的buffer get可能并不能显著减少总共的buffer gets。这条语句的问题是它执行的太频繁了,6500万次。
改变这条SQL的执行次数可能会更有意义。这个SQL看起来是在一个循环里面被调用,如果可以让它一次处理的数据更多也许可以减少它执行的次数。
-
单次执行buffer gets过多
Other SQL Statistic Sections
就像之前提到的那样,AWR报告中有很多不同的部分用来分析各种不同的问题。如果特定的问题并没有出现,那么分析AWR报告的这些部分并不能有很大的帮助。
下面提到了一些可能的问题:
- Waits for 'Cursor: mutex/pin' 如 果发现了一些像"Cursor: pin S wait on X" 或"Cursor: mutex X" 类的mutex等待,那么可能是由于parsing引起的问题。检查"SQL ordered by Parse Calls" 和"SQL ordered by Version Count"部分的Top SQL,这些SQL可能引起这类的问题。
-
-> Total Buffer Gets: 4,745,943,815
-
Load Profile
根据Top 5等待事件的不同,"Load Profile"可以提供一些有用的背景资料或潜在问题的细节信息。Load Profile ~~~~~~~~~~~~ Per Second Per Transaction --------------- --------------- Redo size: 4,585,414.80 3,165,883.14 Logical reads: 94,185.63 65,028.07 Block changes: 40,028.57 27,636.71 Physical reads: 2,206.12 1,523.16 Physical writes: 3,939.97 2,720.25 User calls: 50.08 34.58 Parses: 26.96 18.61 Hard parses: 1.49 1.03 Sorts: 18.36 12.68 Logons: 0.13 0.09 Executes: 4,925.89 3,400.96 Transactions: 1.45 % Blocks changed per Read: 42.50 Recursive Call %: 99.19 Rollback per transaction %: 59.69 Rows per Sort: 1922.64
在这个例子里,Top 5 Events部分显示问题可能跟SQL的执行有关,那么我们接下来检查load profile部分。
如果您检查AWR report是为了一般性的性能调优,那么可以看到有比较多的redo activity和比较高的physical writes. Physical writes比physical read要高,并且有42%的块被更改了.
此外,hard parse的次数要少于soft parse.
如果mutex等待事件比较严重,如"library cache: mutex X",那么查看所有parse的比率会更有用。
当然,如果把Load Profile部分跟正常时候的AWR报告做比较会更有用,比如,比较redo size, users calls, 和 parsing这些性能指标。 -
Instance Efficiency
Instance Efficiency部分更适用于一般性的调优,而不是解决某个具体问题(除非等待事件直接指向这些指标)。
Instance Efficiency Percentages (Target 100%)

~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~

           Buffer Nowait %:   99.91       Redo NoWait %:  100.00

           Buffer  Hit   %:   98.14    In-memory Sort %:   99.98

           Library Hit   %:   99.91        Soft Parse %:   94.48

        Execute to Parse %:   99.45         Latch Hit %:   99.97

Parse CPU to Parse Elapsd %:   71.23     % Non-Parse CPU:   99.00
从我们的这个例子来看,最有用的信息是%Non-Parse CPU,它表明几乎所有的CPU都消耗在了Execution而不是Parse上,所以调优SQL会对性能有改善。
94.48% 的soft parse比率显示hard parse的比例很小,这是可取的。Execute to Parse %很高,说明cursor被很好的重用了。我们总是期望这里的值都是接近100%,但是因为应用的不同,如果这个部分的参数的某些值很小,也是可以认为没 有问题的;如在数据仓库环境,hard parse因为使用了物化视图或histogram而变得很高。所以,重要的是,我们需要把这部分信息和正常时候的AWR报告做比较来判断是否有问题。 -
Latch Activity
在我们这个例子里,我们并没有看到很高的latch相关的等待,所以这部分的信息可以忽略。
但是如果latch相关的等待很严重,我们需要查看Latch Sleep Breakdown 部分sleeps很高的latch
Latch Sleep Breakdown


   * ordered by misses desc


Latch Name

----------------------------------------

 Get Requests      Misses      Sleeps  Spin Gets   Sleep1   Sleep2   Sleep3

-------------- ----------- ----------- ---------- -------- -------- --------

cache buffers chains

2,881,936,948 	 3,070,271      41,336  3,031,456        0        0        0

row cache objects

  941,375,571   1,215,395         852  1,214,606        0        0        0

object queue header operation

  763,607,977     949,376      30,484    919,782        0        0        0

cache buffers lru chain

  376,874,990     705,162       3,192    702,090        0        0        0
这 里top latch是cache buffers chains. Cache Buffers Chains latches是用来保护buffer caches中的buffers。在我们读取数据时,这个latch是正常需要获得的。Sleep的数字上升代表session在读取buffers时开 始等待这个latch。争用通常来自于不良的SQL要读取相同的buffers。
在我们这个例子里,虽然读取buffer的操作发生了 28亿次,但是只sleep了41,336次,可以认为是比较低的。Avg Slps/Miss(Sleeps/ Misses)也比较低。这表明当前Server有能力处理这样多的数据,所以没有发生Cache Buffers Chains latch的争用。
值得注意的wait events
-
CPU time events
CPU变为top wait event并不总是代表出现了问题。但是如果同时数据库性能比较慢,那么就需要进一步分析了。首先,检查AWR报告的“ SQL ordered by CPU Time ”部分,看是否某个特定的SQL使用了大量的CPU。
SQL ordered by CPU Time

-> Resources reported for PL/SQL code includes the resources used by all SQL

  statements called by the code.

-> % Total is the CPU Time divided into the Total CPU Time times 100

-> Total CPU Time (s):          56,207

-> Captured SQL account for      114.6% of Total


   CPU      Elapsed                  CPU per          % Total


 Time (s)   Time (s)  Executions     Exec (s) % Total DB Time SQL Id
---------- ---------- ------------ ----------- ------- ------- -------------

    20,349     24,884          168      121.12    36.2     9.1 7bbhgqykv3cm9
Module: DBMS_SCHEDULER
DECLARE job BINARY_INTEGER := :job; next_date TIMESTAMP WITH TIME ZONE := :myda
te; broken BOOLEAN := FALSE; job_name VARCHAR2(30) := :job_name; job_subname
VARCHAR2(30) := :job_subname; job_owner VARCHAR2(30) := :job_owner; job_start
TIMESTAMP WITH TIME ZONE := :job_start; job_scheduled_start TIMESTAMP WITH TIME
Analysis:
-
-> Total CPU Time (s): 56,207
它代表了15分钟的CPU time。但是这个数字是否有问题取决于整个报告的时间。 - Top SQL使用的CPU是 20,349秒(大概5分钟)
- 整个CPU时间占DB Time的9.1%
- 执行了168次,这个执行次数跟之前提到的几个SQL是一样的,说明这些SQL可能都是被同一个JOB调用的。
其他潜在的CPU相关的问题:
-
检查是否有其他等待事件与高CPU 事件同时出现
如cursor: pin S问题可能引起高CPU使用:
-
数据库以外的CPU使用率过高
如果一个数据库以外的进程使用了过多CPU,那么数据库进程能够获得的CPU就会减少,数据库性能就会受到影响。在这种情况下,运行OSWather或者其他的OS工具去发现是哪个进程使用了过多CPU
- 诊断CPU使用率 可以参考我已经写的《》文章。
-
-> Total CPU Time (s): 56,207
-
'Log file sync' waits
当 一个user session commit或rollback时,log writer进程会把redo从log buffer中写入redo logfile文件。AWR报告会帮助我们来确定是否存在这方面的问题,并且确认是否是由物理IO引起。 -
Buffer busy waits
当 一个session从buffer cache读取一个buffer时,如果这个buffer处于busy的状态(由于其它session正在向其中读取数据,或者是由于这个buffer被 其它的session以不兼容模式持有),那么这个session就会等待这个事件。
使用ADDM的报告
当分析性能问题时,除了AWR报告,我们还可以同时参照ADDM报告,对于潜在的性能问题,它同时提供了具体的解决方案建议。
ADDM报告相比AWR报告来说,它提供了可读性更好的建议;当然应该同时参照ADDM报告和AWR报告来得到更准确地诊断。
Statspack
AWR报告取代了旧有的staspack及bstat/estat报告。
pxboracle@live.com
2014.09.03 09:30
share you knowledge with the world.
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/29734436/viewspace-1263815/ ,如需转载,请注明出处,否则将追究法律责任。

