kafka集群安装部署企业实战(zookeeper+kafka+生产者消费者验证)
1.1 Kafka介绍1.2 Kafka优势1.2.1 高吞吐量1.2.2 高性能1.2.3 持久化数据存储1.2.4 分布式系统1.2.5 可靠性1.2.6 客户端状态维护1.2.7 支持场景1.2.8 支持多种客户端语言1.3 Kafka应用场景1.3.1 日志收集1.3.2 消息系统1.3.3 用户活动跟踪1.3.4 运营指标1.3.5 流式处理1.4 Kafka基本架构1.4.1 消息和批次1.4.2 模式1.4.3 主题和分区1.4.4 生产者和消费者1.4.5 Broker和集群1.5 Kafka核心概念1.5.1 Producer1.5.2 Consumer1.5.3 Broker1.5.4 Topic1.5.5 Partition1.5.6 Replicas副本1.5.7 Offset1.5.7.1 生产者Offset1.5.7.2 消费者Offset1.5.8 副本1.5.8.1 AR1.5.8.2 ISR1.5.8.3 OSR1.5.8.4 HW1.5.8.5 LEO2.1 Kafka集群规划2.1.1 Zookeeper集群2.1.2 Kafka集群2.2 JDK部署(3台均需部署)2.3 Zookeeper集群部署2.3.1 安装Zookeeper2.3.2 修改Zookeeper配置文件2.3.2.1 Zookeeper配置文件详解2.3.3 创建Zookeeper集群myid2.3.4 启动Zookeeper集群2.3.5 查看Zookeeper集群状态2.3.6 故障排查2.3.6.1 若出现启动失败,可查看日志2.3.6.2 大多数的问题都是配置文件的问题2.4 Kafka集群部署2.4.1 安装Kafka2.4.2 修改Kafka配置文件2.4.2.1 Kafka配置文件详解2.4.2.1.1 server.properties:服务端的配置文件2.4.2.1.2 producer.properties:生产端的配置文件2.4.2.1.3 consumer.properties:消费端的配置文件2.4.3 启动Kafka集群2.4.3.1 启动Zookeeper集群2.4.3.1.1 查看Zookeeper集群状态2.4.3.1.2 启动Zookeeper集群2.4.3.2 启动Kafka集群2.4.4 测试验证2.4.4.1 创建Topic–test2.4.4.2 查看已经创建的Topic列表2.4.4.3 在master启动生产者(任意一台)2.4.4.4 在另外两台服务器其中之一启动消费者2.4.4.5 生产者的服务器输入内容,消费者服务器就会显示2.4.4.5.1 生产者2.4.4.5.2 消费者2.4.5 故障排查
1.1 Kafka介绍
Kafka是最初由Linkedin公司开发,是一个分布式、分区的、多副本的、多生产者、多订阅者,基于Zookeeper协调的分布式日志系统(也可以当做MQ系统),常见可以用于web/nginx日志、访问日志,消息服务等等,Linkedin于2010年贡献给了Apache基金会并成为顶级开源项目。
主要应用场景是:日志收集系统和消息系统。
Kafka主要设计目标如下:
以时间复杂度为O(1)的方式提供消息持久化能力,即使对TB级以上数据也能保证常数时间的访问性能;
高吞吐率,即使在非常廉价的商用机器上也能做到单机支持每秒10万条消息的传输;
支持Kafka Server间的消息分区,及分布式消费,同时保证每个Partition内的消息顺序传输;
同时支持离线数据处理和实时数据处理;
支持在线水平扩展。

有两种主要的消息传递模式:点对点传递模式、发布-订阅模式。大部分的消息系统选用发布-订阅模式。Kafka就是一种发布-订阅模式。
对于消息中间件,消息分推拉两种模式。Kafka只有消息的拉取,没有推送,可以通过轮询实现消息的推送。
Kafka在一个或多个可以跨越多个数据中心的服务器上作为集群运行;
Kafka集群中按照主题分类管理,一个主题可以有多个分区,一个分区可以有多个副本分区;
每个记录由一个键,一个值和一个时间戳组成。
Kafka具有四个核心API:
Producer API:允许应用程序将记录流发布到一个或多个Kafka主题;
Consumer API:允许应用程序订阅一个或多个主题并处理为其生成的记录流;
Streams API:允许应用程序充当流处理器,使用一个或多个主题的输入流,并生成一个或多个输出主题的输出流,从而有效地将输入流转换为输出流;
Connector API:允许构建和运行将Kafka主题连接到现有应用程序或数据系统的可重用生产者或使用者。例如,关系数据库的连接器可能会捕获对表的所有更改。
1.2 Kafka优势
1.2.1 高吞吐量
单机每秒处理几十上百万的消息量。即使存储了许多TB的消息,它也保持稳定的性能。
1.2.2 高性能
单节点支持上千个客户端,并保证零停机和零数据丢失。
1.2.3 持久化数据存储
将消息持久化到磁盘;通过将数据持久化到硬盘以及replication防止数据丢失。
零拷贝;
顺序读,顺序写;
利用Linux的页缓存。
1.2.4 分布式系统
易于向外扩展,所有的Producer、Broker和Consumer都会有多个,均为分布式的。无需停机即可扩展机器;多个Producer、Consumer可能是不同的应用。
1.2.5 可靠性
Kafka是分布式,分区,复制和容错的。
1.2.6 客户端状态维护
消息被处理的状态是在Consumer端维护,而不是由server端维护;当失败时能自动平衡。
1.2.7 支持场景
支持online(在线)和offline(离线)的场景
1.2.8 支持多种客户端语言
Kafka支持Java、.NET、PHP、Python等多种语言。
1.3 Kafka应用场景
1.3.1 日志收集
一个公司可以用Kafka收集各种服务的Log,通过Kafka以统一接口服务的方式开放给各种Consumer。
1.3.2 消息系统
解耦生产者和消费者、缓存消息等。
1.3.3 用户活动跟踪
Kafka经常被用来记录Web用户或者App用户的各种活动,如浏览网页、搜索、点击等活动,这些活动信息被各个服务器发布到Kafka的Topic中,然后消费者通过订阅这些Topic来做实时的监控分析,亦可保存到数据库。
1.3.4 运营指标
Kafka也经常用来记录运营监控数据;包括收集各种分布式应用的数据,生产各种操作的集中反馈,比如报警和报告。
1.3.5 流式处理
比如Spark Streaming和Storm。
1.4 Kafka基本架构
1.4.1 消息和批次
Kafka的数据单元称为消息;可以把消息看成是数据库里的一个“数据行”或一条“记录”,消息由字节数组组成。
消息有键,键也是一个字节数组;当消息以一种可控的方式写入不同的分区时,会用到键。
为了提高效率,消息被分批写入Kafka;批次就是一组消息,这些消息属于同一个主题和分区。
把消息分成批次可以减少网络开销;批次越大,单位时间内处理的消息就越多,单个消息的传输时间就越长,批次数据会被压缩,这样可以提升数据的传输和存储能力,但是需要更多的计算处理。
1.4.2 模式
消息模式(schema)有许多可用的选项;以便于理解,如JSON和XML,但是它们缺乏强类型处理能力。Kafka的许多开发者喜欢使用Apache Avro;Avro提供了一种紧凑的序列化格式,模式和消息体分开;当模式发生变化时,不需要重新生成代码;它还支持强类型和模式进化,其版本既向前兼容,也向后兼容。
数据格式的一致性对Kafka很重要,因为它消除了消息读写操作之间的耦合性。
1.4.3 主题和分区
Kafka的消息通过主题进行分类。主题可比做是数据库的表或者文件系统里的文件夹;主题可以被分为若干分区,一个主题通过分区分布于Kafka集群中,提供了横向扩展的能力。

1.4.4 生产者和消费者
生产者创建消息;消费者消费消息。一个消息被发布到一个特定的主题上。生产者在默认情况下把消息均衡地分布到主题的所有分区上:
直接指定消息的分区;
根据消息的key散列取模得出分区;
轮询指定分区。
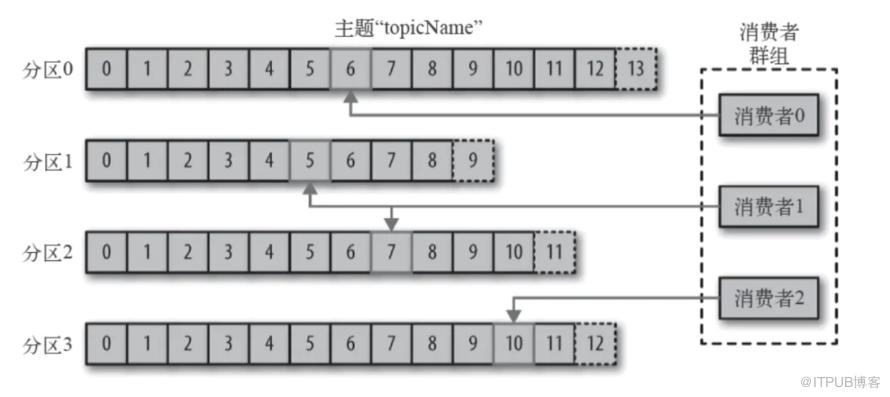
消费者通过偏移量来区分已经读过的消息,从而消费消息。消费者是消费组的一部分,消费组保证每个分区只能被一个消费者使用,避免重复消费。
1.4.5 Broker和集群
一个独立的Kafka服务器称为Broker。Broker接收来自生产者的消息,为消息设置偏移量,并提交消息到磁盘保存。Broker为消费者提供服务,对读取分区的请求做出响应,返回已经提交到磁盘上的消息。单个Broker可以轻松处理数千个分区以及每秒百万级的消息量。
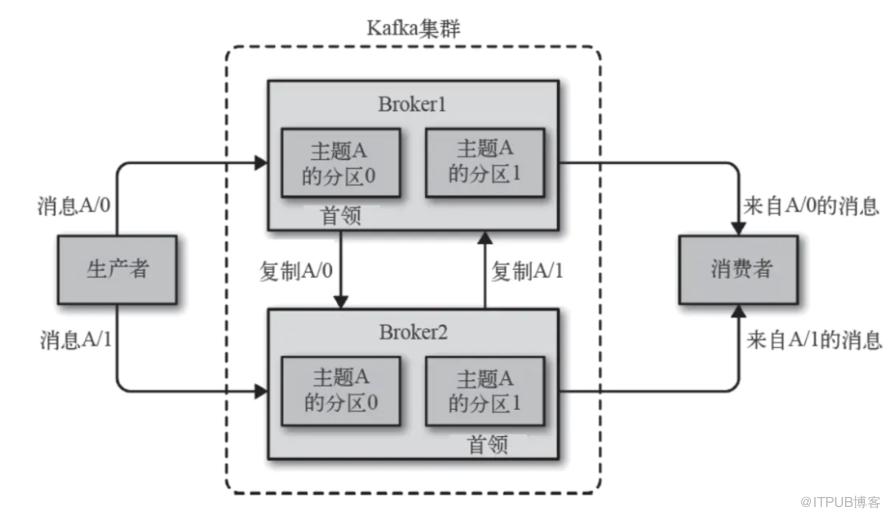
每个集群都有一个Broker是集群控制器(自动从集群的活跃成员中选举出来)。
控制器负责管理工作:
将分区分配给Broker;
监控Broker。
集群中一个分区属于一个Broker,该Broker称为分区首领。一个分区可以分配给多个Broker,此时会发生分区复制;分区的复制提供了消息冗余,高可用;副本分区不负责处理消息的读写。
1.5 Kafka核心概念
1.5.1 Producer
生产者创建消息。该角色将消息发布到Kafka的Topic中,Broker接收到生产者发送的消息后,Broker将该消息追加到当前用于追加数据的segment文件中;一般情况下,一个消息会被发布到一个特定的主题上。
默认情况下通过轮询把消息均衡地分布到主题的所有分区上;
在某些情况下,生产者会把消息直接写到指定的分区;这通常是通过消息键和分区器来实现的,分区器为键生成一个散列值,并将其映射到指定的分区上;这样可以保证包含同一个键的消息会被写到同一个分区上;
生产者也可以使用自定义的分区器,根据不同的业务规则将消息映射到分区。
1.5.2 Consumer
消费者读取消息。
消费者订阅一个或多个主题,并按照消息生成的顺序读取它们。
消费者通过检查消息的偏移量来区分已经读取过的消息;偏移量是另一种元数据,它是一个不断递增的整数值,在创建消息时,Kafka会把它添加到消息里;在给定的分区里,每个消息的偏移量都是唯一的;消费者把每个分区最后读取的消息偏移量保存在Zookeeper或Kafka上,如果消费者关闭或重启,它的读取状态不会丢失。
消费者是消费组的一部分;群组保证每个分区只能被一个消费者使用。
如果一个消费者失效,消费组里的其它消费者可以接管失效消费者的工作,再平衡,分区重新分配。

1.5.3 Broker
一个独立的Kafka服务器被称为Broker。Broker为消费者提供服务,对读取分区的请求作出响应,返回已经提交到磁盘上的消息。
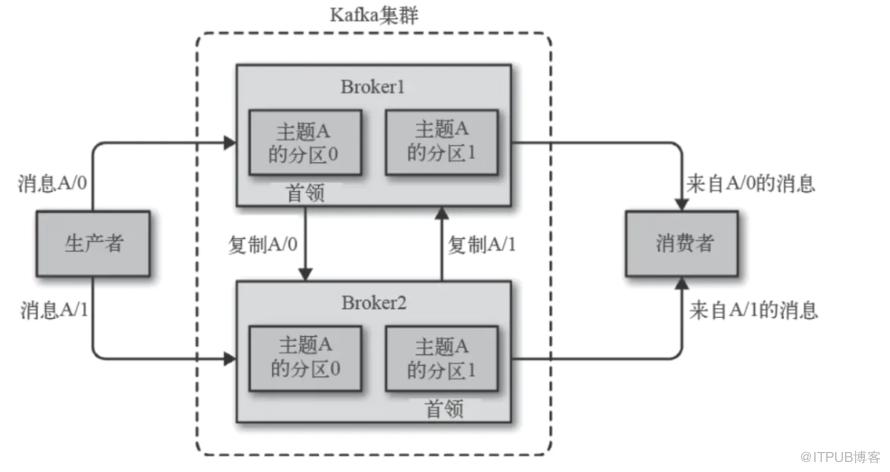
如果某Topic有N个Partition,集群有N个Broker,那么每个Broker存储该Topic的一个Partition。
如果某Topic有N个Partition,集群有(N+M)个Broker,那么其中有N个Broker存储该Topic的一个Partition,剩下的M个Broker不存储该Topic的Partition数据。
如果某Topic有N个Partition,集群中Broker数目少于N个,那么一个Broker存储该Topic的一个或多个Partition。在实际生产环境中,尽量避免这种情况的发生,这种情况容易导致Kafka集群数据不均衡。
Broker是集群的组成部分。每个集群都有一个Broker同时充当了集群控制器的角色(自动从集群的活跃成员中选举出来)。
控制器负责管理工作,包括将分区分配给Broker和监控Broker。在集群中,一个分区从属于一个Broker,该Broker被称为分区的首领。
1.5.4 Topic
每条发布到Kafka集群的消息都有一个类别,这个类别被称为Topic。物理上不同Topic的消息分开存储;主题就好比数据库的表,尤其是分库分表之后的逻辑表。
1.5.5 Partition
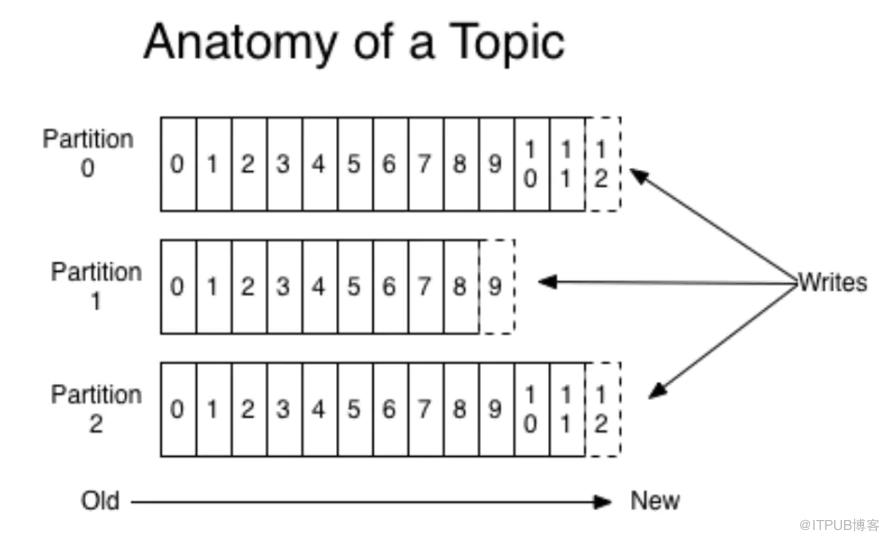
主题可以被分为若干个分区,一个分区就是一个提交日志;
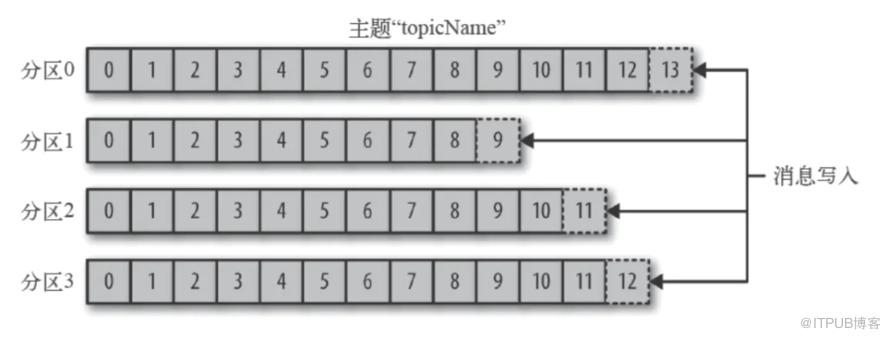
消息以追加的方式写入分区,然后以先入先出的顺序读取;
无法在整个主题范围内保证消息的顺序,但可以保证消息在单个分区内的顺序;
Kafka通过分区来实现数据冗余和伸缩性;
在需要严格保证消息的消费顺序的场景下,需要将Partition数目设为1。
1.5.6 Replicas副本
Kafka使用主题来组织数据,每个主题被分为若干个分区,每个分区有多个副本。那些副本被保存在Broker 上,每个Broker可以保存成百上千个属于不同主题和分区的副本。
副本有以下两种类型:
首领副本
每个分区都有一个首领副本。为了保证一致性,所有生产者请求和消费者请求都会经过这个副本。
跟随者副本
首领以外的副本都是跟随者副本。跟随者副本不处理来自客户端的请求,它们唯一的任务就是从首领那里复制消息,保持与首领一致的状态。如果首领发生崩溃,其中的一个跟随者会被提升为新首领。
1.5.7 Offset
1.5.7.1 生产者Offset
消息写入的时候,每一个分区都有一个offset,这个offset就是生产者的offset,同时也是这个分区的最新最大的offset。有些时候没有指定某一个分区的offset,这个工作kafka帮我们完成。
1.5.7.2 消费者Offset

这是某一个分区的offset情况,生产者写入的offset是最新最大的值是12,而当Consumer A进行消 费时,从0开始消费,一直消费到了9,消费者的offset就记录在9,Consumer B就纪录在了11。等下一次它们再来消费时,它们可以选择接着上一次的位置消费,当然也可以选择从头消费,或者跳到最近的记录并从“现在”开始消费。
1.5.8 副本
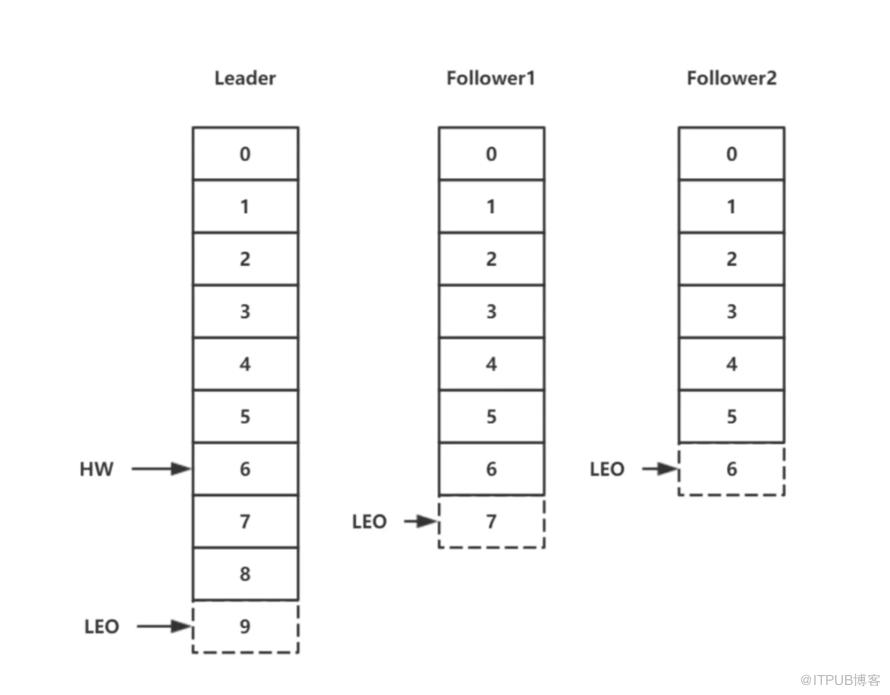
Kafka通过副本保证高可用。副本分为首领副本(Leader)和跟随者副本(Follower)。跟随者副本包括同步副本和不同步副本,在发生首领副本切换的时候,只有同步副本可以切换为首领副本。
1.5.8.1 AR
分区中的所有副本统称为AR(Assigned Repllicas);AR=ISR+OSR。
1.5.8.2 ISR
所有与Leader副本保持一定程度同步的副本(包括Leader)组成ISR(In-Sync Replicas),ISR集合是AR集合中的一个子集。消息会先发送到Leader副本,然后Follower副本才能从Leader副本中拉取消息进行同步,同步期间内Follower副本相对于Leader副本而言会有一定程度的滞后。前面所说的“一定程度”是指可以忍受的滞后范围,这个范围可以通过参数进行配置。
1.5.8.3 OSR
与Leader副本同步滞后过多的副本(不包括Leader)副本,组成OSR(Out-Sync Relipcas)。在正常情况下,所有的Follower副本都应该与Leader副本保持一定程度的同步,即AR=ISR,OSR集合为空。
1.5.8.4 HW
HW是High Watermak的缩写, 俗称高水位,它表示了一个特定消息的偏移量(offset),消费者只能拉取到这个offset之前的消息。
1.5.8.5 LEO
LEO是Log End Offset的缩写,它表示了当前日志文件中下一条待写入消息的offset。
2.1 Kafka集群规划
2.1.1 Zookeeper集群
共三台服务器,分别为:kafka-01、kafka-02、kafka-03。
2.1.2 Kafka集群
共三台服务器,分别为:kafka-01、kafka-02、kafka-03。
2.2 JDK部署(3台均需部署)
#下载JDK软件包;
下载地址:https://www.oracle.com/java/technologies/javase/javase8-archive-downloads.html

#选择linux x64的tar文件
jdk-8u291-linux-x64.tar.gz

#卸载系统自带jdk
yum -y remove *jdk

#解压JDK软件包;
tar -xzvf jdk-8u291-linux-x64.tar.gz

#将解压到JDK移动到/usr/local下
mv jdk1.8.0_291 /usr/local/

#修改环境变量
vim /etc/profile 添加以下(注意一定不要有多余空格!!!!)
export JAVA_HOME=/usr/local/jdk1.8.0_291
export CLASSPATH=.:$JAVA_HOME/jre/lib/rt.jar:$JAVA_HOME/lib/dt.jar:$JAVA_HOME/lib/tools.jar
export PATH=$PATH:$JAVA_HOME/bin

#使环境变量生效
source /etc/profile

#验证版本
java -version
2.3 Zookeeper集群部署
部署Zookeeper集群之前,通常我们采用3台服务器,为什么要选择三台服务器部署ZK集群呢,Zookeeper 集群通常是用来对用户的分布式应用程序提供协调服务的。
在每台机器数据保持一致的情况下,Zookeeper集群可以保证,客户端发起的每次查询操作,集群节点都能返回同样的结果。但是对于客户端发起的修改、删除等能改变数据的操作呢?集群中那么多台机器,你修改你的,我修改我的,最后返回集群中哪台机器的数据呢?
这就是一盘散沙,需要一个领导,于是在Zookeeper集群中,Leader的作用就体现出来了,只有Leader节点才有权利发起修改数据的操作,而follower节点即使接收到了客户端发起的修改操作,也要将其转交给Leader来处理,Leader接收到修改数据的请求后,会向所有follower广播一条消息,让它们执行某项操作,follower执行完后,便会向Leader回复执行完毕。
当Leader收到半数以上的Follower 的确认消息,便会判定该操作执行完毕,然后向所有follower广播该操作已经生效。所以Zookeeper集群中Leader是不可缺少的,但是Leader节点是怎么产生的呢?其实就是由所有follower节点选举产生的,而且Leader节点只能有一个,毕竟一个国家不能有多个总统。
为什么Zookeeper节点数是奇数,我们下面来一一来说明:
1. 容错率
从容错率来说明:(需要保证集群能够有半数进行投票),2台服务器,至少2台正常运行才行(2的半数为1,半数以上最少为2),正常运行1台服务器都不允许挂掉,但是相对于单节点服务器,2台服务器还有两个单点故障,所以直接排除了。
部署Zookeeper 集群之前,通常我们采用3台服务器,为什么要选择三台服务器部署ZK集群呢,Zookeeper 集群通常是用来对用户的分布式应用程序提供协调服务的。
在每台机器数据保持一致的情况下,Zookeeper集群可以保证,客户端发起的每次查询操作,集群节点都能返回同样的结果。但是对于客户端发起的修改、删除等能改变数据的操作呢?集群中那么多台机器,你修改你的,我修改我的,最后返回集群中哪台机器的数据呢?
这就是一盘散沙,需要一个领导,于是在Zookeeper集群中,Leader的作用就体现出来了,只有Leader节点才有权利发起修改数据的操作,而follower节点即使接收到了客户端发起的修改操作,也要将其转交给Leader来处理,Leader接收到修改数据的请求后,会向所有follower广播一条消息,让他们执行某项操作,follower 执行完后,便会向 Leader 回复执行完毕。
当Leader 收到半数以上的Follower 的确认消息,便会判定该操作执行完毕,然后向所有 follower 广播该操作已经生效。所以Zookeeper集群中Leader是不可缺少的,但是 Leader 节点是怎么产生的呢?其实就是由所有follower 节点选举产生的,而且Leader节点只能有一个,毕竟一个国家不能有多个总统。
为什么 zookeeper 节点数是奇数,我们下面来一一来说明:
从容错率来说明:(需要保证集群能够有半数进行投票),2台服务器,至少2台正常运行才行(2的半数为1,半数以上最少为2),正常运行1台服务器都不允许挂掉,但是相对于 单节点服务器,2台服务器还有两个单点故障,所以直接排除了。
3台服务器,至少2台正常运行才行(3的半数为1.5,半数以上最少为2),正常运行可以允许1台服务器挂掉。
4台服务器,至少3台正常运行才行(4的半数为2,半数以上最少为3),正常运行可以允许1台服务器挂掉。
5台服务器,至少3台正常运行才行(5的半数为2.5,半数以上最少为3),正常运行可以允许2台服务器挂掉。
2. 防脑裂
脑裂集群的脑裂通常是发生在节点之间通信不可达的情况下,集群会分裂成不同的小集群,小集群各自选出自己的Leader节点,导致原有的集群出现多个Leader节点的情况,这就是脑裂。
3台服务器,投票选举半数为1.5,一台服务裂开,和另外两台服务器无法通信,这时候2台服务器的集群(2票大于半数1.5票),所以可以选举出Leader,而1台服务器的集群无法选举。
4台服务器,投票选举半数为2,可以分成 1,3两个集群或者2,2两个集群,对于1,3集群,3集群可以选举;对于2,2集群,则不能选举,造成没有Leader节点。
5台服务器,投票选举半数为2.5,可以分成1,4两个集群,或者2,3两集群,这两个集群分别都只能选举一个集群,满足zookeeper集群搭建数目。
通过以上分析,我们从容错率以及防止脑裂两方面说明了3台服务器是搭建集群的最少数目,4台发生脑裂时会造成没有Leader节点的错误。
以下为基于二进制Tar包部署Zookeeper集群。
2.3.1 安装Zookeeper
在3台服务器上执行如下安装步骤:
#下载Zookeeper软件包;
wget -c https://mirrors.tuna.tsinghua.edu.cn/apache/zookeeper/stable/apache-zookeeper-3.6.3-bin.tar.gz

#tar解压Zookeeper软件包;
tar -xzvf apache-zookeeper-3.6.3-bin.tar.gz

#创建Zookeeper部署目录;
mkdir -p /usr/local/zookeeper/

#将解压程序移动至ZK部署目录;
mv apache-zookeeper-3.6.3-bin/* /usr/local/zookeeper/

#查看ZK是否部署成功;
ls -l /usr/local/zookeeper/

#CP拷贝默认模板配置文件;
cd /usr/local/zookeeper/conf/
\cp zoo_sample.cfg zoo.cfg
2.3.2 修改Zookeeper配置文件
修改3台服务器Zookeeper配置文件zoo.cfg的部分参数内容如下:
dataDir=/zookeeper
maxClientCnxns=60
autopurge.snapRetainCount=3
autopurge.purgeInterval=1
server.1=172.29.57.201:2888:3888
server.2=172.29.57.202:2888:3888
server.3=172.29.57.203:2888:3888
2.3.2.1 Zookeeper配置文件详解
zoo.cfg配置文件参数详解:
tickTime:基本事件单元,这个时间是作为Zookeeper服务器之间或客户端与服务器之间维持心跳的时间间隔,每隔tickTime时间就会发送一个心跳;最小的session过期时间为2倍tickTimedataDir:存储内存中数据库快照的位置,除非另有说明,否则指向数据库更新的事务日志。注意:应该谨慎的选择日志存放的位置,使用专用的日志存储设备能够大大提高系统的性能,如果将日志存储在比较繁忙的存储设备上,那么将会很大程度上影像系统性能。clientPort:监听客户端连接的端口。initLimit:允许follower连接并同步到Leader的初始化连接时间,以tickTime为单位。当初始化连接时间超过该值,则表示连接失败。syncLimit:表示Leader与Follower之间发送消息时,请求和应答时间长度。如果follower在设置时间内不能与leader通信,那么此follower将会被丢弃。server.A=B:C:D A:服务器的编号;B:ZK服务器的IP地址;C:Leader选举的端口;D:Zookeeper服务器之间的通信端口;
2.3.3 创建Zookeeper集群myid
Zookeeper集群模式下需要配置myid文件,该需要放在dataDir根目录下。文件填写一个数字,数字就是A的值。
#172.29.57.201创建myid,方法如下:
mkdir -p /zookeeper/
echo "1" > /zookeeper/myid

#172.29.57.202创建myid,方法如下:
mkdir -p /zookeeper/
echo "2" > /zookeeper/myid

#172.29.57.203创建myid,方法如下:
mkdir -p /zookeeper/
echo "3" > /zookeeper/myid
2.3.4 启动Zookeeper集群
根据如上ZK配置完成,启动三台机器的ZK服务即可,启动服务的命令如下:
#启动ZK软件服务;
/usr/local/zookeeper/bin/zkServer.sh start

#查看ZK服务进程和端口;
ps -ef|grep -ai zookeeper
netstat -tnlp|grep -aiwE 2181

#查看ZK服务的状态;
/usr/local/zookeeper/bin/zkServer.sh status

#启动ZK客户端命令行;
/usr/local/zookeeper/bin/zkCli.sh

#创建测试信息;
/usr/local/zookeeper/bin/zkCli.sh
help
create /superman
ls /
set /superman
get /superman
2.3.5 查看Zookeeper集群状态
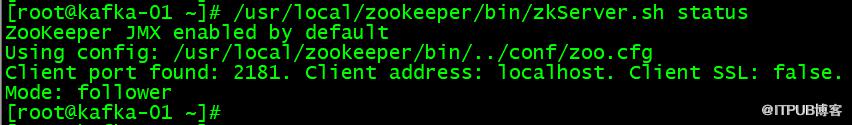
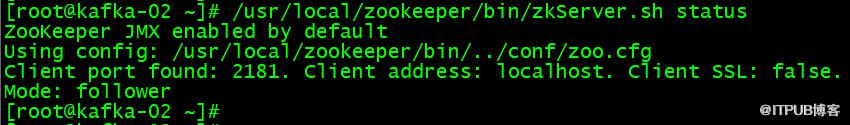
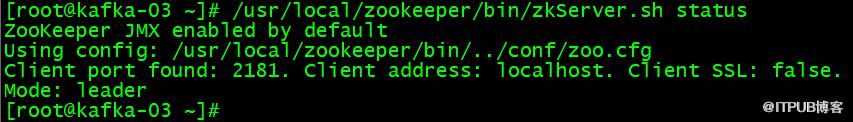
根据如上ZK集群配置操作,最终ZK集群部署成功,查看其状态信息,可以看到一个leader,两个follower,如图所示:
2.3.6 故障排查
2.3.6.1 若出现启动失败,可查看日志
日志文件位置/usr/local/zookeeper/logs/zookeeper-root-server-<主机名>.out
2.3.6.2 大多数的问题都是配置文件的问题
注意在配置文件中一定不要有多余的空格!!!!
2.4 Kafka集群部署
2.4.1 安装Kafka
在3台服务器上执行如下安装步骤:
#下载Kafka软件包;
wget -c https://mirrors.tuna.tsinghua.edu.cn/apache/kafka/2.6.2/kafka_2.12-2.6.2.tgz

#tar解压kafka软件包;
tar -xzvf kafka_2.12-2.6.2.tgz

#创建kafka部署目录;
mkdir -p /usr/local/kafka/

#将解压程序移动至kafka部署目录;
mv kafka_2.12-2.6.2/* /usr/local/kafka/

#查看kafka是否部署成功;
ls -l /usr/local/kafka/

#查看默认模板配置文件;
ls -l /usr/local/kafka/config/server.properties
2.4.2 修改Kafka配置文件
修改3台服务器Kafka配置文件server.properties的内容如下:
vim /usr/local/kafka/config/server.properties

#修改broker.id
修改broker.id=1与上面配置的zookeeper myid保持一致;其中kafka-01、kafka-02、kafka-03的broker.id分别为1、2、3。

#修改listeners
将listteners=PLAINTEXT://:9092修改成listteners=PLAINTEXT://ip:9092
listeners=PLAINTEXT://172.29.57.201:9092

#修改zookeeper.connect
修改zookeeper.connect为三台机器的ip,用逗号隔开;
zookeeper.connect=172.29.57.201:2181,172.29.57.202:2181,172.29.57.203:2181
2.4.2.1 Kafka配置文件详解
2.4.2.1.1 server.properties:服务端的配置文件
#broker的全局唯一编号,不能重复
broker.id=0

#用来监听链接的端口,producer或consumer将在此端口建立连接
port=9092

#处理网络请求的线程数量,也就是接收消息的线程数。
#接收线程会将接收到的消息放到内存中,然后再从内存中写入磁盘。
num.network.threads=3

#消息从内存中写入磁盘是时候使用的线程数量。
#用来处理磁盘IO的线程数量
num.io.threads=8

#发送套接字的缓冲区大小
socket.send.buffer.bytes=102400

#接受套接字的缓冲区大小
socket.receive.buffer.bytes=102400

#请求套接字的缓冲区大小
socket.request.max.bytes=104857600

#kafka运行日志存放的路径
log.dirs=/export/servers/logs/kafka

#topic在当前broker上的分片个数
num.partitions=2

#我们知道segment文件默认会被保留7天的时间,超时的话就
#会被清理,那么清理这件事情就需要有一些线程来做。这里就是
#用来设置恢复和清理data下数据的线程数量
num.recovery.threads.per.data.dir=1

#segment文件保留的最长时间,默认保留7天(168小时),
#超时将被删除,也就是说7天之前的数据将被清理掉。
log.retention.hours=168

#滚动生成新的segment文件的最大时间
log.roll.hours=168

#日志文件中每个segment的大小,默认为1G
log.segment.bytes=1073741824

#上面的参数设置了每一个segment文件的大小是1G,那么
#就需要有一个东西去定期检查segment文件有没有达到1G,
#多长时间去检查一次,就需要设置一个周期性检查文件大小
#的时间(单位是毫秒)。
log.retention.check.interval.ms=300000

#日志清理是否打开
log.cleaner.enable=true

#broker需要使用zookeeper保存meta数据
zookeeper.connect=172.29.57.201:2181,172.29.57.202:2181,172.29.57.203:2181

#zookeeper链接超时时间
zookeeper.connection.timeout.ms=6000

#上面我们说过接收线程会将接收到的消息放到内存中,然后再从内存
#写到磁盘上,那么什么时候将消息从内存中写入磁盘,就有一个
#时间限制(时间阈值)和一个数量限制(数量阈值),这里设置的是
#数量阈值,下一个参数设置的则是时间阈值。
#partion buffer中,消息的条数达到阈值,将触发flush到磁盘。
log.flush.interval.messages=10000

#消息buffer的时间,达到阈值,将触发将消息从内存flush到磁盘,
#单位是毫秒。
log.flush.interval.ms=3000

#删除topic需要server.properties中设置delete.topic.enable=true否则只是标记删除
delete.topic.enable=true

#此处的host.name为本机IP(重要),如果不改,则客户端会抛出:
#Producer connection to localhost:9092 unsuccessful 错误!
host.name=kafka01

advertised.host.name=192.168.239.128
2.4.2.1.2 producer.properties:生产端的配置文件
#指定kafka节点列表,用于获取metadata,不必全部指定
#需要kafka的服务器地址,来获取每一个topic的分片数等元数据信息。
metadata.broker.list=kafka01:9092,kafka02:9092,kafka03:9092

#生产者生产的消息被发送到哪个block,需要一个分组策略。
#指定分区处理类。默认kafka.producer.DefaultPartitioner,表通过key哈希到对应分区
#partitioner.class=kafka.producer.DefaultPartitioner

#生产者生产的消息可以通过一定的压缩策略(或者说压缩算法)来压缩。消息被压缩后发送到broker集群,
#而broker集群是不会进行解压缩的,broker集群只会把消息发送到消费者集群,然后由消费者来解压缩。
#是否压缩,默认0表示不压缩,1表示用gzip压缩,2表示用snappy压缩。
#压缩后消息中会有头来指明消息压缩类型,故在消费者端消息解压是透明的无需指定。
#文本数据会以1比10或者更高的压缩比进行压缩。
compression.codec=none

#指定序列化处理类,消息在网络上传输就需要序列化,它有String、数组等许多种实现。
serializer.class=kafka.serializer.DefaultEncoder

#如果要压缩消息,这里指定哪些topic要压缩消息,默认empty,表示不压缩。
#如果上面启用了压缩,那么这里就需要设置
#compressed.topics=
#这是消息的确认机制,默认值是0。在面试中常被问到。
#producer有个ack参数,有三个值,分别代表:
#(1)不在乎是否写入成功;
#(2)写入leader成功;
#(3)写入leader和所有副本都成功;
#要求非常可靠的话可以牺牲性能设置成最后一种。
#为了保证消息不丢失,至少要设置为1,也就
#是说至少保证leader将消息保存成功。
#设置发送数据是否需要服务端的反馈,有三个值0,1,-1,分别代表3种状态:
#0: producer不会等待broker发送ack。生产者只要把消息发送给broker之后,就认为发送成功了,这是第1种情况;
#1: 当leader接收到消息之后发送ack。生产者把消息发送到broker之后,并且消息被写入到本地文件,才认为发送成功,这是第二种情况;#-1: 当所有的follower都同步消息成功后发送ack。不仅是主的分区将消息保存成功了,
#而且其所有的分区的副本数也都同步好了,才会被认为发动成功,这是第3种情况。
request.required.acks=0

#broker必须在该时间范围之内给出反馈,否则失败。
#在向producer发送ack之前,broker允许等待的最大时间 ,如果超时,
#broker将会向producer发送一个error ACK.意味着上一次消息因为某种原因
#未能成功(比如follower未能同步成功)
request.timeout.ms=10000

#生产者将消息发送到broker,有两种方式,一种是同步,表示生产者发送一条,broker就接收一条;
#还有一种是异步,表示生产者积累到一批的消息,装到一个池子里面缓存起来,再发送给broker,
#这个池子不会无限缓存消息,在下面,它分别有一个时间限制(时间阈值)和一个数量限制(数量阈值)的参数供我们来设置。
#一般我们会选择异步。
#同步还是异步发送消息,默认“sync”表同步,"async"表异步。异步可以提高发送吞吐量,
#也意味着消息将会在本地buffer中,并适时批量发送,但是也可能导致丢失未发送过去的消息
producer.type=sync

#在async模式下,当message被缓存的时间超过此值后,将会批量发送给broker,
#默认为5000ms
#此值和batch.num.messages协同工作.
queue.buffering.max.ms = 5000

#异步情况下,缓存中允许存放消息数量的大小。
#在async模式下,producer端允许buffer的最大消息量
#无论如何,producer都无法尽快的将消息发送给broker,从而导致消息在producer端大量沉积
#此时,如果消息的条数达到阀值,将会导致producer端阻塞或者消息被抛弃,默认为10000条消息。
queue.buffering.max.messages=20000

#如果是异步,指定每次批量发送数据量,默认为200
batch.num.messages=500

#在生产端的缓冲池中,消息发送出去之后,在没有收到确认之前,该缓冲池中的消息是不能被删除的,
#但是生产者一直在生产消息,这个时候缓冲池可能会被撑爆,所以这就需要有一个处理的策略。
#有两种处理方式,一种是让生产者先别生产那么快,阻塞一下,等会再生产;另一种是将缓冲池中的消息清空。
#当消息在producer端沉积的条数达到"queue.buffering.max.meesages"后阻塞一定时间后,
#队列仍然没有enqueue(producer仍然没有发送出任何消息)
#此时producer可以继续阻塞或者将消息抛弃,此timeout值用于控制"阻塞"的时间
#-1: 不限制阻塞超时时间,让produce一直阻塞,这个时候消息就不会被抛弃
#0: 立即清空队列,消息被抛弃
queue.enqueue.timeout.ms=-1

#当producer接收到error ACK,或者没有接收到ACK时,允许消息重发的次数
#因为broker并没有完整的机制来避免消息重复,所以当网络异常时(比如ACK丢失)
#有可能导致broker接收到重复的消息,默认值为3.
message.send.max.retries=3

#producer刷新topic metada的时间间隔,producer需要知道partition leader
#的位置,以及当前topic的情况
#因此producer需要一个机制来获取最新的metadata,当producer遇到特定错误时,
#将会立即刷新
#(比如topic失效,partition丢失,leader失效等),此外也可以通过此参数来配置
#额外的刷新机制,默认值600000
topic.metadata.refresh.interval.ms=60000
2.4.2.1.3 consumer.properties:消费端的配置文件
#消费者集群通过连接Zookeeper来找到broker。
#zookeeper连接服务器地址
zookeeper.connect=zk01:2181,zk02:2181,zk03:2181

#zookeeper的session过期时间,默认5000ms,用于检测消费者是否挂掉
zookeeper.session.timeout.ms=5000

#当消费者挂掉,其他消费者要等该指定时间才能检查到并且触发重新负载均衡
zookeeper.connection.timeout.ms=10000

#这是一个时间阈值。
#指定多久消费者更新offset到zookeeper中。
#注意offset更新时基于time而不是每次获得的消息。
#一旦在更新zookeeper发生异常并重启,将可能拿到已拿到过的消息
zookeeper.sync.time.ms=2000

#指定消费
group.id=xxxxx

#这是一个数量阈值,经测试是500条。
#当consumer消费一定量的消息之后,将会自动向zookeeper提交offset信息#注意offset信息并不是每消费一次消息就向zk提交
#一次,而是现在本地保存(内存),并定期提交,默认为true
auto.commit.enable=true

# 自动更新时间。默认60 * 1000
auto.commit.interval.ms=1000

# 当前consumer的标识,可以设定,也可以有系统生成,
#主要用来跟踪消息消费情况,便于观察
conusmer.id=xxx

# 消费者客户端编号,用于区分不同客户端,默认客户端程序自动产生
client.id=xxxx

# 最大取多少块缓存到消费者(默认10)
queued.max.message.chunks=50

# 当有新的consumer加入到group时,将会reblance,此后将会
#有partitions的消费端迁移到新 的consumer上,如果一个
#consumer获得了某个partition的消费权限,那么它将会向zk
#注册 "Partition Owner registry"节点信息,但是有可能
#此时旧的consumer尚没有释放此节点, 此值用于控制,
#注册节点的重试次数.
rebalance.max.retries=5

#每拉取一批消息的最大字节数
#获取消息的最大尺寸,broker不会像consumer输出大于
#此值的消息chunk 每次feth将得到多条消息,此值为总大小,
#提升此值,将会消耗更多的consumer端内存
fetch.min.bytes=6553600

#当消息的尺寸不足时,server阻塞的时间,如果超时,
#消息将立即发送给consumer
#数据一批一批到达,如果每一批是10条消息,如果某一批还
#不到10条,但是超时了,也会立即发送给consumer。
fetch.wait.max.ms=5000
socket.receive.buffer.bytes=655360

# 如果zookeeper没有offset值或offset值超出范围。
#那么就给个初始的offset。有smallest、largest、
#anything可选,分别表示给当前最小的offset、
#当前最大的offset、抛异常。默认largest
auto.offset.reset=smallest

# 指定序列化处理类
derializer.class=kafka.serializer.DefaultDecoder
2.4.3 启动Kafka集群
2.4.3.1 启动Zookeeper集群
启动kafka集群前先确保已经启动Zookeeper集群。
2.4.3.1.1 查看Zookeeper集群状态
/usr/local/zookeeper/bin/zkServer.sh status
Zookeeper集群状态为一个Leader两个Follower为正常。
参考《2.3.5 查看Zookeeper集群状态》。
2.4.3.1.2 启动Zookeeper集群
分别在三台Zookeeper服务器上执行以下命令:
/usr/local/zookeeper/bin/zkServer.sh start
注意:确保Zookeeper集群状态为一个Leader两个Follower。
2.4.3.2 启动Kafka集群
进入kafka目录下,执行以下命令启动kafka集群:
#启动kafka软件服务;
/usr/local/kafka/bin/kafka-server-start.sh -daemon /usr/local/kafka/config/server.properties

#查看服务进程和端口;
ps -ef|grep -ai kafka
netstat -tnlp|grep -aiwE 9092
2.4.4 测试验证
2.4.4.1 创建Topic–test
/usr/local/kafka/bin/kafka-topics.sh --create --zookeeper 172.29.57.201:2181,172.29.57.202:2181,172.29.57.203:2181 --replication-factor 3 --partitions 3 --topic test
2.4.4.2 查看已经创建的Topic列表
/usr/local/kafka/bin/kafka-topics.sh --list --zookeeper localhost:2181
2.4.4.3 在master启动生产者(任意一台)
/usr/local/kafka/bin/kafka-console-producer.sh --broker-list 172.29.57.201:9092,172.29.57.202:9092,172.29.57.203:9092 --topic test
2.4.4.4 在另外两台服务器其中之一启动消费者
/usr/local/kafka/bin/kafka-console-consumer.sh --bootstrap-server 172.29.57.201:9092,172.29.57.202:9092,172.29.57.203:9092 --from-beginning --topic test
2.4.4.5 生产者的服务器输入内容,消费者服务器就会显示
2.4.4.5.1 生产者
/usr/local/kafka/bin/kafka-console-producer.sh --broker-list 172.29.57.201:9092,172.29.57.202:9092,172.29.57.203:9092 --topic test

>hello world!
2.4.4.5.2 消费者
/usr/local/kafka/bin/kafka-console-consumer.sh --bootstrap-server 172.29.57.201:9092,172.29.57.202:9092,172.29.57.203:9092 --topic test

hello world!
2.4.5 故障排查
如果出现commit_memory(0x00000000c0000000, 1073741824, 0) failed 错误,
报错内容:内存设置异常;
原因分析:kafka默认启动内存为1G,可以在配置文件中修改,修改/usr/local/kafka/bin/kafka-server-start.sh重新设置文件中的KAFKA_HEAP_OPTS参数。
UnknownTopicOrPartitionException
org.apache.kafka.common.errors.UnknownTopicOrPartitionException:
This server does not host this topic-partition
报错内容:分区数据不在
原因分析:producer向不存在的topic发送消息,用户可以检查topic是否存在 或者设置auto.create.topics.enable参数。
LEADER_NOT_AVAILABLE
WARN Error while fetching metadata with correlation id 0 : {test=LEADER_NOT_AVAILABLE} (org.apache.kafka.clients.NetworkClient
报错内容:leader不可用
原因分析:原因很多topic正在被删除 正在进行leader选举 使用kafka-topics脚本检查leader信息,进而检查broker的存活情况 尝试重启解决。
NotLeaderForPartitionException
org.apache.kafka.common.errors.NotLeaderForPartitionException: This server is not the leader for that topic-partition
报错内容:broker已经不是对应分区的leader了
原因分析:发生在leader变更时 当leader从一个broker切换到另一个broker时,要分析什么原因引起了leader的切换。
TimeoutException
org.apache.kafka.common.errors.TimeoutException: Expiring 5 record(s) for test-0: 30040 ms has passe
报错内容:请求超时
原因分析:观察哪里抛出的 观察网络是否能通 如果可以通 可以考虑增加request.timeout.ms的值,
RecordTooLargeException
WARN async.DefaultEventHandler: Produce request with correlation id 92548048 failed due to [TopicName,1]: org.apache.kafka.common.errors.RecordTooLargeException
报错内容:消息过大
原因分析:生产者端 消息处理不过来了 可以增加 request.timeout.ms 减少 batch.size。
Closing socket connection
Closing socket connection to/127,0,0,1.(kafka.network.Processor)
报错内容:连接关闭
原因分析:如果javaApi producer版本高,想在客户端consumer启动低版本验证,会不停的报错,无法识别客户端消息。
ConcurrentModificationException
java.util.ConcurrentModificationException: KafkaConsumer is not safe for multi-threaded access
报错内容:线程不安全
原因分析:Kafka consumer是非线程安全的。
NetWorkException [kafka-producer-network-thread | producer-1] o.apache.kafka.common.network.Selector : [Producer clientId=producer-1] Connection with / disconnected
报错内容:网络异常
原因分析:网络连接中断 检查broker的网络情况。
ILLEGAL_GENERATIONILLEGAL_GENERATION occurred while committing offsets for group
报错内容:无效的“代”
原因分析:consumer错过了 rebalance 原因是consumer花了大量时间处理数据。
需要适当减少 max.poll.records值 增加 max.poll.interval.ms 或者想办法增加消息处理的速度。
欢迎关注我的微信公众号【超哥的IT私房菜】获取更多技术干货!
有什么吐槽或反馈意见,直接告诉我!
我会解决您说的问题,进一步更好的服务您哦!
温馨提示:如出现二维码失效也可直接添加微信号:ysc13803862469。

原文作者:超哥的IT私房菜;如有侵权,请联系管理员删除。

最新文章
- 06 ASM存储入门——Oracle 19c的“存储管家”(可选,针对需要ASM的场景)
- 05 手把手部署Oracle 19c RAC——2节点实例安装全流程(图形化+静默)
- 04 手把手部署Oracle 19c——单实例ASM安装全流程(图形化+静默)
- 03 Oracle 19c初始化配置——让数据库“好用又安全”
- 02 手把手部署Oracle 19c——单实例安装全流程(图形化+静默)
- 01 Oracle 19c部署前的“避坑指南”——环境规划与准备
- 开源堡垒机 JumpServer 社区版实战教程:发布机的配置与Website资产配置使用
- 开源堡垒机 JumpServer 社区版实战教程:一步步构建企业安全运维环境
- 基于 Ubuntu 22.04 离线安装 JumpServer 社区版 v4.4.1
- Harbor镜像仓库实战指南:从安装到高级管理的全面解析
