openGauss学习笔记-291 openGauss AI特性-AI子功能-X-Tuner:参数调优与诊断-使用示例
openGauss学习笔记-291 openGauss AI特性-AI4DB数据库自治运维-DBMind的AI子功能-X-Tuner:参数调优与诊断-使用示例291.1 配置数据库连接信息291.2 recommend模式使用示例291.3 train 模式使用示例291.4 tune模式使用示例
openGauss学习笔记-291 openGauss AI特性-AI4DB数据库自治运维-DBMind的AI子功能-X-Tuner:参数调优与诊断-使用示例
X-Tuner支持三种模式,分别是获取参数诊断报告的recommend模式、训练强化学习模型的train模式、以及使用算法进行调优的tune模式。上述三种模式可以通过命令行参数来区别,通过配置文件来指定具体的细节。
291.1 配置数据库连接信息
三种模式连接数据库的配置项是相同的,有两种方式:一种是直接通过命令行输入详细的连接信息,另一种是通过JSON格式的配置文件输入,下面分别对两种指定数据库连接信息的方法进行说明。
-
通过命令行指定:
分别传递 –db-name –db-user –port –host –host-user 参数,可选 –host-ssh-port 参数,例如:
gs_dbmind component xtuner recommend --db-name postgres --db-user omm --port 5678 --host 192.168.1.100 --host-user omm -
通过JSON格式的连接信息配置文件指定:
JSON配置文件的示例如下,并假设文件名为 connection.json:
{
  "db_name": "postgres",  # 数据库名
  "db_user": "dba",       # 登录到数据库上的用户名
  "host": "127.0.0.1",    # 数据库宿主机的IP地址
  "host_user": "dba",     # 登录到数据库宿主机的用户名
  "port": 5432,           # 数据库的侦听端口号
  "ssh_port": 22          # 数据库宿主机的SSH侦听端口号
}
则可通过 -f connection.json 传递。
说明: 为了防止密码泄露,配置文件和命令行参数中默认都不包含密码信息,用户在输入上述连接信息后,程序会采用交互式的方式要求用户输数据库密码以及操作系统登录用户的密码。
291.2 recommend模式使用示例
对recommend模式生效的配置项为scenario,若为auto,则自动检测workload类型。
执行下述命令,获取诊断结果:
gs_dbmind component xtuner recommend -f connection.json
则可以生成诊断报告如下:
图 1 recommend模式生成的报告示意图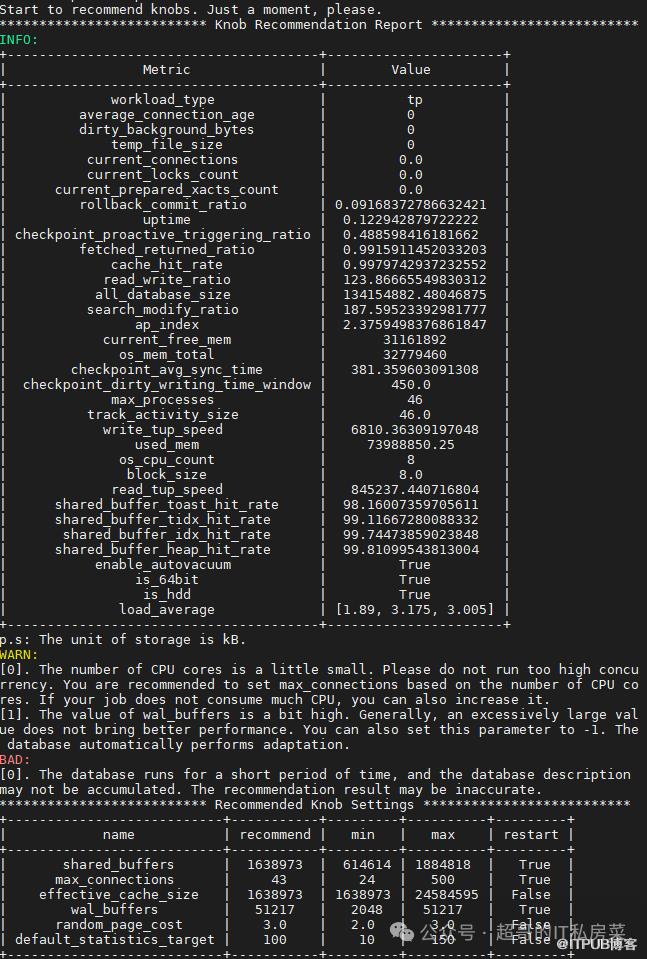
在上述报告中,推荐了该环境上的数据库参数配置,并进行了风险提示。报告同时生成了当前workload的特征信息,其中有几个特征是比较有参考意义的:
temp_file_size:产生的临时文件数量,如果该结果大于0,则表明系统使用了临时文件。使用过多的临时文件会导致性能不佳,如果可能的话,需要提高work_mem参数的配置。
cache_hit_rate:shared_buffer的缓存命中率,表明当前workload使用缓存的效率。
read_write_ratio:数据库作业的读写比例。
search_modify_ratio:数据库作业的查询与修改数据的比例。
ap_index:表明当前workload的AP指数,取值范围是0到10,该数值越大,表明越偏向于数据分析与检索。
workload_type:根据数据库统计信息,推测当前负载类型,分为AP、TP以及HTAP三种类型。
checkpoint_avg_sync_time:数据库在checkpoint时,平均每次同步刷新数据到磁盘的时长,单位是毫秒。
load_average:平均每个CPU核心在1分钟、5分钟以及15分钟内的负载。一般地,该数值在1左右表明当前硬件比较匹配workload、在3左右表明运行当前作业压力比较大,大于5则表示当前硬件环境运行该workload压力过大(此时一般建议减少负载或升级硬件)。
说明:
由于某些系统表会一直记录统计信息,这可能会对负载特征识别造成干扰,因此建议最好先清空某些系统表的统计信息,运行一段时间的workload后再使用recommend模式进行诊断,以便获得更准确的结果。清除统计信息的方法为:
select pg_stat_reset_shared('bgwriter');
select pg_stat_reset();
recommend模式会读取数据库中的pg_stat_database以及pg_stat_bgwriter等系统表中的信息,需要登录到数据库上的用户具有足够的权限(建议为管理员权限,可通过alter user username sysadmin;授予username相应的权限)。
291.3 train 模式使用示例
该模式是用来训练深度强化学习模型的,与该模式有关的配置项为:
rl_algorithm:用于训练强化学习模型的算法,当前支持设置为ddpg.
rl_model_path:训练后生成的强化学习模型保存路径。
rl_steps:训练过程的最大迭代步数。
max_episode_steps:每个回合的最大步数。
scenario:明确指定的workload类型,如果为auto则为自动判断。在不同模式下,推荐的调优参数列表也不一样。
-
tuning_list:用户指定需要调哪些参数,如果不指定,则根据workload类型自动推荐应该调的参数列表。 如需指定,则tuning_list表示调优列表文件的路径。一个调优列表配置文件的文件内容示例如下:
{
  "work_mem": {
    "default": 65536,
    "min": 65536,
    "max": 655360,
    "type": "int",
    "restart": false
  },
  "shared_buffers": {
    "default": 32000,
    "min": 16000,
    "max": 64000,
    "type": "int",
    "restart": true
  },
  "random_page_cost": {
    "default": 4.0,
    "min": 1.0,
    "max": 4.0,
    "type": "float",
    "restart": false
  },
  "enable_nestloop": {
    "default": true,
    "type": "bool",
    "restart": false
  }
}
待上述配置项配置完成后,可以通过下述命令启动训练:
gs_dbmind component xtuner train -f connection.json
训练完成后,会在配置项rl_model_path指定的目录中生成模型文件。
291.4 tune模式使用示例
tune模式支持多种算法,包括基于强化学习(Reinforcement Learning, RL)的DDPG算法、基于全局搜索算法(Global OPtimization algorithm, GOP)算法的贝叶斯优化算法(Bayesian Optimization)以及粒子群算法(Particle Swarm Optimization, PSO)。
与tune模式相关的配置项为:
tune_strategy:指定选择哪种算法进行调优,支持rl(使用强化学习模型进行调优)、gop(使用全局搜索算法)以及auto(自动选择)。若该参数设置为rl,则rl相关的配置项生效。除前文提到过的train模式下生效的配置项外,test_episode配置项也生效,该配置项表明调优过程的最大回合数,该参数直接影响了调优过程的执行时间(一般地,数值越大越耗时)。
gop_algorithm:选择何种全局搜索算法,支持bayes以及pso。
max_iterations:最大迭代轮次,数值越高搜索时间越长,效果往往越好。
particle_nums:在PSO算法上生效,表示粒子数。
scenario与tuning_list见上文train模式中的描述。
待上述配置项配置完成后,可以通过下述命令启动调优:
gs_dbmind component xtuner tune -f connection.json
注意: 在使用tune和train模式前,用户需要先导入benchmark所需数据并检查benchmark能否正常跑通。调优过程结束后,调优程序会自动恢复调优前的数据库参数配置。
👍 点赞,你的认可是我创作的动力!
⭐️ 收藏,你的青睐是我努力的方向!
✏️ 评论,你的意见是我进步的财富!
PS:因为公众号平台更改了推送规则,如果不想错过内容,记得读完点一下“在看”,加个“星标”,这样每次新文章推送才会第一时间出现在你的订阅列表里。点“在看”支持我吧!
原文作者:超哥的IT私房菜;如有侵权,请联系管理员删除。

最新文章
- 06 ASM存储入门——Oracle 19c的“存储管家”(可选,针对需要ASM的场景)
- 05 手把手部署Oracle 19c RAC——2节点实例安装全流程(图形化+静默)
- 04 手把手部署Oracle 19c——单实例ASM安装全流程(图形化+静默)
- 03 Oracle 19c初始化配置——让数据库“好用又安全”
- 02 手把手部署Oracle 19c——单实例安装全流程(图形化+静默)
- 01 Oracle 19c部署前的“避坑指南”——环境规划与准备
- 开源堡垒机 JumpServer 社区版实战教程:发布机的配置与Website资产配置使用
- 开源堡垒机 JumpServer 社区版实战教程:一步步构建企业安全运维环境
- 基于 Ubuntu 22.04 离线安装 JumpServer 社区版 v4.4.1
- Harbor镜像仓库实战指南:从安装到高级管理的全面解析
