最近在学习python语言,今天练习了一下如何利用Python备份itpub博客
1,备份一篇博客
2,备份所有博客
付代码连接
http://pan.baidu.com/s/1eRMIxhw<a href="(.*.html)" ',data)=""
1,备份一篇博客
- 以http://blog.itpub.net/29096438/viewspace-1982636/这篇博客为例
- 查看源码可以看到标题部分的源码为
- <a href<a ="/29096438/viewspace-1982636/">【Python】python练习
-
-
我们主要是想提取出中间红色色部分的URL,然后找到这篇文章的正文进行分析,然后提取进行下载。首先,假
设已经得到这个字符串,然后研究如何提取这个URL,观察发现,对于所有的这类字符串,都有一个共同点,那
就是都含有子串'<a 'href="</a 'href=/29096438",那么我们可以用最笨的方式---查找子串进行定界。
运行代码发现博客已经备份下来了-
# -*- coding: cp936 -*-
-
import re
-
import urllib2
-
str = 'http://blog.itpub.net/29096438/viewspace-1982636/">【Python】python练习' ---自己手工补全网址,源码里面的href不全
-
-
fname=re.match('(.*)',str)
-
fname2=fname.group(1)+'.html'
-
print fname2
-
-
start = str.find(r'href=')
-
start += 6
-
end = str.find('viewspace')
-
end += 17
-
url = str[start : end]
-
print url
-
-
-
text=urllib2.urlopen(url).read()
-
f=open(fname2,'w')
-
f.write(text)
- f.close()
-
# -*- coding: cp936 -*-
- 代码被转义了
-


2,备份所有博客
- 首先进入目录列表查看源码
- 所有文章的URL都符合一个模式,除了文章id不一样,29096438就是我们的用户id吧,每个人都有个独特的id,29096438就是我的用户id
- <a href<a ="/29096438/viewspace-1981855/">【Mysql】sysbench基准测试工具
- <a href<a ="/29096438/viewspace-1982636/">【Python】python练习
-
-
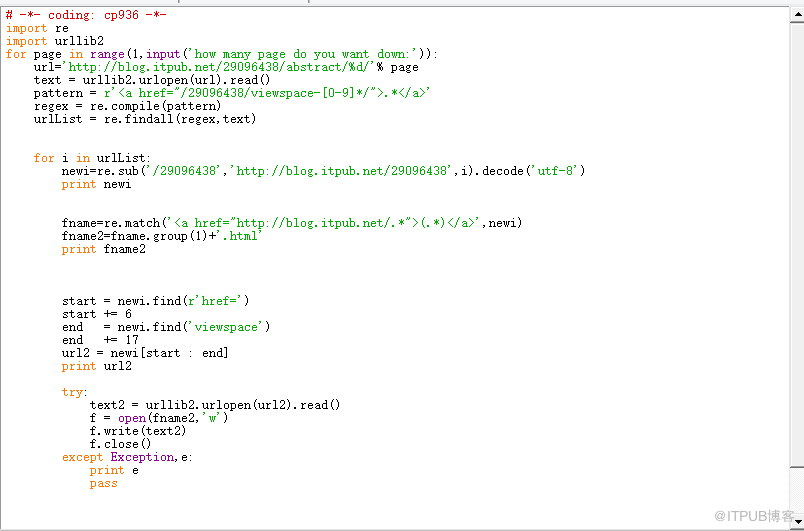
# -*- coding: cp936 -*-
-
import re
import urllib2
for page in range(1,input('how many page do you want down:')): ###这儿就是输入你希望下载的页数,输入你的总页数吧
url='http://blog.itpub.net/29096438/abstract/%d/'% page ####循环不同的页
text = urllib2.urlopen(url).read()
pattern = r'.*'
regex = re.compile(pattern)
urlList = re.findall(regex,text) ####通过正则表达式找到所有文章的href,此时的href是带上标题的
for i in urlList:
newi=re.sub('/29096438','http://blog.itpub.net/29096438',i).decode('utf-8') ###补全文章的href,,因为我们获取到的href是不全
的,少了http://blog.itpub.net这一段,decode编码是为了解决乱码问题
#print newi
fname=re.match('(.*)',newi)
fname2=fname.group(1)+'.html' ####获取文章的标题名
#print fname2
start = newi.find(r'href=')
start += 6
end = newi.find('viewspace')
end += 17
url2 = newi[start : end]
print url2 ####去掉上面href中的标题 只获取href的网址部分
try:
text2 = urllib2.urlopen(url2).read()
f = open(fname2,'w')
f.write(text2)
f.close()
except Exception,e:
print e
pass
- 代码有转义,注意被转换部分
-
-
how many page do you want down:12 ---我的文章总共12页,所以输了个12
-
<a href="http://blog.itpub.net/29096438/viewspace-1682206/">【Mysql】搭建mysql-cluster</a>
-
-
【Mysql】搭建mysql-cluster.html
-
-
http://blog.itpub.net/29096438/viewspace-1682206
-
-
coercing to Unicode: need string or buffer, _sre.SRE_Match found
-
-
<a href="http://blog.itpub.net/29096438/viewspace-1982636/">【Python】python练习</a>
-
-
【Python】python练习.html
-
-
http://blog.itpub.net/29096438/viewspace-1982636
-
-
coercing to Unicode: need string or buffer, _sre.SRE_Match found
-
-
<a href="http://blog.itpub.net/29096438/viewspace-1981855/">【Mysql】sysbench基准测试工具</a>
-
-
【Mysql】sysbench基准测试工具.html
-
-
http://blog.itpub.net/29096438/viewspace-1981855
-
-
coercing to Unicode: need string or buffer, _sre.SRE_Match found
-
-
<a href="http://blog.itpub.net/29096438/viewspace-1981811/">【Mysql】MySQL查询计划key_len全知道</a>
-
-
【Mysql】MySQL查询计划key_len全知道.html
-
-
http://blog.itpub.net/29096438/viewspace-1981811
-
-
coercing to Unicode: need string or buffer, _sre.SRE_Match found
-
-
<a href="http://blog.itpub.net/29096438/viewspace-1980112/">【Pyrhon】Python在自动化运维时经常会用到的方法</a>
-
-
【Pyrhon】Python在自动化运维时经常会用到的方法.html
-
-
http://blog.itpub.net/29096438/viewspace-1980112
-
-
coercing to Unicode: need string or buffer, _sre.SRE_Match found
-
-
<a href="http://blog.itpub.net/29096438/viewspace-1979572/">【Python】Python连接mysql</a>...
-
....
-
....
- ...
-

-
代码:
点击(此处)折叠或打开
改进,用beautiful模块取出正文部分
try:
r=requests.get(url2)
soup=bsp(r.content)
cont=soup.find('div',{'class':'Blog_wz1'})
f=open(fname2,'w')
f.write(str(cont))
f.close()
except:
pass
运行结果:
点击(此处)折叠或打开
可以看到下载的结果

付代码连接
http://pan.baidu.com/s/1eRMIxhw<a href="(.*.html)" ',data)=""
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/29096438/viewspace-1983945/ ,如需转载,请注明出处,否则将追究法律责任。
上一篇:
【Python】python练习

请登录后发表评论
登录
全部评论
最新文章
- [Mysql]Mysql5.7并行复制
- 【Redis】错误:failed: Hostname must not be empty or null
- 【Python】python map()函数和lambda表达式
- 【Mysql】MySQL中interactive_timeout和wait_timeout的区别
- 【Mysql】修改mysql时区
- MySQL(Innodb)索引的原理
- 【Redis】修改redis-trib.rb使其import支持密码
- 【Redis】redis-cluster需要注意的几个地方
- 【Mongodb】mongo复制集只剩一个secondery节点的解决办法
- 【Redis】redis-cluster到redis-cluster的快速复制
