Tesseract OCR样本训练除需要安装Tesseract OCR软件外,还需要下载Tesseract OCR样本训练工具jTessBoxEditorFX,下载地址:
http://dl.pconline.com.cn/download/1060986-1.html
因为jTessBoxEditorFX是用JAVA开发的,因此使用前需要安装好JAVA运行环境。
1、准备样本图片
这里准备了5张手写数字的图片,要求图片格式必须是tif格式。


2、合并样本图片
执行train.bat启动jTessBoxEditorFX,选择菜单Tools->Merge TIFF执行图片合并,将5张tif图片文件合并为1个tif文件num.hand_num.exp0.tif,关闭jTessBoxEditorFX。
合并后的文件命名格式有一定要求
【语法】:[lang].[fontname].exp[num].tif
lang为语言名称,fontname为字体名称,num为序号,可自定义。
3、生成BOX文件
tesseract num.hand_num.exp0.tif num.hand_num.exp0 -l eng --psm 7 batch.nochop makebox
运行后在目标文件夹生成文件num.hand_num.exp0.box。
4、字符纠正
执行train.bat启动jTessBoxEditorFX,选择Box Editor,Open前面生成的合并样本图片num.hand_num.exp0.tif,其对应的box文件会自动加载。
检查修改每页中的各个数字字符解析结果,有不正确的修改,完成后保存替换原box文件。
5、创建font_properties文件
创建字体属性文件font_properties,该文件为文本文件,但没有扩展名。
echo hand_num 0 0 0 0 0 >font_properties
【语法】:<fontname> <italic> <bold> <fixed> <serif> <fraktur>
fontname为字体名称,italic为斜体,bold为黑体字,fixed为默认字体,serif为衬线字体,fraktur德文黑字体,1和0代表有和无,精细区分时可使用。
6、生成训练文件
tesseract num.hand_num.exp0.tif num.hand_num.exp0 -l eng --psm 7 nobatch box.train
运行后在目标文件夹生成文件num.hand_num.exp0.tr。
7、生成字符集文件
unicharset_extractor num.hand_num.exp0.box
运行后在目标文件夹生成文件unicharset。
8、生成shape文件
shapeclustering -F font_properties -U unicharset -O num.unicharset num.hand_num.exp0.tr
运行后在目标文件夹生成文件num.unicharset和shapetable。
9、生成聚集字符特征文件
mftraining -F font_properties -U unicharset -O num.unicharset num.hand_num.exp0.tr
运行后在目标文件夹生成文件inttemp和pffmtable。
10、生成字符正常化特征文件
cntraining num.hand_num.exp0.tr
运行后在目标文件夹生成文件normproto。
11、对特征文件更名
rename normproto hand_num.normproto
rename inttemp hand_num.inttemp
rename pffmtable hand_num.pffmtable
rename unicharset hand_num.unicharset
rename shapetable hand_num.shapetable
12、合并训练文件
combine_tessdata hand_num.
注意命令中最后有个小数点,运行后在目标文件夹生成文件hand_num.traineddata。
13、将最终生成的训练数据文件hand_num.traineddata复制到Tesseract-OCR软件安装路径的tessdata目录下,以后Tesseract即可将其作为新的语言识别包使用。
训练效果测试:
随机从上面5张手写数字图片中截取数字,拼成由一串数字构成的手机号码digit.png,然后对比训练前后的识别效果。
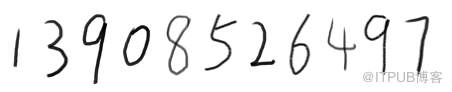
不使用训练后的语言包,直接使用默认识别
tesseract digit.png digit1
识别结果:1390652649]
使用训练后的语言包来识别
tesseract digit.png digit2 -l hand_num
识别结果:13908526497
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/28974745/viewspace-2218659/ ,如需转载,请注明出处,否则将追究法律责任。

