集合
同一类对象组合在一起,我可以称之为集合,通常在我们处理返回值的时候,可能需要返回一系列字符或字符串,这个时候需要集合来封装,也就是我们常见的JSON串,我们将新数据之间插入到队伍尾部,觉得没什么不妥,但是当我们想插入某条数据到指定位置,删除某条数据,或者是直接访问某条数据时就很容易联想到最基本的数据结构,数组和链表。
数组
一串连续的地址,而且大小是固定的。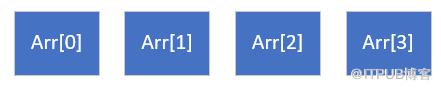
优点:访问地址时可以通过下标直接访问
缺点:长度不可变,容易出现浪费或者不够用的情况。插入数据时,如果不是末尾,则需要移动插入位置之后的所有地址。
链表(单向)
有内容项和节点组成的结构体。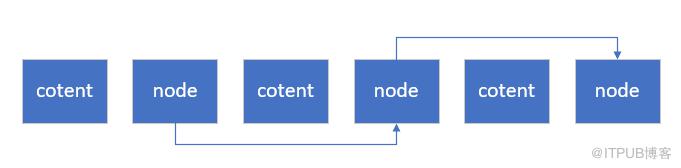
优点:插入数据时只需要修改节点,长度可变。
缺点,访问节点时需要遍历,不能直接访问下标。
结合以上所有优点
一块磁盘,当时空磁盘时,你存储可以从头开始,但是当你存储了1T时,你还需要从头开始遍历找到最后一个位置吗?显然有点浪费时间,而且磁盘位置那么多,为什么要排排坐的存储呢?于是我们设计成了“随机”存储,即磁盘有空位就存,但是这个随机,又不能覆盖已经存储过的位置,于是我们希望通过一个算法,带入一个值,如果这个算法算出来这个位置没有被占用,就存进去,如果被占用了,就在它的后面继续查找,这样存储速度会大大增加。
pos=key%size 算法
一个磁盘,一个物理存储结构,一旦给到你,其实大小肯定是已知的,那么从我们入手这块存储空间的时候,就是已知大小的了,于是我们可以把它赋值给 size ,当你想存储某个数值的时候,我们需要进行计算,这里赋值给 key,我们取余之后算出一个位置进行存储。
举个例子,假设有10个节点要进行存储,用上述算法对100、402、301进行存储
第一步, 100%10=0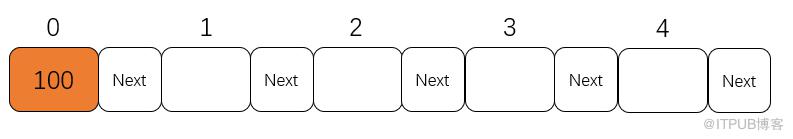
第二步,402%10=2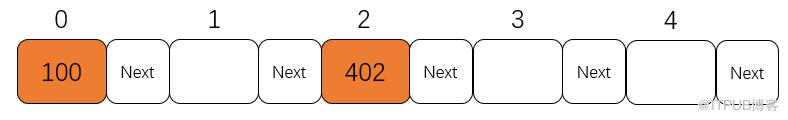
第三步,301%10=1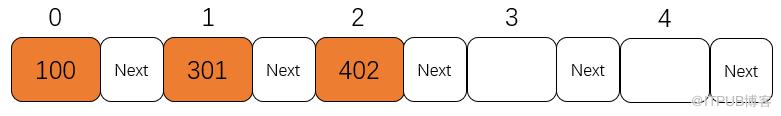
是不是很顺利,感觉瞬间就能掌握 Hash 原理了呢?然后没有那么简单,这个时候要插入90呢?
第五步,90%10=0,还是0,但是此时0已结被存储了100,那么90该放到哪里呢?
哈希冲突
通过 Hash 算法存值方式计算发现该地址已结存在了值,就发生了 Hash 冲突。我们在这里可以先将值存储在已结存在的节点之后,如果大小比较有问题,也就是如果新值比旧值小,则放在节点之前。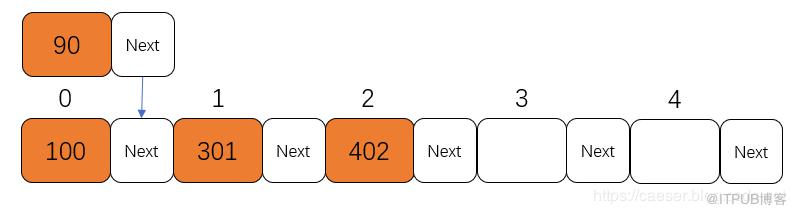
查找是否方便?
如果90和100这个节点一直被插入结果为0的节点,当我每次想对该节点进行大小比较时,是不是都要遍历一次,这个节点岂不是非常的臃肿?怎么办?
红黑树
如果我希望从根节点访问对任意一个叶子节点路径长度都比较类似,类似平衡的路径,这就是红黑树。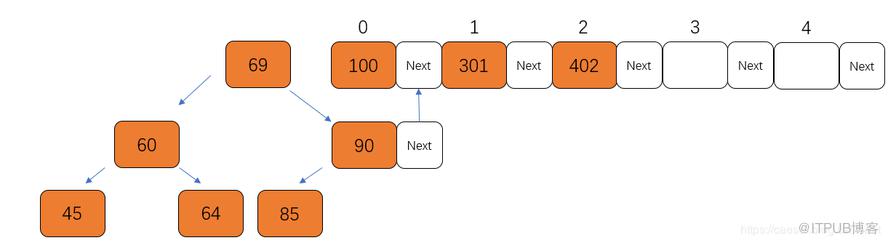
总结
- hashmap 的数据结构包括了初始数组、链表、红黑树;
- 插入数据的时候使用 pos= key % size 来进行插入数据;
- 当两个或者两个以上的key,且 key 不同 pos 相同时,发生冲突,就会挂在数组初始化位置的链表之后;
- 当某个节点出现过多的链表节点的时候,就会转换成红黑树以提高效率;
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/201/viewspace-2823955/ ,如需转载,请注明出处,否则将追究法律责任。

