由于Hive 是运行在Hadoop 下的数据仓库,所以必须在已经安装好Hadoop 的环境下运行Hive ,且要正确配置HADOOP_HOME 环境变量。本书讲解的Hive 运行在2.2.2 小节搭建的Hadoop 伪分布式环境的基础上,我们可以利用CentOS7-201 虚拟机(如图2-35 所示)进行Hive 的安装与配置。
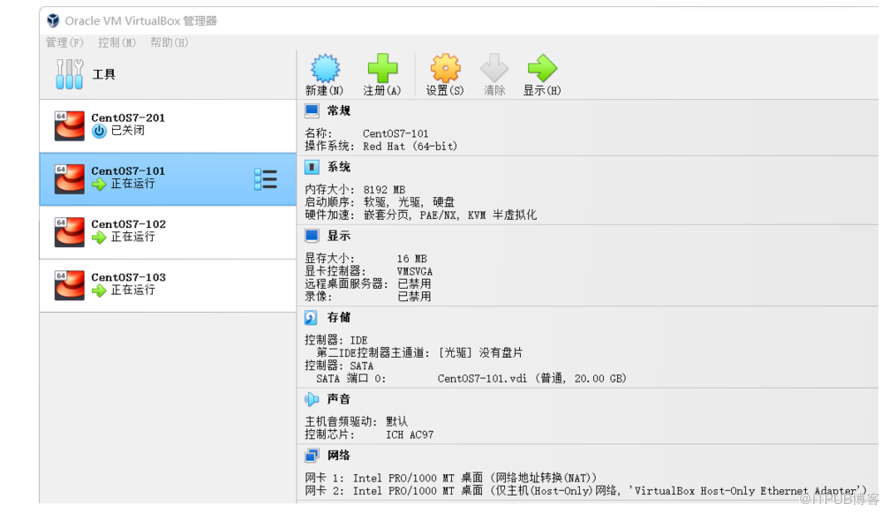
图2-35 Hadoop 完全分布式环境
(1)下载、安装和配置Hive
Hive 官网:
安装包具体下载地址:
这里选择下载Hive 3.1.3 版本,文件名为apache-hive-3.1.3-bin.tar.gz 。
(2)上传并解压Hive
把下载下来的Hive 安装包文件上传到当前用户hadoop 的主目录,再解压Hive 安装包文件:
[hadoop@server201 app]$ tar -zxvf ~/apache-hive-3.1.3-bin.tar.gz -C .
目录名称太长了,修改一下名称:
[hadoop@server201 app]$ mv apache-hive-3.1.3-bin/ hive-3.1.3
配置Hive 的环境变量是可选的,目的是为了方便执行Hive 脚本:
export HIVE_HOME=/app/hive-3.1.3
export PATH=$PATH:$HIVE_HOME/bin
接下来配置hive-site.xml ,Hive 的conf 目录下没有这个文件,可以自己创建一个,内容如下:
<?xml version="1.0" encoding="UTF-8" standalone="no"?>
<?xml-stylesheet type="text/xsl" href="configuration.xsl"?>
<configuration>
    <property>
        <name>hive.exec.scratchdir</name>
        <value>hdfs://server201:8020/hive/scratchdir</value>
    </property>
    <property>
        <name>hive.exec.local.scratchdir</name>
        <value>/app/hive-3.1.3/datas</value>
    </property>
    <property>
        <name>hive.downloaded.resources.dir</name>
        <value>/app/hive-3.1.3/datas</value></property>
    <property>
       <name>hive.scratch.dir.permission</name>
       <value>700</value>
    </property>
    <property>
       <name>hive.querylog.location</name>
       <value>/app/hive-3.1.3/datas</value>
    </property>
    <property>
        <name>hive.metastore.warehouse.dir</name>
        <value>/app/hive-3.1.3/datas</value>
    </property>
    <property>
        <name>hive.metastore.local</name>
        <value>true</value>
    </property>
    <property>
        <name>datanucleus.schema.autoCreateAll</name>
        <value>true</value>
    </property>
</configuration>
(3)启动 Hadoop ,登录 Hive 命令行
启动Hadoop 。
[hadoop@server201 app]$ /app/hadoop-3.2.3/sbin/start-dfs.sh
[hadoop@server201 app]$ /app/hadoop-3.2.3/sbin/start-yarn.sh
使用hive 脚本登录Hive 命令行界面时,Hive 要访问Hadoop 的core-site.xml 文件,并访问fs.defaultFS 所指的服务器。
接下来初始化Derby 元数据库,注意这个Derby 是Hive 内嵌的,不支持多个Hive 客户端连接:
[hadoop@server201 app]# cd /app/hive-3.1.3/bin
[hadoop@server201 bin]#./schematool -initSchema -dbType derby
登录Hive 的命令行:
[hadoop@server201 ~]$ hive
hive>
登录Hive 的命令行后,就可以学习基本的SQL 操作命令了。
(4)类似于MySQL的SQL命令,都可以在Hive下运行。
比如,查看所有数据库:
hive> show databases;
OK
default
Time taken: 0.025 seconds, Fetched: 1 row(s)
查看默认数据库下的所有表:
hive> show tables;
OK
Time taken: 0.035 seconds
创建一个表,并显示这个表的结构:
hive> create table stud(id int,name varchar(30));
OK
Time taken: 0.175 seconds
hive> desc stud;
OK
id                    int
name                  varchar(30)
Time taken: 0.193 seconds, Fetched: 2 row(s)
Hive 安装成功了,接下来就可以开始学习HQL 的操作了。
本文节选自《 Hive 入门与大数据分析实战》,内容发布获得作者和出版社授权。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/18841117/viewspace-2956963/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- 《提示词竞争力:与大模型高效对话》全文分享~~
- 王晓华智能体开发入门书《AI Agent智能体与MCP开发实践:基于Qwen3大模型》全文分享~
- 《DeepSeek原生应用与智能体开发实践》全文分享~~
- 邓立国LangGraph开发必读书《LangGraph开发AI Agent实践》全文试读~
- 邓立国Agent开发入门必读书《AI Agent智能体开发实践》全文试读
- 王晓华AE开发入门书《智能体工程驱动AI Agent开发》全文试读~
- (清华大学出版社)人工智能技术丛书介绍
- 《千问高效办公的方法和技巧》全文分享~
- 《豆包高效办公的方法和技巧》全文分享~
- 《扣子编程:从零开始搭建智能体》全书案例分享~
