python简单网络爬虫获取网页数据
下面以获取智联招聘上一线及新一线城市所有与BIM相关的工作信息以便做一些数据分析为列
1、首先通过chrome在智联招聘上搜索BIM的职位信息,跳出页面后ctrl+u查看网页源代码,如没有找到当前页面的职位信息。然后快捷键F12打开开发者工具窗口,刷新页面,通过关键字过滤文件,找到一个包含职位的数据包。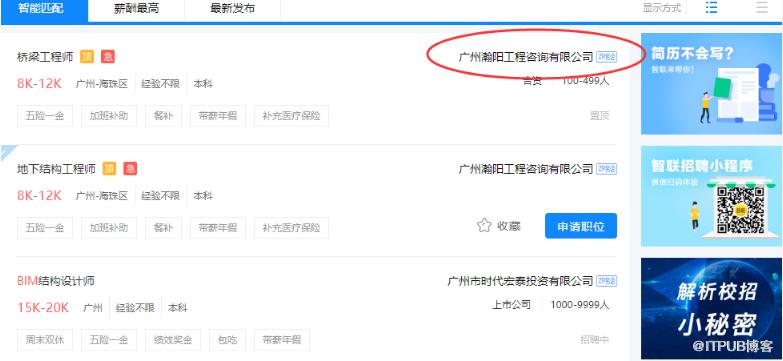
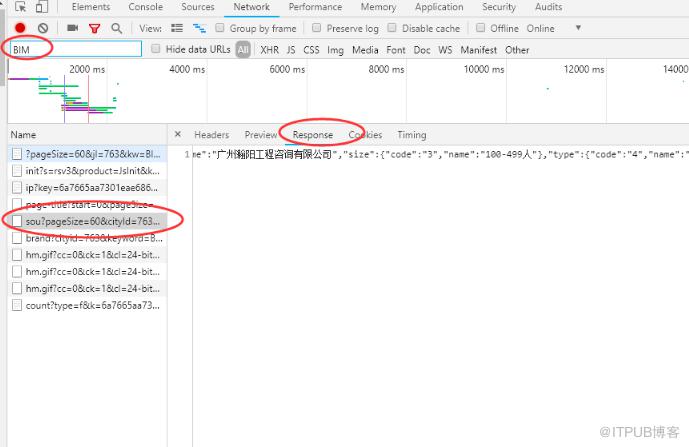
2、查看这个文件的请求URL,分析其构造发现数据包的请求URL由
‘https://fe-api.zhaopin.com/c/i/sou?’+请求参数组成,那么根据格式构造了一个新的url(
‘https://fe-api.zhaopin.com/c/i/sou?pageSize=60&cityId=763&workExperience=-1&education=-1&companyType=-1&employmentType=-1&jobWelfareTag=-1&kw=造价员&kt=3’)
复制到浏览器进行访问测试,成功获得相应数据
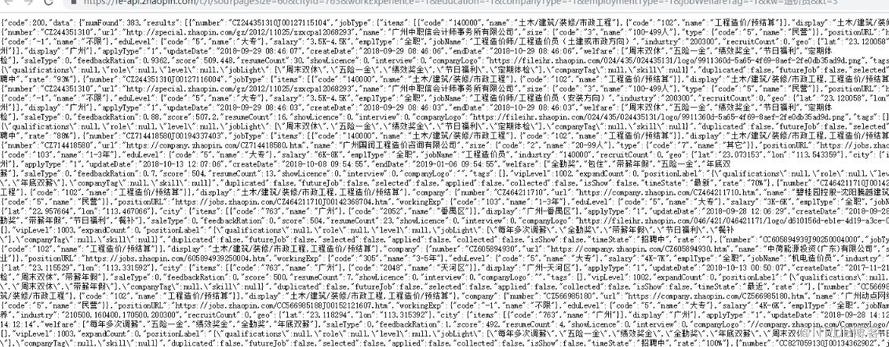
3、取得的为json格式数据,先将数据格式化,分析构造,确定代码中数据的解析方法。
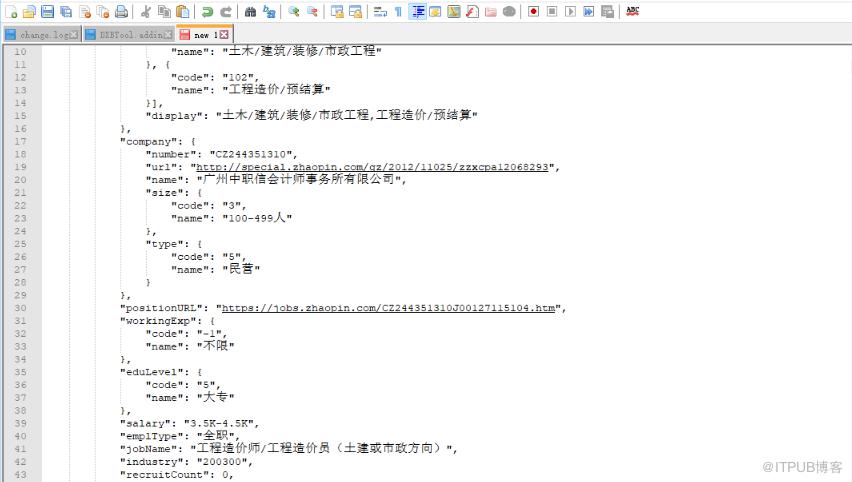
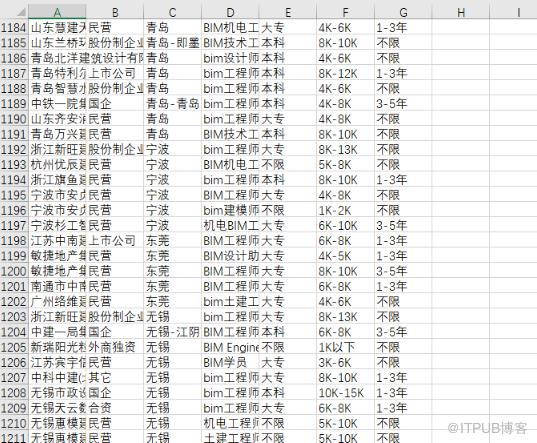
4、 请求URL及数据结构都清楚后,剩下的就是在代码中实现URL的构造、数据解析及导出。最后获得1215个数据,还需进一步对数据进行整理,以便进行数据分析。
推荐:[MYSQL课程]
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/1469/viewspace-2833848/ ,如需转载,请注明出处,否则将追究法律责任。
上一篇:
python中main函数是什么意思
下一篇:
mysql中的“in”什么意思

请登录后发表评论
登录
全部评论
