第76期 明明Oracle表LCADDRESS列定义VARCHAR2(80)ORA-12899报错值太大
明明Oracle表LCADDRESS的 "COMPANYADDRESS"列定义VARCHAR2(80),但是开发再执行update语句时,还是报错,ORA-12899报错"COMPANYADDRESS" 的值太大 (实际值: 82, 最大值: 80),开发同事使用update更新数据时使用如下sql时收到了ORA-12899的错误。update的sql进行了简化。
 update LCADDRESS set
 COMPANYADDRESS = SUBSTR(
        CASE
        WHEN COMPANYADDRESS LIKE '%区%' THEN SUBSTR(COMPANYADDRESS , 1, INSTR(COMPANYADDRESS , '区') + 1) || '测试路111号'
        WHEN COMPANYADDRESS LIKE '%县%' THEN SUBSTR(COMPANYADDRESS , 1, INSTR(COMPANYADDRESS , '县') + 1) || '测试路111号'
        WHEN COMPANYADDRESS LIKE '%市%' THEN SUBSTR(COMPANYADDRESS , 1, INSTR(COMPANYADDRESS , '市') + 1) || '测试路111号'
        ELSE '辽宁省大连市沙河口区测试路111号'
        END,
        1,
        80
)
where 【你的条件】;[object Object]
问题根源
SUBSTR(CASE ... END,1,80)
⚠️ 误区:Oracle
SUBSTR(字符,1,80) 是
字符个数,看着限制 80;
但是!拼接过程中间产物有可能先超出,或者你存在 中文 + 符号组合计算偏差?仔细看:
SUBSTR( 【拼接结果】 ,1,80)
理论上最终结果≤80,为什么还报 12899?
两种真实场景:
场景 1:拼接后的字符串本身超长,SUBSTR 外层包裹位置写错(你当前写法语法没问题,但有一个坑)
SUBSTR(
    CASE ... || '测试路111号'
    END,1,80)
重中之重!
VARCHAR2(80)
CHAR:COMPANYADDRESS VARCHAR2(80) -- 默认字节 byte
SUBSTR(xxx,1,80) 是
按字符截取。假设截取 80 个汉字,80*3=240 字节,远远超过 80 字节 →
ORA-12899!这就是你报错最可能的根因!场景 2:少数情况:instr 定位拼接后刚好临界溢出
测试路111号,刚好产生超长字符串。验证字符集定义
-- 查看字段定义(区分byte/char)
SELECT COLUMN_NAME,DATA_TYPE,DATA_LENGTH,CHAR_USED
FROM USER_TAB_COLUMNS
WHERE
TABLE_NAME='LCADDRESS' AND COLUMN_NAME='COMPANYADDRESS';
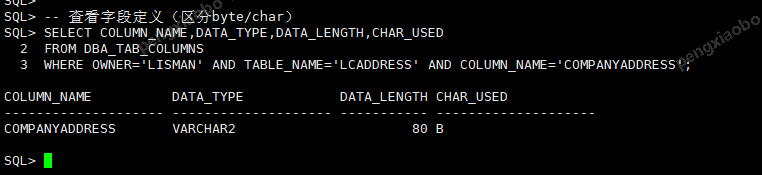
-
CHAR_USED = B→ 按字节存储(高危,你现在大概率是这个) -
CHAR_USED = C→ 按字符存储
方案一【优先推荐,修改 SQL,按字节截断兼容 byte 模式】
UTL_RAW.CAST_TO_RAW +
SUBSTRBCOMPANYADDRESS = UTL_RAW.CAST_TO_VARCHAR2( SUBSTRB(UTL_RAW.CAST_TO_RAW( CASE WHEN COMPANYADDRESS LIKE '%区%' THEN SUBSTR(COMPANYADDRESS , 1, INSTR(COMPANYADDRESS , '区') + 1) || '测试路111号' WHEN COMPANYADDRESS LIKE '%县%' THEN SUBSTR(COMPANYADDRESS , 1, INSTR(COMPANYADDRESS , '县') + 1) || '测试路111号' WHEN COMPANYADDRESS LIKE '%市%' THEN SUBSTR(COMPANYADDRESS , 1, INSTR(COMPANYADDRESS , '市') + 1) || '测试路111号' ELSE '辽宁省大连市沙河口区测试路111号' END ), 1, 80))
SUBSTRB 针对字节截断,保证最终占用字节 ≤80,杜绝 ORA-12899。
方案二【治本,修改表定义(长期建议)】
ALTER TABLE LCADDRESS MODIFY COMPANYADDRESS VARCHAR2(80 CHAR);
SUBSTR(...,1,80) 按字符截断,不会出现中文多字节溢出。方案三:调整业务逻辑,提前缩短拼接内容(不推荐,改动业务规则)
优化你原始 SQL 的小 bug(INSTR 风险)
如果字段 ** 不存在「区 / 县 / 市」之外进入 else 没问题,但有一种边界:
INSTR(COMPANYADDRESS,'区')+1 逻辑示例:
沙河口区 → INSTR 找到 “区” 位置 N,SUBSTR 取 1~N+1,包含 “区”;然后拼接后缀。
逻辑本身没问题。
完整可直接执行 UPDATE 语句范本(字节安全版)
UPDATE LISMAN.LCADDRESSSET COMPANYADDRESS = UTL_RAW.CAST_TO_VARCHAR2(
    SUBSTRB(UTL_RAW.CAST_TO_RAW(
        CASE
            WHEN COMPANYADDRESS LIKE '%区%' THEN SUBSTR(COMPANYADDRESS , 1, INSTR(COMPANYADDRESS , '区') + 1) || '测试路111号'
            WHEN COMPANYADDRESS LIKE '%县%' THEN SUBSTR(COMPANYADDRESS , 1, INSTR(COMPANYADDRESS , '县') + 1) || '测试路111号'
            WHEN COMPANYADDRESS LIKE '%市%' THEN SUBSTR(COMPANYADDRESS , 1, INSTR(COMPANYADDRESS , '市') + 1) || '测试路111号'
            ELSE '辽宁省大连市沙河口区测试路111号'
        END
    ), 1, 80))WHERE 【你的条件】
快速总结
-
90% 概率原因: 字段 VARCHAR2 (80) 是字节模式,中文占用多字节,按字符 substr (1,80) 依然超字节上限;
-
临时解决方案:使用
SUBSTRB按字节截断; -
根治方案:修改字段为
VARCHAR2(80 CHAR); -
不要单纯依赖外层
SUBSTR(xx,1,80)在字节模式下防止超长。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/12798004/viewspace-3176987/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- 第88期 Oracle执行计划,彻底搞懂Oracle的执行计划 III
- 第87期 Oracle执行计划,彻底搞懂Oracle的执行计划 II
- 第86期 Oracle执行计划,彻底搞懂Oracle的执行计划
- 第85期 为什么直方图和绑定变量一起使用时,有时会引发性能问题
- 第84期 查询RAC之间私网的流量信息,监控 RAC 私网流量变化
- 第83期 MySQL JSON Duality View + HeatWave Vector Search for RAG
- 第82期 Oracle 19c RAC集群:如何在线迁移/替换 OCR 磁盘组
- 第81期 批量抓取数据库中耗时最高的SQL自动生成【Active HTML格式的SQL Monitor报告】
- 第80期 追踪 SQL 性能随时间变化、执行计划是否漂移、资源消耗变化
- 第79期 Oracle Buffer Busy Waits 等待事件 P3 参数详解
