基于 3 类具身智能场景,多模态数据底座统一架构实践
编者按
在具身智能加速落地的当下,“模型”与“算力”之外,数据正悄然成为决定技术迭代速度与能力边界的真正变量。多模态、高复杂度的数据挑战面前,拼装而成的传统方案已显乏力。
本文从 OceanBase AI 湖库的实践视角切入,系统拆解具身智能数据管理的四重困境,并展示如何以统一底座重构数据管理逻辑,打通从采集入库、处理加工、检索快照到训练供给的完整闭环,为行业构建高效、智能的数据基础设施提供可落地的参考路径。
本文作者为 OceanBase 互联网与 AI 科技行业解决方案负责人半涯,全文共 2587 字,阅读约需 5 分钟。
过去两年,具身智能行业讨论最多的词是“模型”和“算力”。VLA、世界模型、扩散策略,一轮接一轮的技术叙事让整个行业兴奋不已。但真正跑过具身模型训练的人都知道,最让人头疼的往往不是模型结构本身,而是数据。
数据,是具身智能走向真实世界的关键底座,也是决定模型迭代效率与能力边界的底层变量。
一台机器人在真实场景里跑一小时,产生的是多路摄像头视频、深度点云、关节角度、力触觉信号、IMU、语言指令,以及一连串带有时间戳的动作轨迹。这些数据格式各异、时间轴需要对齐、标注成本极高。
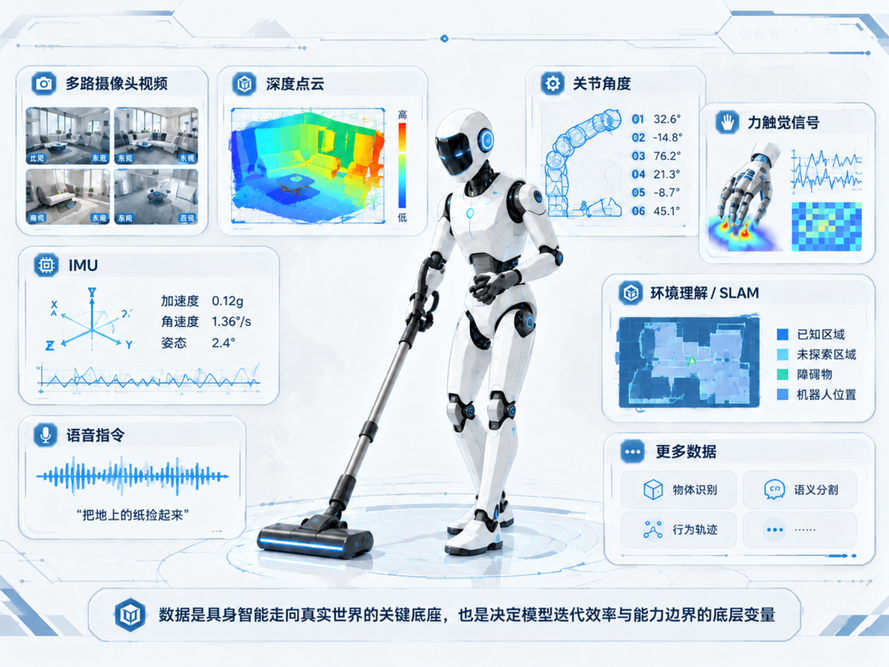
而当每个企业同时运行几十台甚至上百台机器人,同时还在进行遥操作采集、EGO 采集和仿真生成的时候,数据量会以令人生畏的速度膨胀。
大部分具身团队起步时,数据底座是拼出来的:对象存储放原始文件,关系库管元数据,向量库存 embedding,标注平台单独建设,训练脚本直接从文件系统遍历、筛选、读数据。
这套方案在数据量小的时候能用,但当数据量跨过某个阈值,四个断层会同时出现:
第一,多模态数据被割裂在不同系统里。 视频在对象存储,点云在另一个桶,关节状态和轨迹在 HDF5/Parquet,标签和元数据在关系库。一次“找出所有抓取失败且涉及透明物体的任务片段”的查询,需要跨三四个系统手工拼接。
第二,元数据和内容脱节。 你知道有一个视频文件,但你不一定知道它对应哪个任务、哪台机器人、哪个场景、成功还是失败。元数据散落在标注工具的输出、采集日志和某个工程师的 JSON 文件里,无法形成可检索的数据资产。
第三,训练读取成为 GPU 瓶颈。 具身数据大、读取模式复杂,如果底层存储没有为训练场景做优化,GPU 会在数据加载上大量空转。算力越贵,空转越致命。
第四,采集和训练之间没有闭环。 模型在哪些场景失败、需要补什么数据、上一轮采的数据到底用上了没有,这些信息无法系统性地反馈给采集端。结果是重复采集、盲目标注、迭代靠直觉。
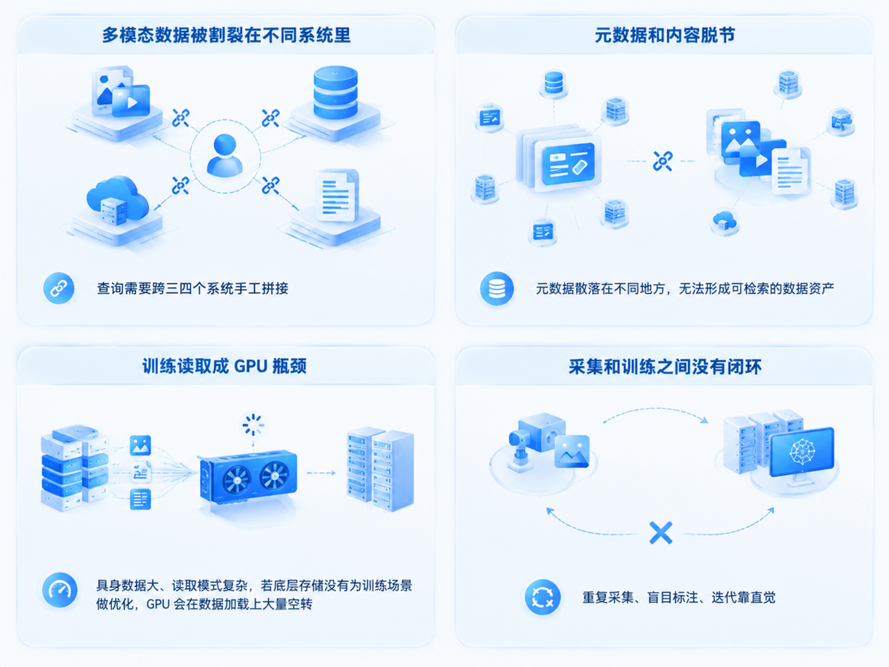
这些问题叠加在一起,就是行业里说的“端到端数据与模型衔接断裂”。
随着具身智能行业数据拐点的来临,原始的组合方案已经无法满足海量具身智能数据的存储和检索需求。
行业需要的,是一个能在同一套引擎里统一管理结构化与多模态数据、支持跨模态混合检索、并且能按训练需求高效供给数据的底座。
OceanBase AI 湖库正是为此而生。结合多模态数据处理与开发平台,旨在装下一切形态的数据。
核心创新“AI 多模表”,可在单张表中存储标签、元数据以及视频、音频、图片等大文件,并内置向量化嵌入存储能力,无需额外组件即可实现多模态数据的统一存储与语义化管理。
OceanBase 以“半全栈式”开放理念承接这一底座:训练之前的所有数据环节(采集入库、处理加工、检索快照、训练供给)在一套底座内完整包下。同时以一体化交付,技术生态、算子业务、部署模式全面开放,确保用户易用顺滑、可升级、不被绑定。
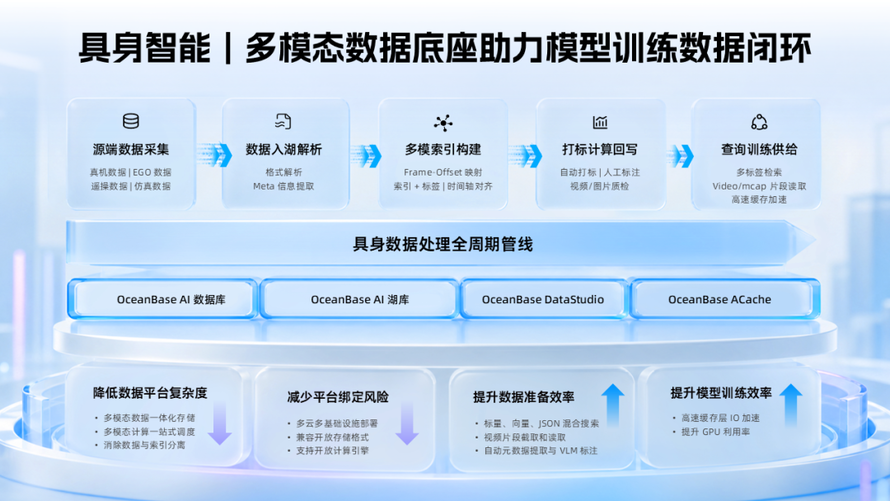
数据采集与入库
OceanBase AI 湖库以三层架构实现统一存储:
底层存算分离,数据存对象存储、计算独立伸缩,应对突发负载;
中层的 AI 多模表统一结构化、半结构化、非结构化及多模态数据,单表可存标签、元数据、视频/音频/图片等大文件,并内置向量嵌入能力,为语义检索打基础;
上层开放计算,统一支持 SQL(OLTP/OLAP/AI 搜索)、Spark ETL、Daft on Ray AI 加工,多引擎共享同一份数据,实现湖库一体。
对具身数据而言,这意味着一段遥操作采集的视频、对应的关节角度序列、语言指令,以及该片段的场景标签和成功/失败标注,可以全部放入同一行数据中统一管理,无需再跨系统做 ID 映射和时间对齐。
数据处理与加工
OceanBase AI 湖库算子平台为具身行业提供数据规整与质量治理能力。
数据入库后,平台通过 AI 湖库引擎完成元数据提取、规整、标注与质检,并将处理结果回写至多模态表,形成数据治理闭环。
平台既提供视频元数据提取、图片元数据提取、图片格式转换、图片文本向量化嵌入等开箱即用的通用算子,也提供面向具身智能的 MCAP/视频 meta 数据提取、VLM 自动打标、人工达标、自动数据质检、具身任务分片达标、长视频子任务截取、多传感器时序关联等行业特定算子,同时支持用户托管自有算法算子,与标准算子联动编排,底层基于 AntRAY 引擎提升任务容错性与资源调度效率,从而降低多模态数据处理的落地成本。
数据检索与快照
OceanBase 统一混合检索与 Datastudio 能力,为具身行业提供训练数据精准筛选与实验可复现助力。
具身团队最消耗人力的环节之一,是从海量数据中筛选出适合当前训练目标的那一小部分。
OceanBase 支持向量、全文、标量、GIS 的统一混合搜索:先用结构化条件(机器人型号、任务类型、成功/失败)过滤,再用向量相似度召回视觉或轨迹相似的片段。
比如“找出所有在厨房场景中、涉及透明容器的抓取失败片段,且视觉特征与这组已知困难样本相似”——这类查询在拼装架构里几乎不可能实时完成,在统一底座上是一条 SQL。
同时,通过 Datastudio 组件,可利用多模态查询接口(标签或自然语言)灵活检索特定场景数据;并支持数据快照功能,锁定特定时间点的数据集以保障训练一致性。
训练供给
OceanBase ACache 训练加速与高吞吐读取能力,为具身行业提供 GPU 不空转助力。
筛选后的数据通过ACache 加速供给 GPU 进行预训练或后训练,实现从采集到训练的完整数据闭环:
ACache 训练加速:针对模型训练中高昂的 GPU 成本,消除存储 IO 瓶颈,确保 GPU 资源在 7×24 小时内保持高利用率,可灵活部署于各类训练环境,服务于本体公司、大脑模型公司及数据公司;
高吞吐并行读取:具身数据读取模式复杂,OceanBase 的存算分离架构和列式存储能力,使大规模训练数据集的随机读取和顺序扫描可高效并行——对于长周期训练任务,数据供给的稳定性直接决定了 GPU 的利用率。
具身智能的未来,是数据驱动下的自我进化:每一次采集、每一轮训练、每一次部署,都在让数据飞轮转得更快。OceanBase AI 湖库将扎根数据侧,随着行业一起走向规模化——从今天的训练数据底座,到未来的具身数据基础设施,持续为行业的每一次进化供能。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/69909943/viewspace-3185380/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- GPT-6 发布“Better prompt cache” - 企业级数据库实践
- 联通广东产互 × OceanBase AI 存储底座实践 - 企业级数据库实践
- 被 TKDE 接收OceanBase 最新论文让大模型合成数 - 企业级数据库实践
- 被 VLDB 2027 接收OceanBase 最新论文让数据库基 - 企业级数据库实践
- 交易时延降 10% 以上 - 企业级数据库实践
- 亮相中国通信展主论坛 OceanBase 发布通信 AI 一 - 企业级数据库实践
- 跑出 AI 新能力OceanBase 刷新国际 Data Agent - 企业级数据库实践
- OceanBase × MiniMax × 行业伙伴 - 企业级数据库实践
- 筑牢央国企数智底座!OceanBase 联合浪潮海岳推出 ERP 一体化数智融
- PowerContext 1.0.0 正式发布:前事有据 - 企业级数据库实践
