GPT-6 发布“Better prompt cache” - 企业级数据库实践
“新故相推,日生不滞。”
——王夫之,《尚书引义·太甲二》 [1]
模型收到的每一次请求,都会由“旧(上下文)”与“新(提示词)”进行交接。
Prompt Cache 要处理的就是这交界处的一笔账:旧的计算能不能继续使用,以及新的请求又需要付出多少代价。
背景
9 月 22 日,OpenAI 发布 《Better prompt caching for GPT-6》 [2],介绍了 GPT-6 缓存命中率的改进,以及监控、诊断和优化缓存的方法。
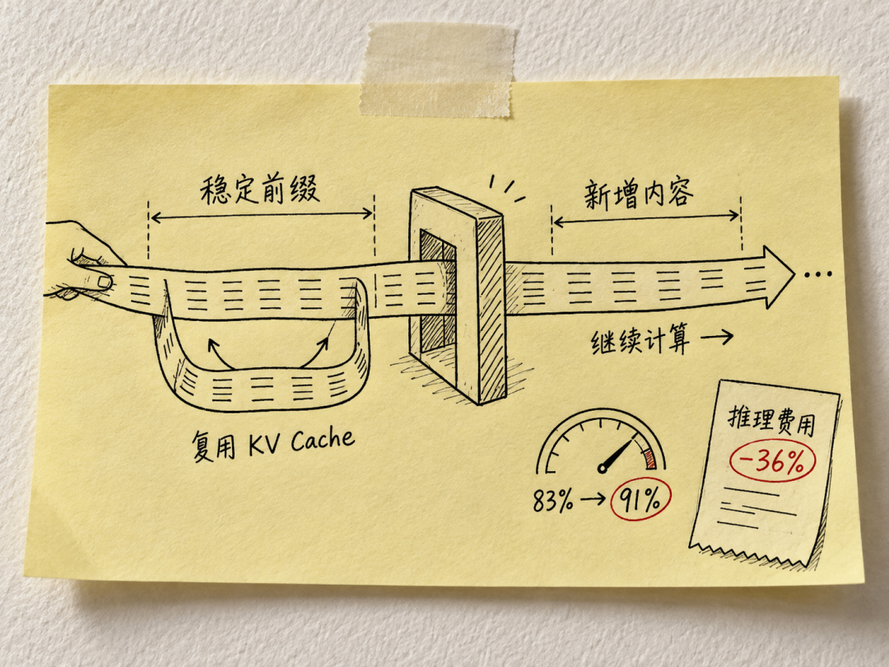
文章里提供了一组值得留意的数字:在相同评测负载下,调整缓存断点后,命中率从 83% 提升到 91%,推理费用下降了 36%。这几个数字,让提示词缓存的作用有了具体的分量。
提示词缓存(Prompt Cache) [3]保存的是模型处理输入时产生的中间计算状态,通常称为 KV Cache。后续请求的开头与已有缓存匹配,且满足复用条件时,模型就能接着利用这些状态。应用仍照常组织请求,新追加的内容仍需处理,回答也会针对本轮问题重新生成。
有了提示词缓存,同样的 Token,费用就会存在一些区别:普通输入、写入缓存、从缓存读取,分别会对应不同的价格。
欢迎大家关注 OceanBase 社区公众号“老纪的技术唠嗑局”。在这里,我们会持续为大家更新与 和 #Data 相关的技术内容~
Token 的三种身价
以 GPT-6 Sol 为例,按 OpenAI 当前公布的价格 [4],在 Standard 档位、短上下文计价范围内,三类输入的费用如下:
| 处理方式 | 每百万 Token 的费用 | 一万 Token 对应的费用 |
|---|---|---|
| 普通输入,不进行缓存写入 | 2 美元 | 0.02 美元 |
| 写入缓存 | 2.50 美元 | 0.025 美元 |
| 从缓存读取 | 0.20 美元 | 0.002 美元 |
写入缓存比普通输入贵四分之一,读取则只需普通输入价格的一成(表中的写入价已经包含这部分输入的处理费用)。
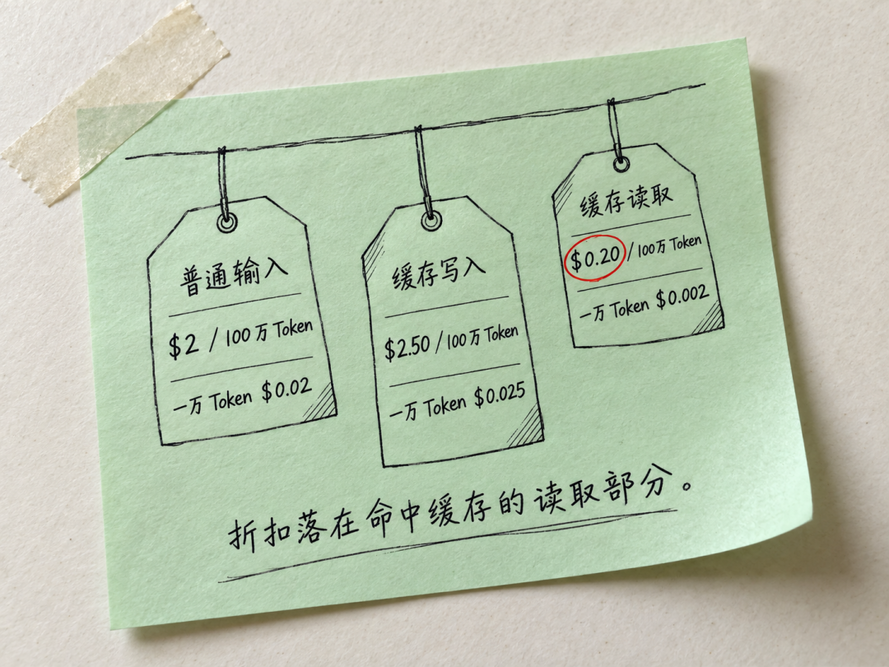
第一次写入、没有命中的输入和输出,各有各的账。这也就解释了“缓存输入最多便宜九成”究竟便宜在哪里 —— 折扣都落在了命中缓存的读取部分。
如果一段材料只用一次,付出写入费用后就再没有后续请求,那么便宜的读取价也就没有机会发挥作用。缓存的收益,要等下一次、再下一次复用的时候。
N 次调用之后
现在开始,只跟踪 Token 的共同前缀。
假设模型和计价档位不变,第一次完整写入缓存,接下来的九次请求都在缓存可用时完整命中。各轮新追加的内容、输出和工具费用先另列,我们只算这段重复材料。
| 调用阶段 | 处理方式 | 这段前缀的费用 |
|---|---|---|
| 第一次 | 写入一万 Token | 0.025 美元 |
| 第二次至第十次 | 每次读取一万 Token | 每次 0.002 美元 |
| 十次合计 | 一次写入,九次读取 | 0.043 美元 |
计算很直接:
0.025 + 9 × 0.002 = 0.043 美元。若同一段材料十次都按普通输入计费,费用基准则是
10 × 0.02 = 0.20 美元。
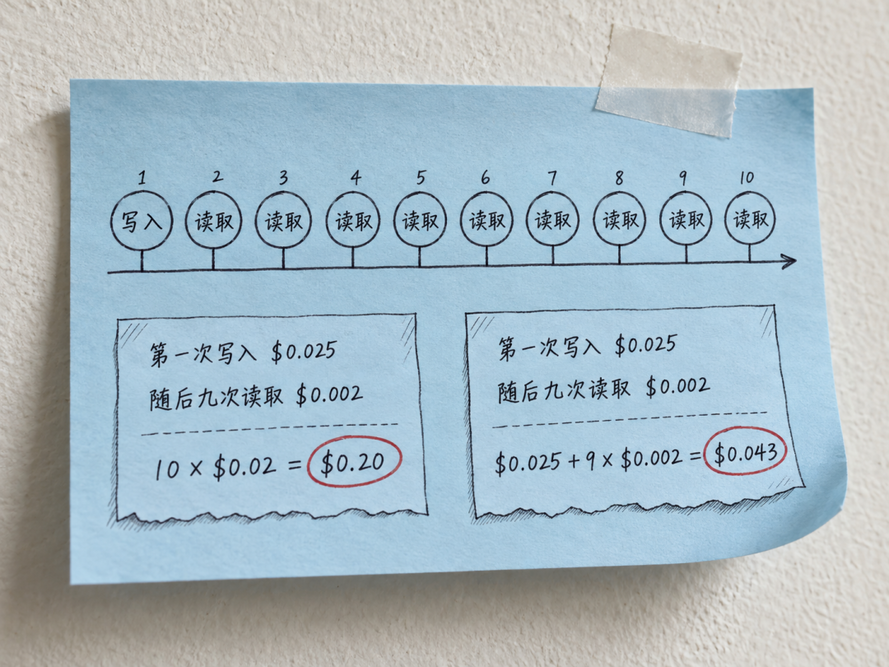
两边发送的都是同样长的材料。差额来自后九次复用了已有计算,而第一次较贵的写入,也计入了总额。
这是一道条件明确的纸面算例。不过在实际运行中,某一轮改了前缀,或后续请求没有找到可用缓存,账单就会发生变化。
一字之差
缓存识别的是:可以精确匹配的输入前缀。也就是说:同一个意思,换一种写法,未必还能复用原来的计算。
比如,应用每次都把当前时间写在一大段固定材料前面:
第一次:当前时间 09:00 → 固定材料 → 本轮问题
第二次:当前时间 09:01 → 固定材料 → 本轮问题
人看起来,两份材料几乎一样;变化却出现在固定材料之前,影响了后面前缀的匹配。在消息角色和指令优先级允许的前提下,把稳定内容放在前面、变化内容放在后面,才更有利于复用。
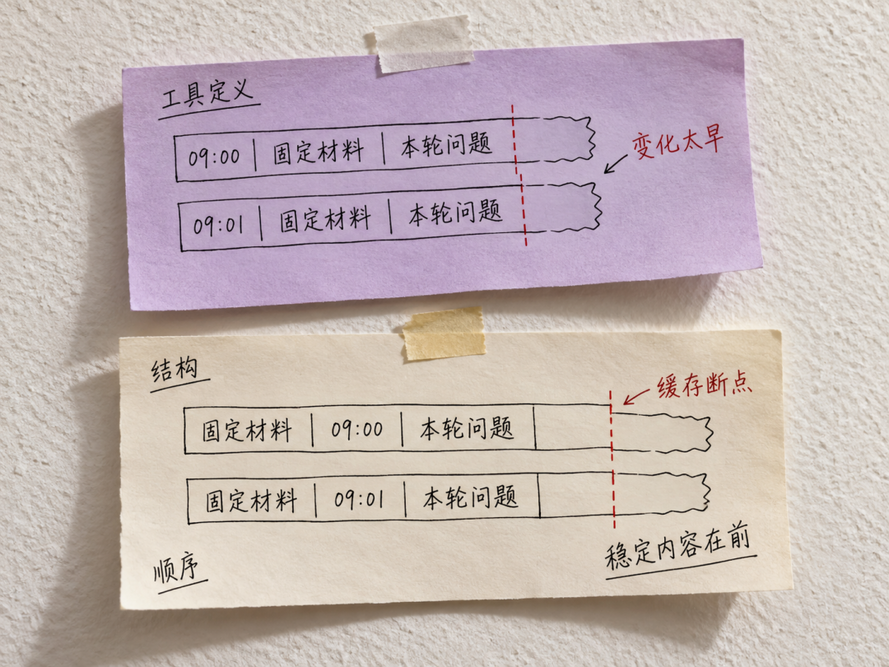
工具定义也会参与匹配。某一轮暂时不用一个工具,就把它从列表里删掉;下一轮需要时又加回来,这些改动也可能影响缓存。OpenAI 在这次文章中建议保持工具定义、结构和顺序稳定,通过
allowed_tools 等设置限制当前可以调用的工具。
如果希望明确指定稳定材料的结束位置,可以按照 OpenAI 的部署指南 [5]设置缓存断点。断点告诉系统在哪里尝试缓存和匹配前缀;设置了断点,仍要满足内容、配置和缓存可用性等条件。
“一字之差”并不意味着整份缓存必然作废,改动位置和缓存边界都会影响结果。GPT-6 当前还要求前缀至少达到 1,024 个可见输入 Token;默认的
30m 表示,从最近一次写入或复用起至少保留 30 分钟,服务端也可能保留更久。它既不是从第一次写入开始倒数半小时,也不意味着半小时一到就立即清空。
这些条件可以通过请求记录来检查。根据 OpenAI 的更新记录 [6],缓存仪表盘在 8 月 20 日发布,诊断工具在 9 月 8 日进入正式可用阶段,不能全算作 9 月 22 日的新功能。仪表盘帮助观察输入构成,缓存诊断工具 [7]则比较前后请求的模型、工具、配置和输入,提供未命中的线索。计费仍以实际用量为准,一次诊断命中也不代表整次请求都按缓存读取价收费。
已知接下来要用的材料,还可以提前预热,将一部分计算移到用户等待之前,写入费用仍然要算。用来预热的资料也得跟得上项目进展:昨天确认的约束是否还有效,刚跑完的测试对应哪个版本,都需要核对。该更新的内容仍应更新,即使这会影响原有缓存的复用。
除了 Prompt Cache,还需要什么?
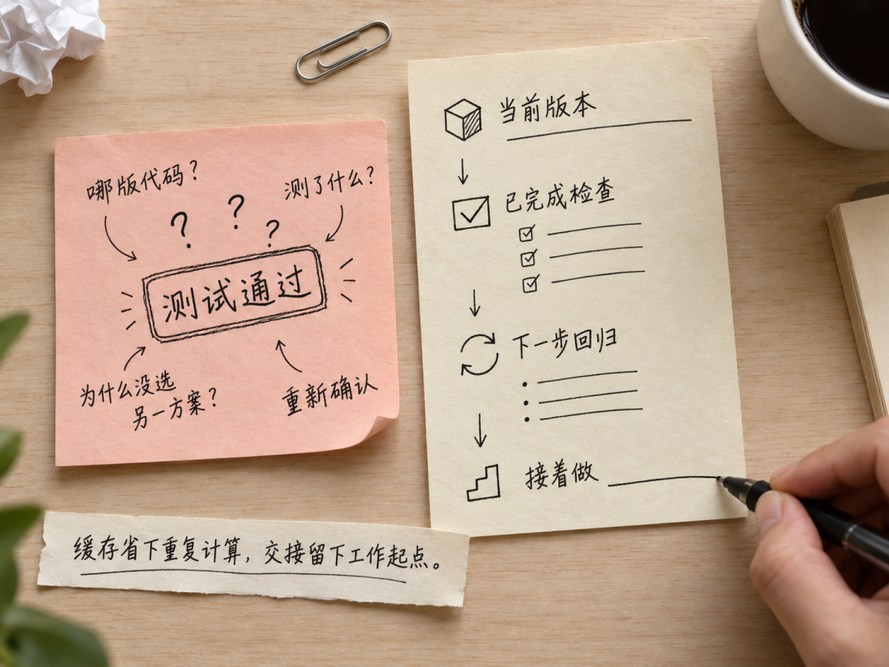
前一天收工时,一项功能修改可能只完成了一半:新功能已经通过测试,兼容旧客户端的回归还没跑。第二天换了一个专用 Agent 或开了一个新会话,处理后续的回归任务,接手的 Agent 就需要先弄清昨天停在了哪里。
聊天记录里有一句“测试通过”,但它对应哪一版代码、覆盖哪些检查?另一种实现方案讨论了很久,最后为什么没用?为了解决这些问题,需要 Agent 重新读代码、翻日志、确认约束,这些步骤又会产生调用和等待。
如果收工时留了交接笔记(项目记忆),接手时,就有了起点。上下文管理,除了提示词缓存,还需要 Context 的记忆。
PowerContext 登场
前面提到的 Prompt Cache,指的是模型推理服务端的计算状态缓存,也就是模型处理输入时算出的 Key、Value 张量,保存在模型厂商的服务器上。它们可以供模型处理后续内容、生成回答时使用,进而降低推理费用。
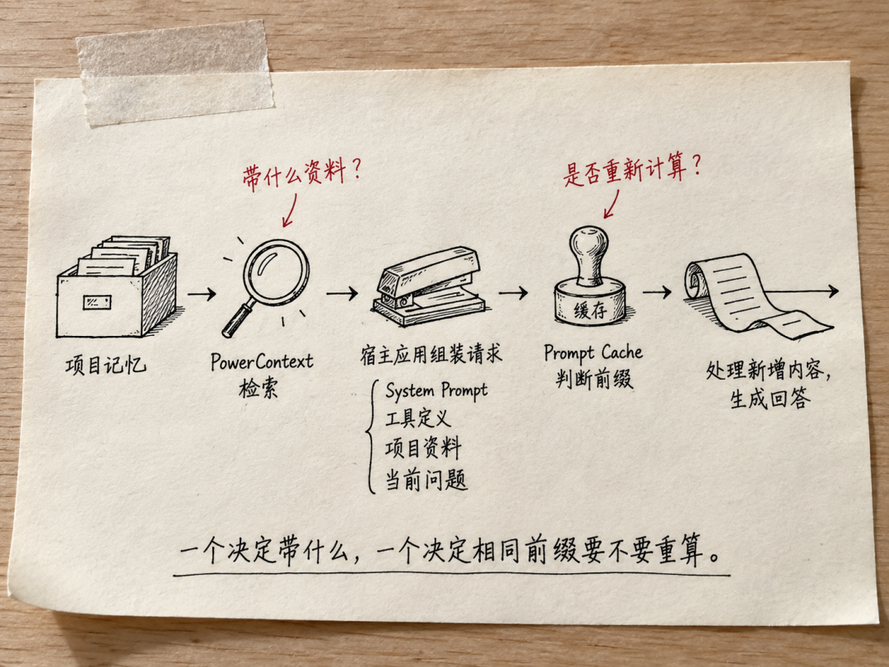
PowerContext 和 Prompt Cache 处在同一次模型调用的不同阶段,关系是互补的:
-
Prompt Cache 管的是 —— “相同资料是否需要重新计算”:请求到达 OpenAI 后,如果开头部分与已有缓存匹配,就复用此前产生的 KV 计算状态,降低推理成本。
-
PowerContext 管的是 —— “带什么资料”:从项目记忆中找出当前任务需要的约束、决策、历史经验和进度,组成这一次请求的“完整”上下文。
整个过程类似于:
PowerContext 检索项目记忆
        ↓
应用组装 System Prompt、工具定义和项目资料
        ↓
请求发送给 OpenAI
        ↓
Prompt Cache 判断前缀能否复用
        ↓
模型处理新增内容并生成回答
在 PowerContext [8] 中,反复使用的项目约束和决定可以连同依据保存为 Memory,按版本修订,失效后退役。当次做到哪一步、验证过什么、接下来补哪项检查,则通过单独准备和检查的 Handoff [9] 交给接手者。需要长期保留的交接里程碑,再按流程提交为持久记录。
到了下一轮,PreparedContext 根据当前问题选择相关的有效记忆和经确认的经验,在字节预算内返回材料;Handoff 仍走独立的交接流程。接手者收到资料后,还要对照当前代码和最新要求确认它们是否适用。
从这里到模型调用,中间还有宿主应用组织请求的一步。PowerContext 取回哪些项目资料,宿主把它们放在哪里,OpenAI 能复用哪一段计算,是三个分别需要检查的环节。连续几轮若使用相同版本的材料,且前缀、配置和缓存条件都满足,才可能命中;新的召回结果若改变了前缀,也可能影响复用。因此,接入 PowerContext 的价值应看它是否帮助工作接续,缓存效果则看实际请求,不能把两者画上等号。
记忆的代价
整理交接笔记、保存项目约束、为下一轮检索资料,都要花时间和资源。接入 PowerContext 后,这些步骤由哪些服务承担、发生了多少次,可以逐项记下来。
按照 PowerContext 的模型连接与能力配置 [10],从原始记录中抽取记忆可能需要生成模型;语义索引和检索涉及 Embedding;启用重排,还要计算相应调用。已经写清楚的项目约束可以直接保存为 Memory,不必为了存进去再调用一次生成模型。实际走了哪些步骤,应当以配置和调用记录为准。
数据库查询、存储索引、网络和部署维护同样需要计算。开源软件可以自行部署,机器上的算力、存储和维护时间仍然有成本。PowerContext 的后台模型连接也不会自动使用 Codex 或 Claude 的订阅登录额度,需要按所启用的能力配置相应服务。
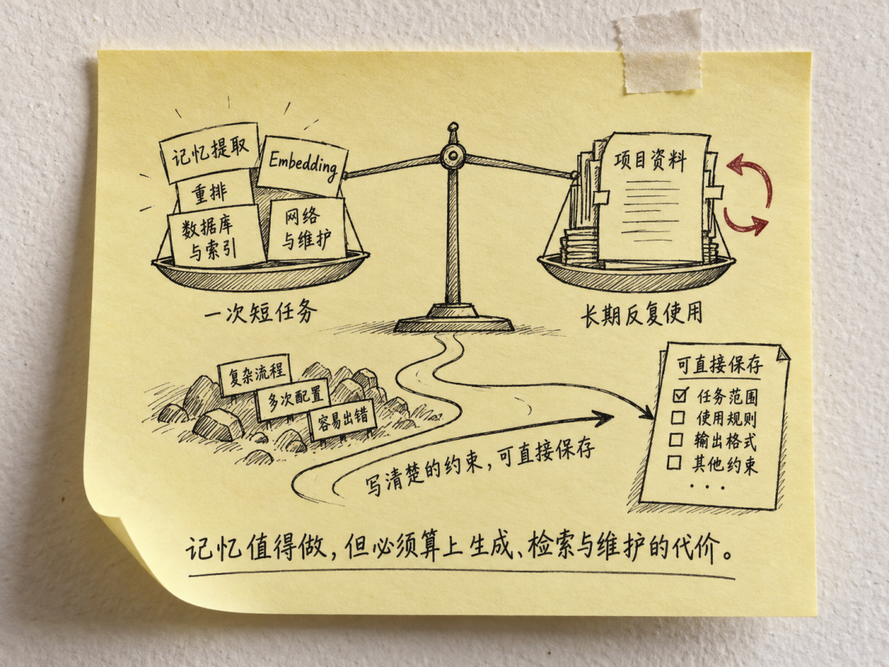
如果一个项目会反复用到相同约束,带来源、可修订的记忆就可能帮助后续任务少走一些重复步骤。若只是一次很短的临时工作,为它专门做提取、索引和维护,新增投入也可能超过收益。
判断 PowerContext 是否值得接入,需要看一项工作从开始到验收的完整支出。准备资料花了多少,接手后少查了哪些记录,有没有减少遗漏,都可以留下证据。单独拿一轮缓存读取的折扣,解释不了这笔投入是否划算。
任务账本
一项修改跨过几个会话之后,模型平台上的用量已经很难直接对应一次交付。哪笔费用是在写代码,哪笔是在准备项目记忆,哪笔又是漏跑测试后的返工?这些差别,单看输入与输出的总额分不出来。
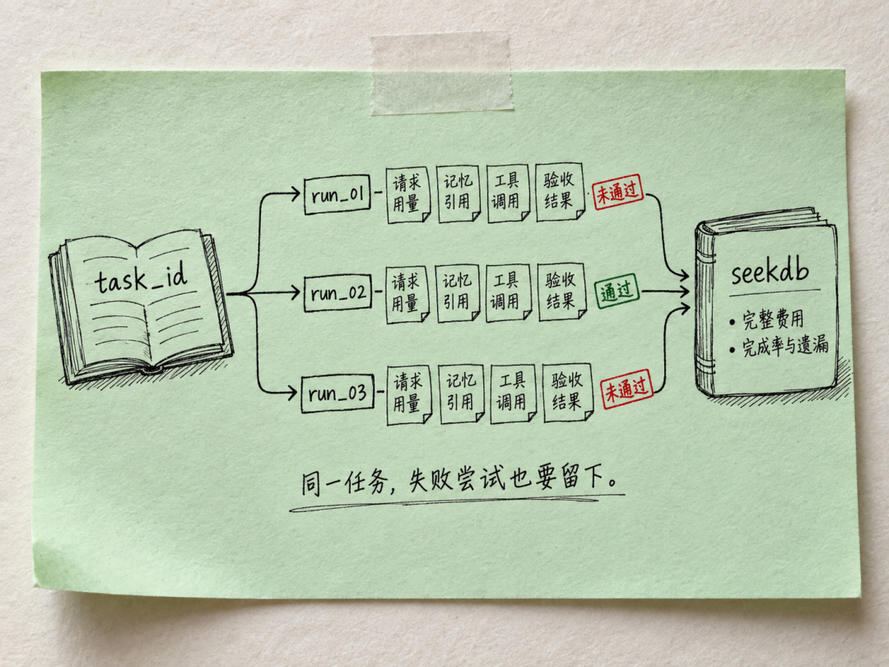
可以从任务开始时就分配编号,让后续请求、上下文准备、工具调用和验收结果都关联到这项工作。第二天继续,或者失败后重试,沿用同一个任务编号,再用各自的运行编号区分每次尝试。这样,昨天的进度和今天的支出才能放到一起查。
记录积累起来,关心的问题也会变得具体:哪套方案完整做完了这批任务?省下的钱来自更多缓存读取,还是少做了一轮检查?某次返工之前,Agent 收到的是哪一版项目约束?回答这些问题,需要把调用明细、记忆引用和验收记录关联起来。
这份任务账本可以用 seekdb [11] 来保存和查询。按任务编号关联请求与验收结果,就能汇总同一项工作的支出;保留方案、模型、服务档位、价格日期和记忆版本,便可以继续比较不同运行。seekdb 提供存储与查询,调用记录的采集、价格换算和图表由应用实现。
在设计对照时,固定一批任务、代码起点、模型和验收标准,先比较现有历史管理方式下请求布局调整前后的结果,再接入 PowerContext 做同样的比较。四组都保留原本可用的缓存能力,覆盖第一次运行、连续多轮和隔日接续。
前面的十次调用算例只解释一段固定前缀如何计费,这里的对照才用于评估应用完成整项工作的支出。汇总时,普通输入、缓存写入、缓存读取和输出分别计费;记忆提取、嵌入或重排若已经进入模型费用统计,就不能再加一遍。运行时间、上下文准备延迟和人工接手时间另列,没有明确工时单价时,不混成金额。
最终把完整批次的费用与完成率放在一起看,失败尝试已经花掉的钱也要保留。如果一组更便宜,却漏了旧客户端的回归测试,这份差异就应写在结果旁边。若接入 PowerContext 后减少了遗漏,但总费用增加,也应如实呈现。
尾声:我们买到的是什么?
给一项功能修改付费,我们期待的是功能可用、兼容性经过验证。缓存帮助重复输入复用计算,项目记忆与交接帮助后续工作找到约束、依据和进度,它们的效果都需要放回这项工作里衡量。
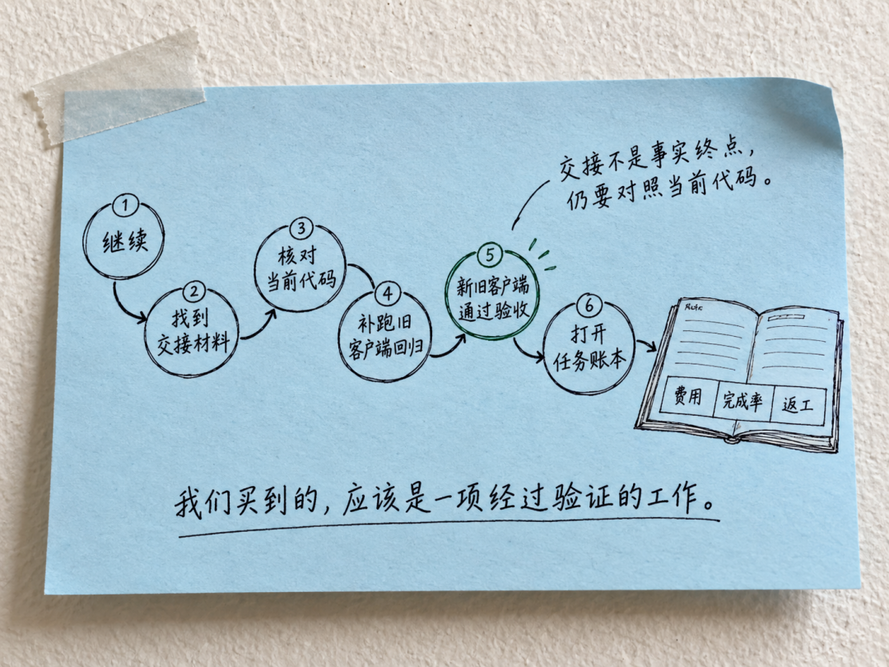
理想的情况是:第二天说一句“继续”,Agent 就能找到交接材料、核对当前代码,从尚未完成的回归测试重新做起。到新旧客户端都通过验收时,一切问题的答案也全都留在记录里。
参考资料[1] 《尚书引义·太甲二》: https://ctext.org/wiki.pl?if=gb&remap=gb&res=305255[2] 《Better prompt caching for GPT-6》: https://openai.com/index/better-prompt-caching-for-gpt-6/
[3] 提示词缓存(Prompt Cache): https://developers.openai.com/api/docs/guides/prompt-caching
[4] OpenAI 当前公布的价格: https://developers.openai.com/api/docs/pricing
[5] OpenAI 的部署指南: https://developers.openai.com/api/docs/guides/deployment-checklist
[6] OpenAI 的更新记录: https://developers.openai.com/api/docs/changelog
[7] 缓存诊断工具: https://developers.openai.com/api/docs/guides/prompt-caching/diagnostics
[8] PowerContext: https://powercontext.oceanbase.io/en/docs/get-started/core-concepts/
[9] Handoff: https://powercontext.oceanbase.io/en/docs/workflows/memory-and-handoff/
[10] 模型连接与能力配置: https://powercontext.oceanbase.io/en/docs/get-started/configure-models/
[11] seekdb: https://github.com/oceanbase/seekdb
立即试用 OceanBase 企业版,体验国产数据库能力 立即试用
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/69909943/viewspace-3185252/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- 基于 3 类具身智能场景,多模态数据底座统一架构实践
- 联通广东产互 × OceanBase AI 存储底座实践 - 企业级数据库实践
- 被 TKDE 接收OceanBase 最新论文让大模型合成数 - 企业级数据库实践
- 被 VLDB 2027 接收OceanBase 最新论文让数据库基 - 企业级数据库实践
- 交易时延降 10% 以上 - 企业级数据库实践
- 亮相中国通信展主论坛 OceanBase 发布通信 AI 一 - 企业级数据库实践
- 跑出 AI 新能力OceanBase 刷新国际 Data Agent - 企业级数据库实践
- OceanBase × MiniMax × 行业伙伴 - 企业级数据库实践
- 筑牢央国企数智底座!OceanBase 联合浪潮海岳推出 ERP 一体化数智融
- PowerContext 1.0.0 正式发布:前事有据 - 企业级数据库实践
