被 TKDE 接收OceanBase 最新论文让大模型合成数 - 企业级数据库实践
TKDE(IEEE Transactions on Knowledge and Data Engineering)是数据库与数据工程领域最具影响力的国际顶级期刊之一,被中国计算机学会(CCF)列为 A 类推荐期刊。
此次被接收的论文聚焦大模型合成数据中的分布对齐与多样性问题。
以数据为中心的训练离不开高质量标注数据,而大语言模型(LLM)让“批量生成带标签的训练数据”成为可能。
但现有 LLM 合成方法有两个主要问题:
-
一是分布失配:合成数据难以对齐真实世界的分布,样本稀少的类目尤其严重,LLM 不但没有缓解偏见,反而会放大偏见。
-
二是多样性不足:模型倾向于复现训练语料中的高频模式,生成的文本千篇一律,限制了下游模型的泛化能力。
针对这两个问题,DADO 设计了一条协同生成流水线:
双智能体框架(属性生成 + 属性打分)自动完成分布对齐,全程不需要人工特征工程;
多层提示词系统配合排除机制和多样性优选的 few-shot 示例,让生成文本在词汇和结构上有充分变化。
整个框架完全基于提示词实现,不需要训练或微调任何模型。
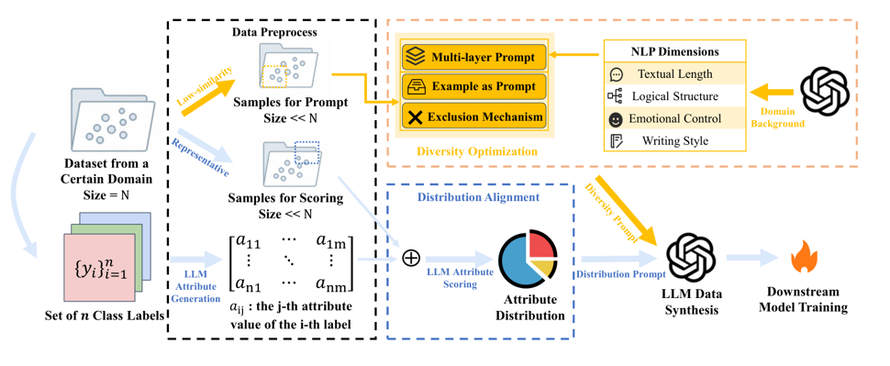
图 1. DADO 框架总览:下半部分为分布对齐(Distribution Alignment),上半部分为多样性优化(Diversity Optimization)
核心技术一:双智能体框架,自动实现分布对齐
传统属性类方法(如 AttrPrompt)要人工为每个领域指定属性集合(如“质量”“价格”),费时费力,属性集也偏通用,刻画不了目标领域的真实分布;黑盒提示则同样会放大 LLM 高频偏见。
DADO 的核心思想:让 LLM 自己“读懂”真实数据,自动发现领域属性,并量化每个属性的重要程度。
设计核心:AgentGen + AgentScore 双智能体流水线
AgentGen(属性生成智能体):把成批的真实样本连同一套专用指令喂给 LLM,找出数据中反复出现的潜在维度,评估它们在不同类别间的区分能力,并过滤掉长度、词数这类没有信息量的通用属性。不同领域会得到不同的属性体系:Amazon 数据集得到的是产品规格、交易要素、服务质量这类产品侧属性;Reddit 数据集中 80% 的属性与社区互动和经验分享相关。
AgentScore(属性打分智能体):先用 SentenceTransformer 把文本映射成语义嵌入,再用聚类,从每个簇中挑出最有代表性的样本;然后让 LLM 对“样本 × 属性”逐对做 0/1 二元判断,统计后得到每个属性的重要性分数,形成加权属性分布,用来指导后续生成。
这个设计还有三个实际的优点:0/1 判断把“不确定”直接记为 0,保证打分的精确率;新领域、新属性即插即用;打分每次只输出 1 个 token,API 开销很低。
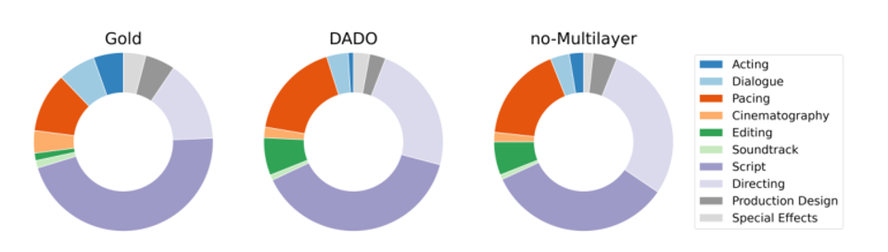
图 2. 属性分布对比:DADO(中)与真实数据 Gold(左)的属性分布基本一致,去掉多层提示词后(右)则出现偏移
核心技术二:多层提示词 + 排除机制 +多样性优选示例
分布对齐管住了语义内容,管不住语言表达。LLM 倾向于输出训练语料中的高频模式,生成统计上典型、词汇和风格却很单调的文本。
DADO 的核心思想:把人类语言的多样性拆成四个可控维度,在提示词里逐一显式控制。
设计核心:Multi-layer Prompt + Exclusion Mechanism + Diversity-optimized Few-shot Selection
多层提示词:文本长度层按真实数据的长度分布分配字数区间;逻辑结构层提供“问题-方案”“前后对比”等修辞框架;情感控制层细化出“失望”“后悔”这样的具体情绪档位,而不是笼统的正面/负面;写作风格层调节技术、叙事等语域和人称视角。
排除机制:词汇级黑名单压制过用词(“不要直接使用以下词语……”),句式层面禁止“I recently purchased”这类模板化开头,逼着模型去用更广的词汇和结构。
多样性优选示例:把候选样本嵌入后计算余弦相似度矩阵,贪心迭代,每一轮都选出与已选样本平均相似度最低的那个,用冗余最少的 few-shot 示例覆盖数据集的内在结构。
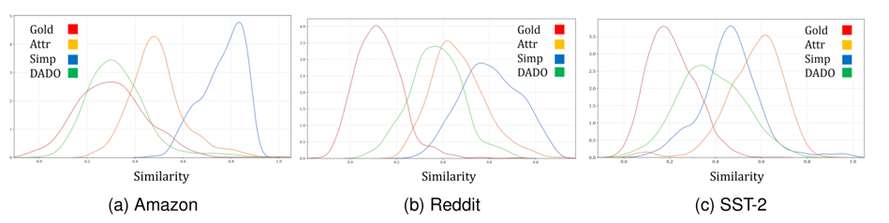
图 3. 类内文本对相似度分布:DADO(绿)最贴近真实数据(红),SimPrompt(蓝)明显向高相似度聚集,生成内容高度重复
核心技术三:分布与多样性的系统性整合
以往的工作通常只解决其中一个问题:SynAlign 专注分布对齐,不优化多样性;CorrSynth 靠采样提升多样性,但不保证分布合理。而且这两个目标看起来相互牵制。
DADO 的核心思想:在统一的多阶段生成流水线里,用概率化配置把两个目标一起做进每条提示词。
设计核心:多层提示词动态模板
每条生成提示词都由多层模板动态拼装,属性焦点按打分分布的概率出现,字数区间按真实长度分布采样,风格、逻辑、情感三层随机组合,排除黑名单动态更新,示例按低相似度策略选取。
消融实验证实两个机制各司其职:去掉分布对齐,Amazon 上分布欧氏距离恶化 87.2%;去掉多样性优化,分布指标几乎不动,反过来也一样。
实验结果
-
多样性:Amazon 上整体词汇量 13.3k,是 SimPrompt(8.7k)的 1.5 倍,最接近真实数据的 17.4k;Self-BLEU-4 从基线的 0.485 降到 0.183,几乎追平真实数据的 0.175。
-
分布对齐:Amazon 上分布欧氏距离从基线的 16.6~21.7 降到 9.0(降低 45%),余弦相似度 0.972;Reddit 上 JS 散度和卡方统计量都是所有方法里最低的。
-
下游训练:合成数据用于增强后,BERT 平均交叉熵(CE)损失从 0.768 降到 0.580(降低 24.5%),平均准确率从 0.805 升到 0.844;在类别很不平衡的 Reddit(45 类)上,CE 损失降低 35.3%(BERT)和 39.8%(DistilBERT)。
-
人工评估:三名 NLP 专家从流畅性、相关性、多样性三个维度打分,DADO 的流畅性和相关性接近真人写作(4.6~4.7,金标 4.7~4.8),多样性得分 3.8~4.0,明显高于基线(SimPrompt 只有 2.3~2.4)。
-
模型无关:在 GPT-3.5-turbo、GPT-4、DeepSeek 三种底座模型上都有效。
总结
DADO 围绕“分布对齐”与“多样性优化”两个目标,形成了一套完整的 LLM 合成数据框架:
-
双智能体自动挖掘并量化领域属性,让合成数据贴合真实分布;
-
多层提示词、排除机制和多样性优选示例负责表达层的丰富度,让文本告别模板化;
-
最后由概率化的提示词组装把两者协同起来。
论文也证明了,分布对齐和多样性优化可以同时达成,不必牺牲其一。

立即试用 OceanBase 企业版,体验国产数据库能力 180 天免费试用,零门槛开通
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/69909943/viewspace-3184737/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- 基于 3 类具身智能场景,多模态数据底座统一架构实践
- GPT-6 发布“Better prompt cache” - 企业级数据库实践
- 联通广东产互 × OceanBase AI 存储底座实践 - 企业级数据库实践
- 被 VLDB 2027 接收OceanBase 最新论文让数据库基 - 企业级数据库实践
- 交易时延降 10% 以上 - 企业级数据库实践
- 亮相中国通信展主论坛 OceanBase 发布通信 AI 一 - 企业级数据库实践
- 跑出 AI 新能力OceanBase 刷新国际 Data Agent - 企业级数据库实践
- OceanBase × MiniMax × 行业伙伴 - 企业级数据库实践
- 筑牢央国企数智底座!OceanBase 联合浪潮海岳推出 ERP 一体化数智融
- PowerContext 1.0.0 正式发布:前事有据 - 企业级数据库实践
