胖头鱼的技术专栏-484 MySQL 一个数据库大版本,凭什么要熬七年?(20261029)
作者:胖头鱼的鱼缸(尹海文)
Oracle ACE Pro: Database
PostgreSQL ACE
10年+数据库行业经验
拥有OCM 11g/12c/19c、MySQL 8.0 OCP、Exadata、CDP等认证
墨天轮MVP,ITPUB认证专家
圈内拥有“总监”称号,非著 名社恐(社交恐怖分子)
全网同名:胖头鱼的鱼缸
ITPUB:yhw1809
除授权转载并标明出处外,均为“非法”抄袭
9 月 28 日,我在武汉。
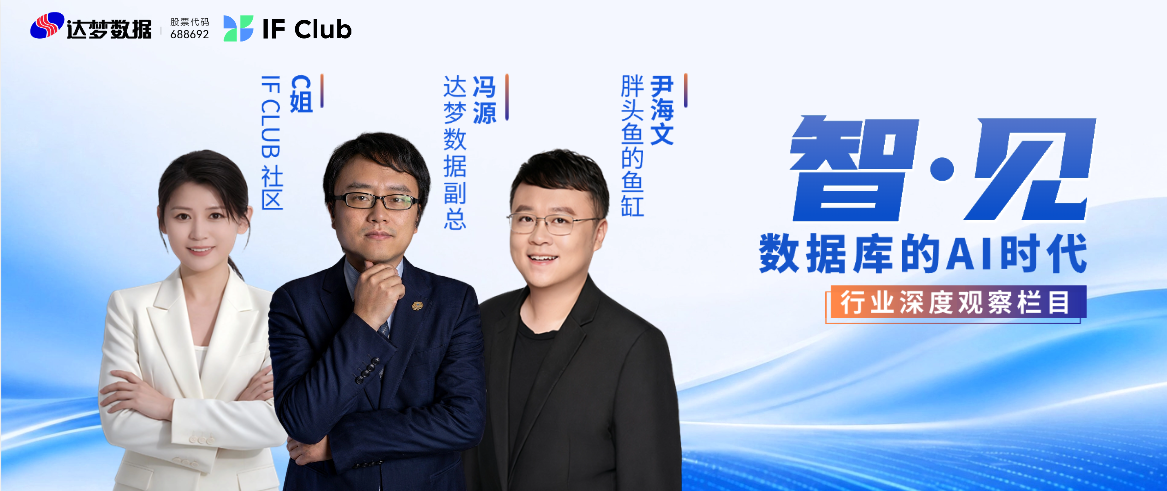
去的地方是达梦中国数据库产业基地——光谷那片 8 万平米的楼,国内第一个以"数据库"命名的产业基地。这次是去录一档新节目,跟达梦数据副总经理冯源聊了一场。节目还在后期,后续会发在达梦运营的视频平台账号上,想看的朋友可以期待一下。
节目录完,会议室里又聊了一阵。聊着聊着就到了一个话题,也是不少客户当面提过的:
DM8 这两年进步挺明显,这是实话。但 DM8 是 2019 年发布的,中间这段路走了挺久,感觉一直在打磨;好不容易 DM9 出来了, 公开资料又少得可怜。
这个问题我替不少同行问了一遍。冯源给了 三个回答,我觉得值得记下来。
七年前的那个 DM8
先把时间线摆清楚。
DM8 发布于 2019 年 5 月 8 日,在北京,那年中国数据库技术大会的场子上。达梦当时的说法是四个全新架构、359 项细节改进。
DM9 发布于 2026 年 4 月 22 日,450+ 项新特性,集中式分布式一体化,第 9 代旗舰。
两个日期一减, 七年。
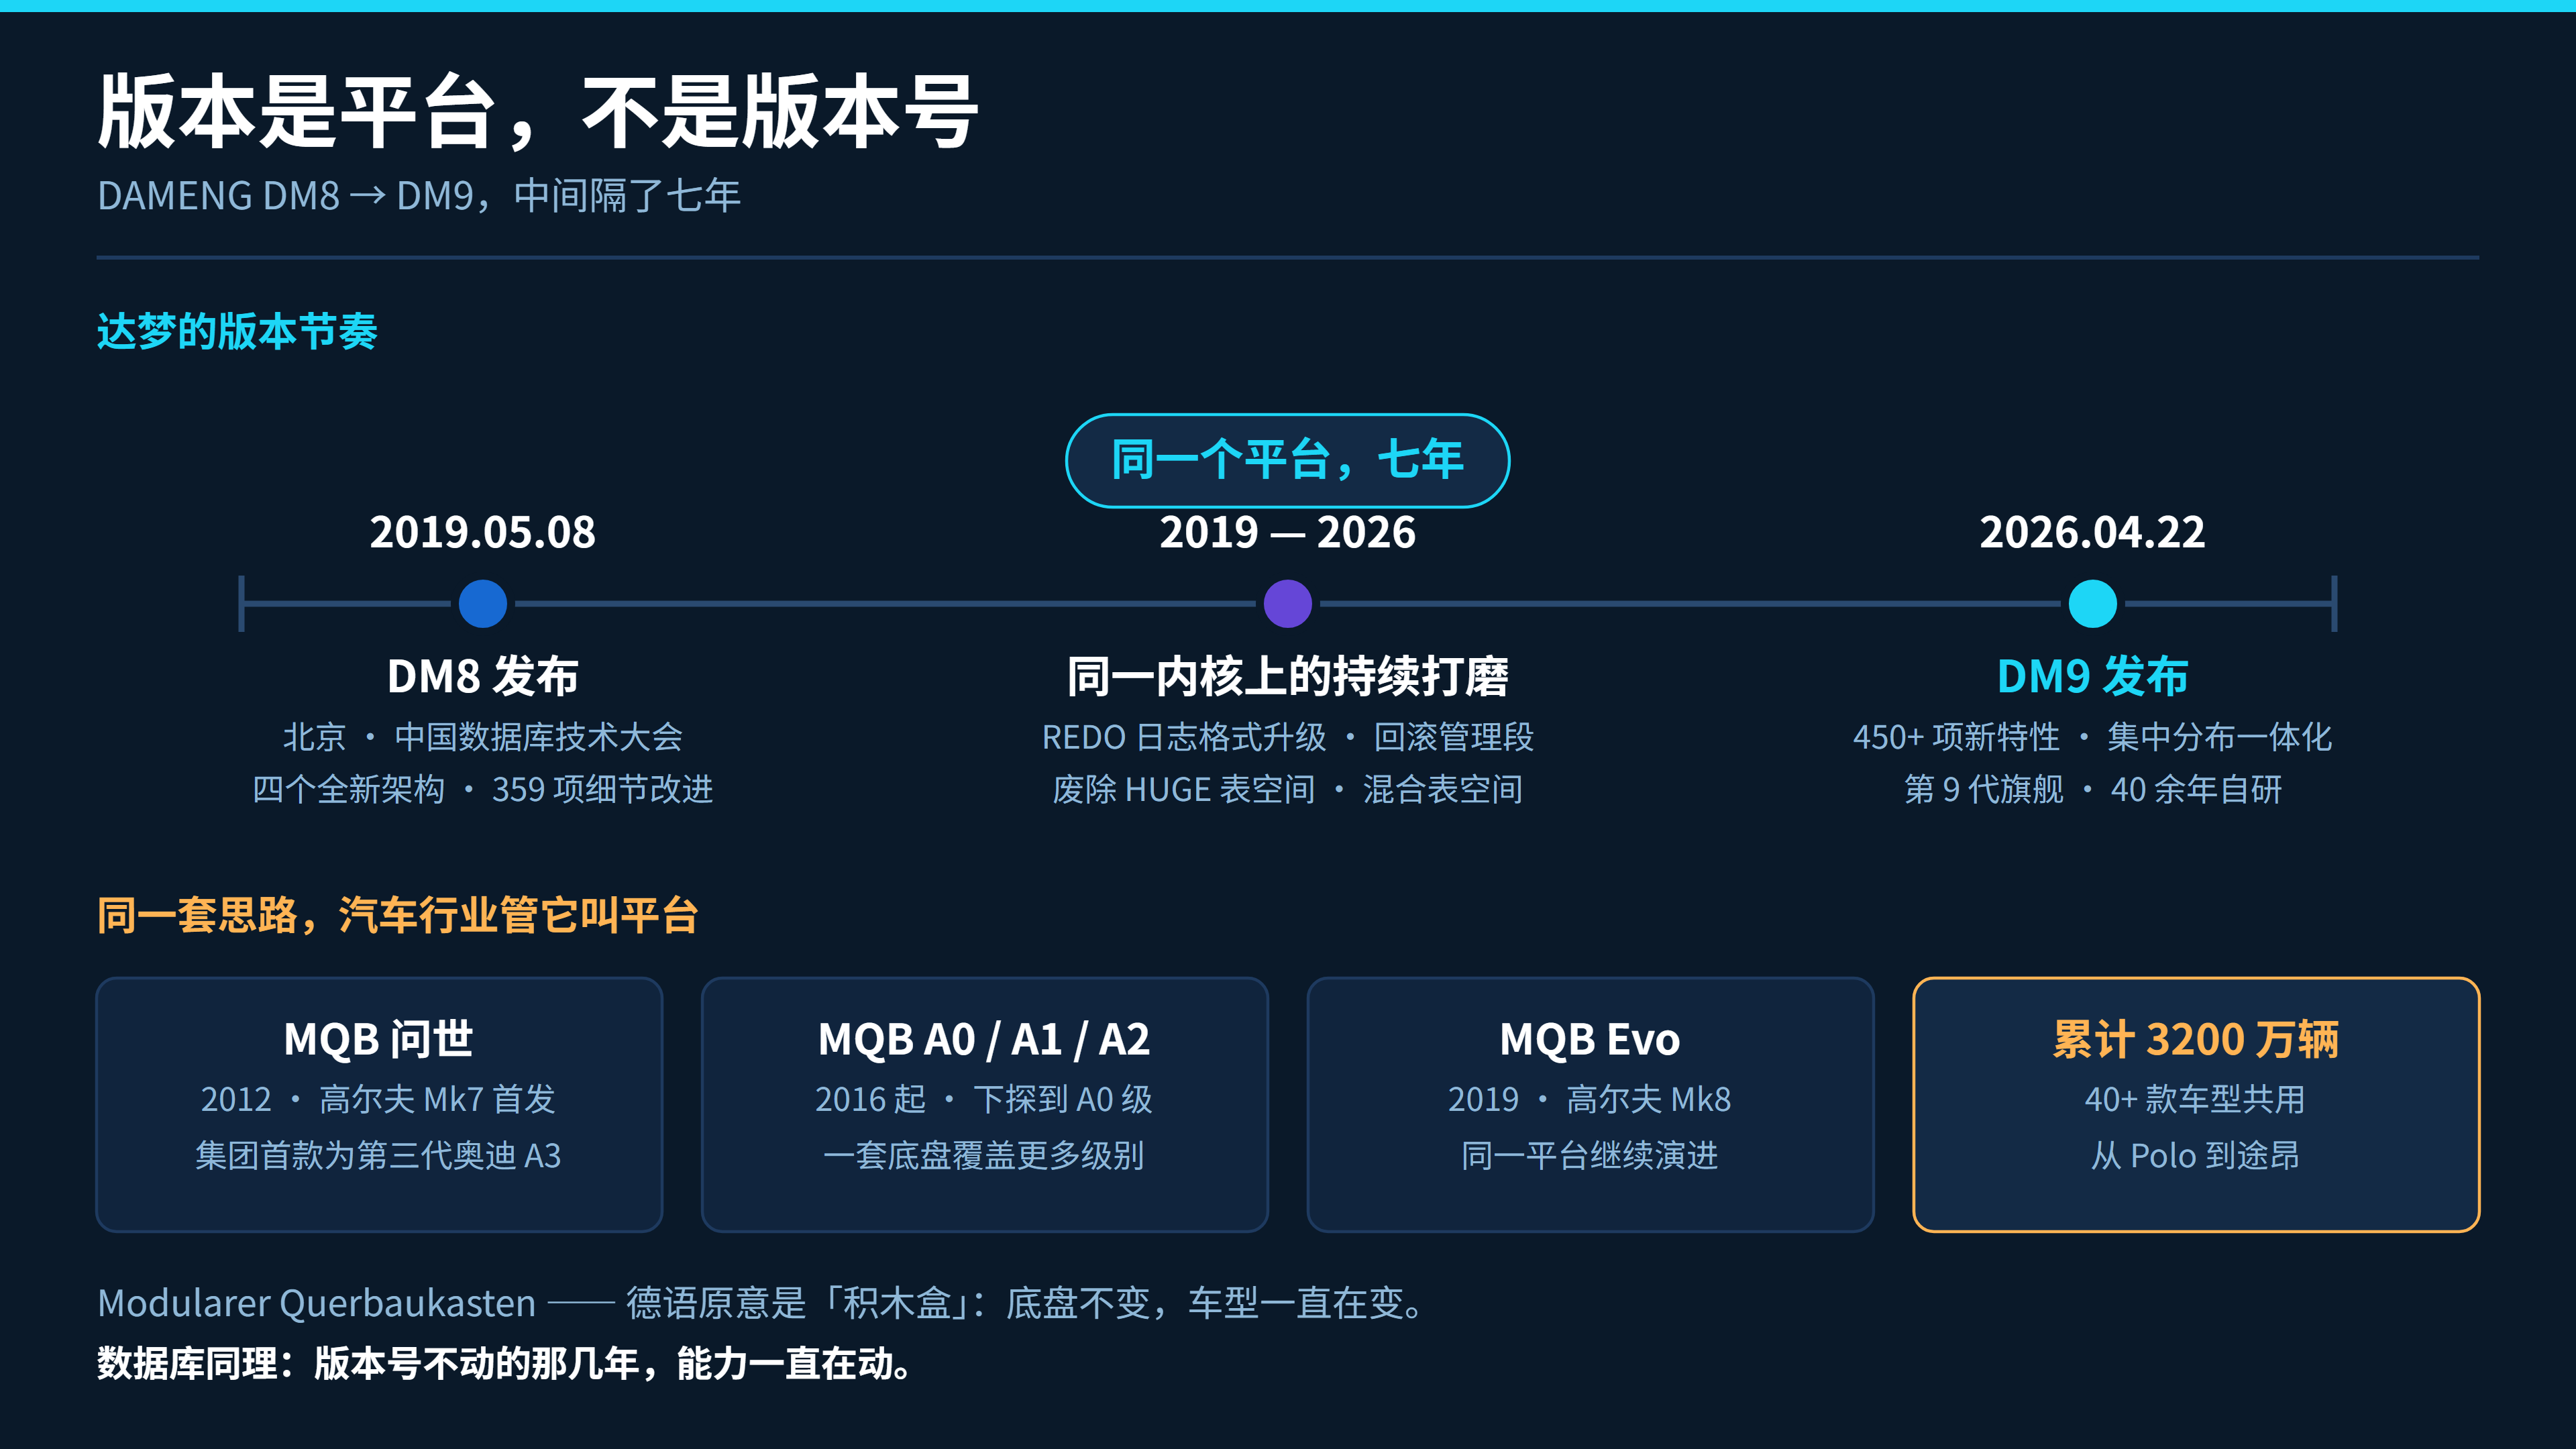
这七年 DM8 没闲着。REDO 日志格式升级、引入回滚管理段、废除 HUGE 表空间改成混合表空间、数据字典字段编码优化……各位应该能看出来, 这些全是老 DBA 才会关心的东西。
它们一个都上不了发布会的 PPT 标题。但它们决定了另一件更要紧的事—— 老版本升得上来吗。
车企的积木盒
冯源的第一个回答是类比。
他说对达梦来说,每个大版本都会经历比较长的时间, 每个版本更像一个平台、一条基线。就像车企发布一个平台,然后在这个平台上不断迭代出不断完善的产品。
MQB 是 2012 年秋季问世的,首 款车型是第七代高尔夫——不过集团里第一台 MQB 车其实是第三代奥迪 A3,比高尔夫早几个月下线。这套底盘从 Polo 一路撑到途昂;2016 年往下压出 MQB A0,把 A0 级小车也收了进来;2019 年高尔夫 Mk8 换成 MQB Evo,同一套平台接着演进。到十周年的时候,基于 MQB 生产的车累计 3200 万辆, 40 多款车型共用一套底盘。
众所周知,MQB 全称 Modularer Querbaukasten。 Baukasten 在德语里就是"积木盒"。
冯源说的"平台",跟这个词其实是一回事—— 底盘那一套东西不动,车型一直在变。
说白了,没有哪家车厂会因为要出一款新车就把平台推倒重来。推倒重来意味着底盘重新验证、碰撞重新做、产线重新调。数据库更不可能,数据库上面压着的是人家的核心账本。
先让老版本升得上来
第二个回答更实在:每个版本前期,头等的任务除了全新功能, 更重要的是跟上一个版本的兼容性,要能平滑过渡升级。
这句话单看没感觉,放到客户现场就有感觉了。
我见过客户算这笔账。一套系统从老版本升上来, 真正花时间的不是装库——装库就半天。花时间的是回归测试、是跑批时长对比、是停机窗口一轮一轮地沟通,还有一堆"这条 SQL 在老版本好好的、到新版本怎么变了"的排查。
所以数据库厂商排版本优先级的时候, 兼容性永远排在炫技前面。国产库这些年的进步,很大一部分也体现在这儿:不是新特性数量堆得多,是老代码搬过来能跑。
DM9 现在在哪一步
三个回答里,我最想把第三个记下来,因为它直接解释了" DM9 资料为什么这么少"。
已经落地的: 关系、JSON、全文、向量、GIS 等多模数据的存储与混合检索,而且部分客户已经有实践落地。
这件事的分量,搭过 RAG 的人最清楚。眼下常见的搭法是"关系库 + 向量库 + 搜索引擎"三套并排,各自存一份数据、各自一套运维,中间靠同步链路接起来。麻烦就在那个窗口期——关系表里的数据更新了,向量索引还没跟上, 查出来的结果就对不上。
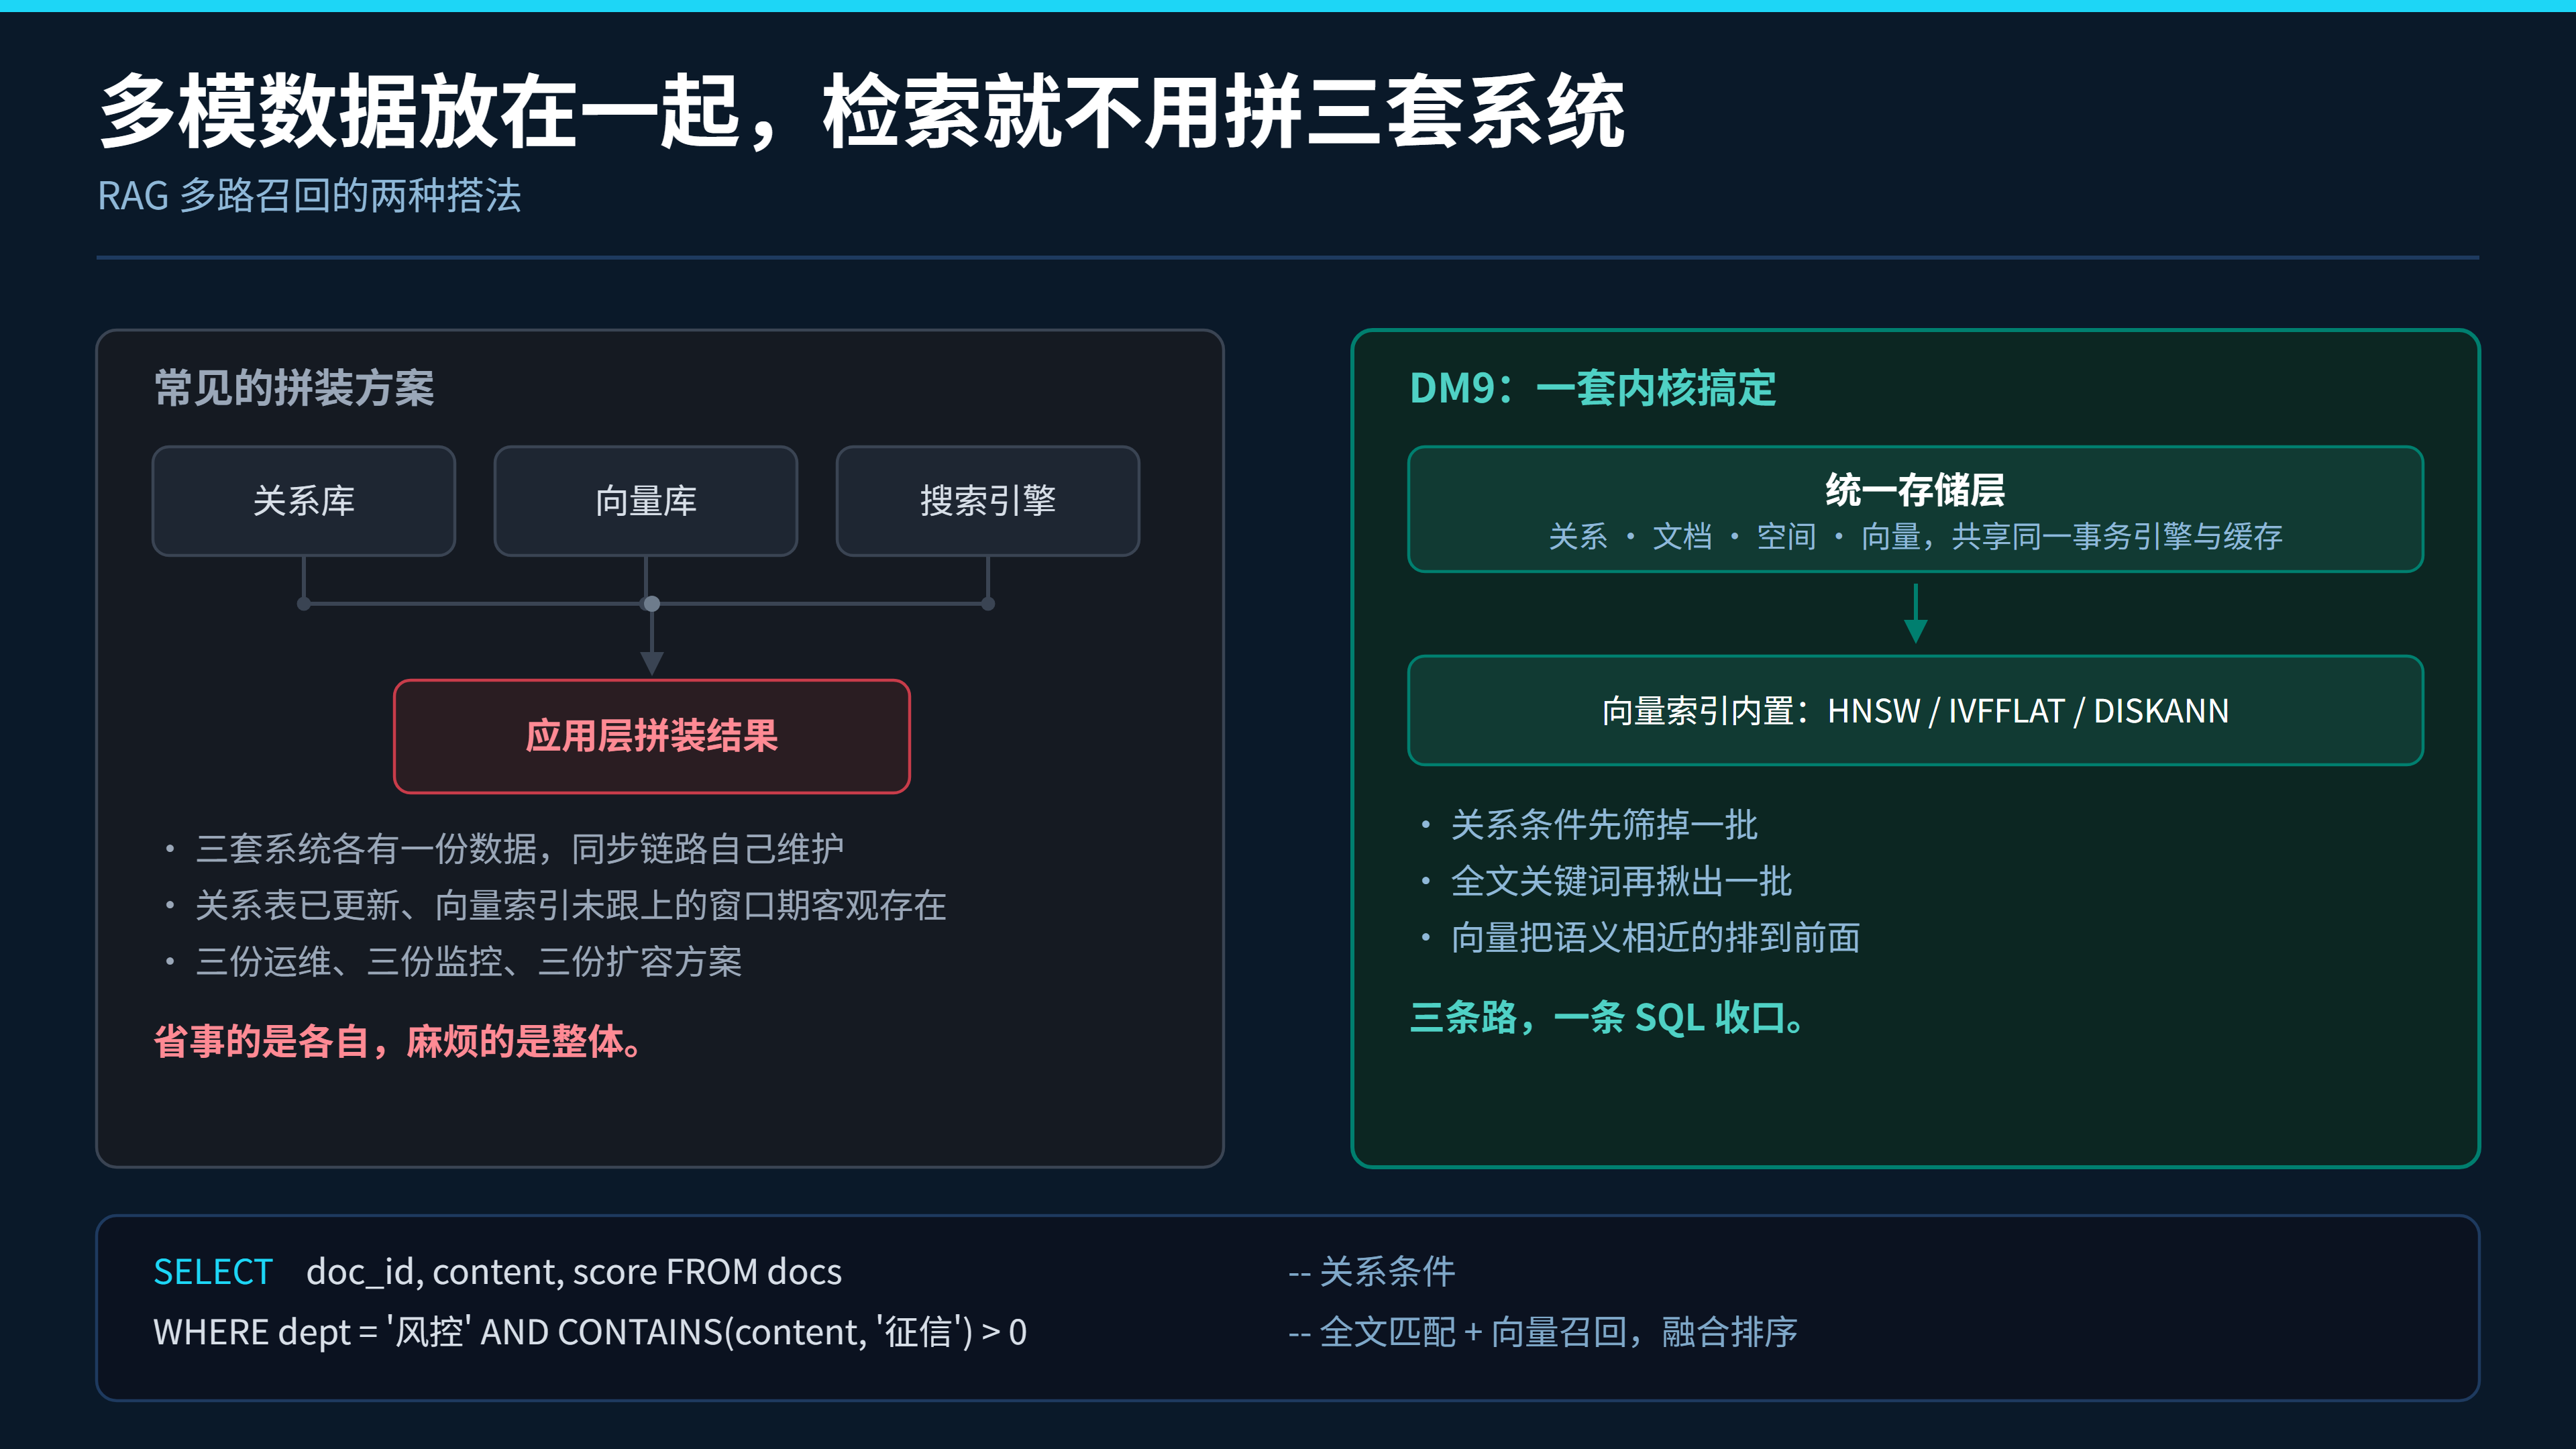
DM9 的做法是把多模数据放进同一套事务引擎、同一套缓存、同一套存储层,向量索引内置 HNSW、IVFFLAT、DISKANN,一条 SQL 就能跨模型查询。 数据不搬家,也就没有同步窗口这一说。
还在开发中的: 语义算子、库内 Agent 这些 AI 能力。
还在研判中的: AI 时代不断出现的对数据库的新要求——怎么做、做不做,都还没定。
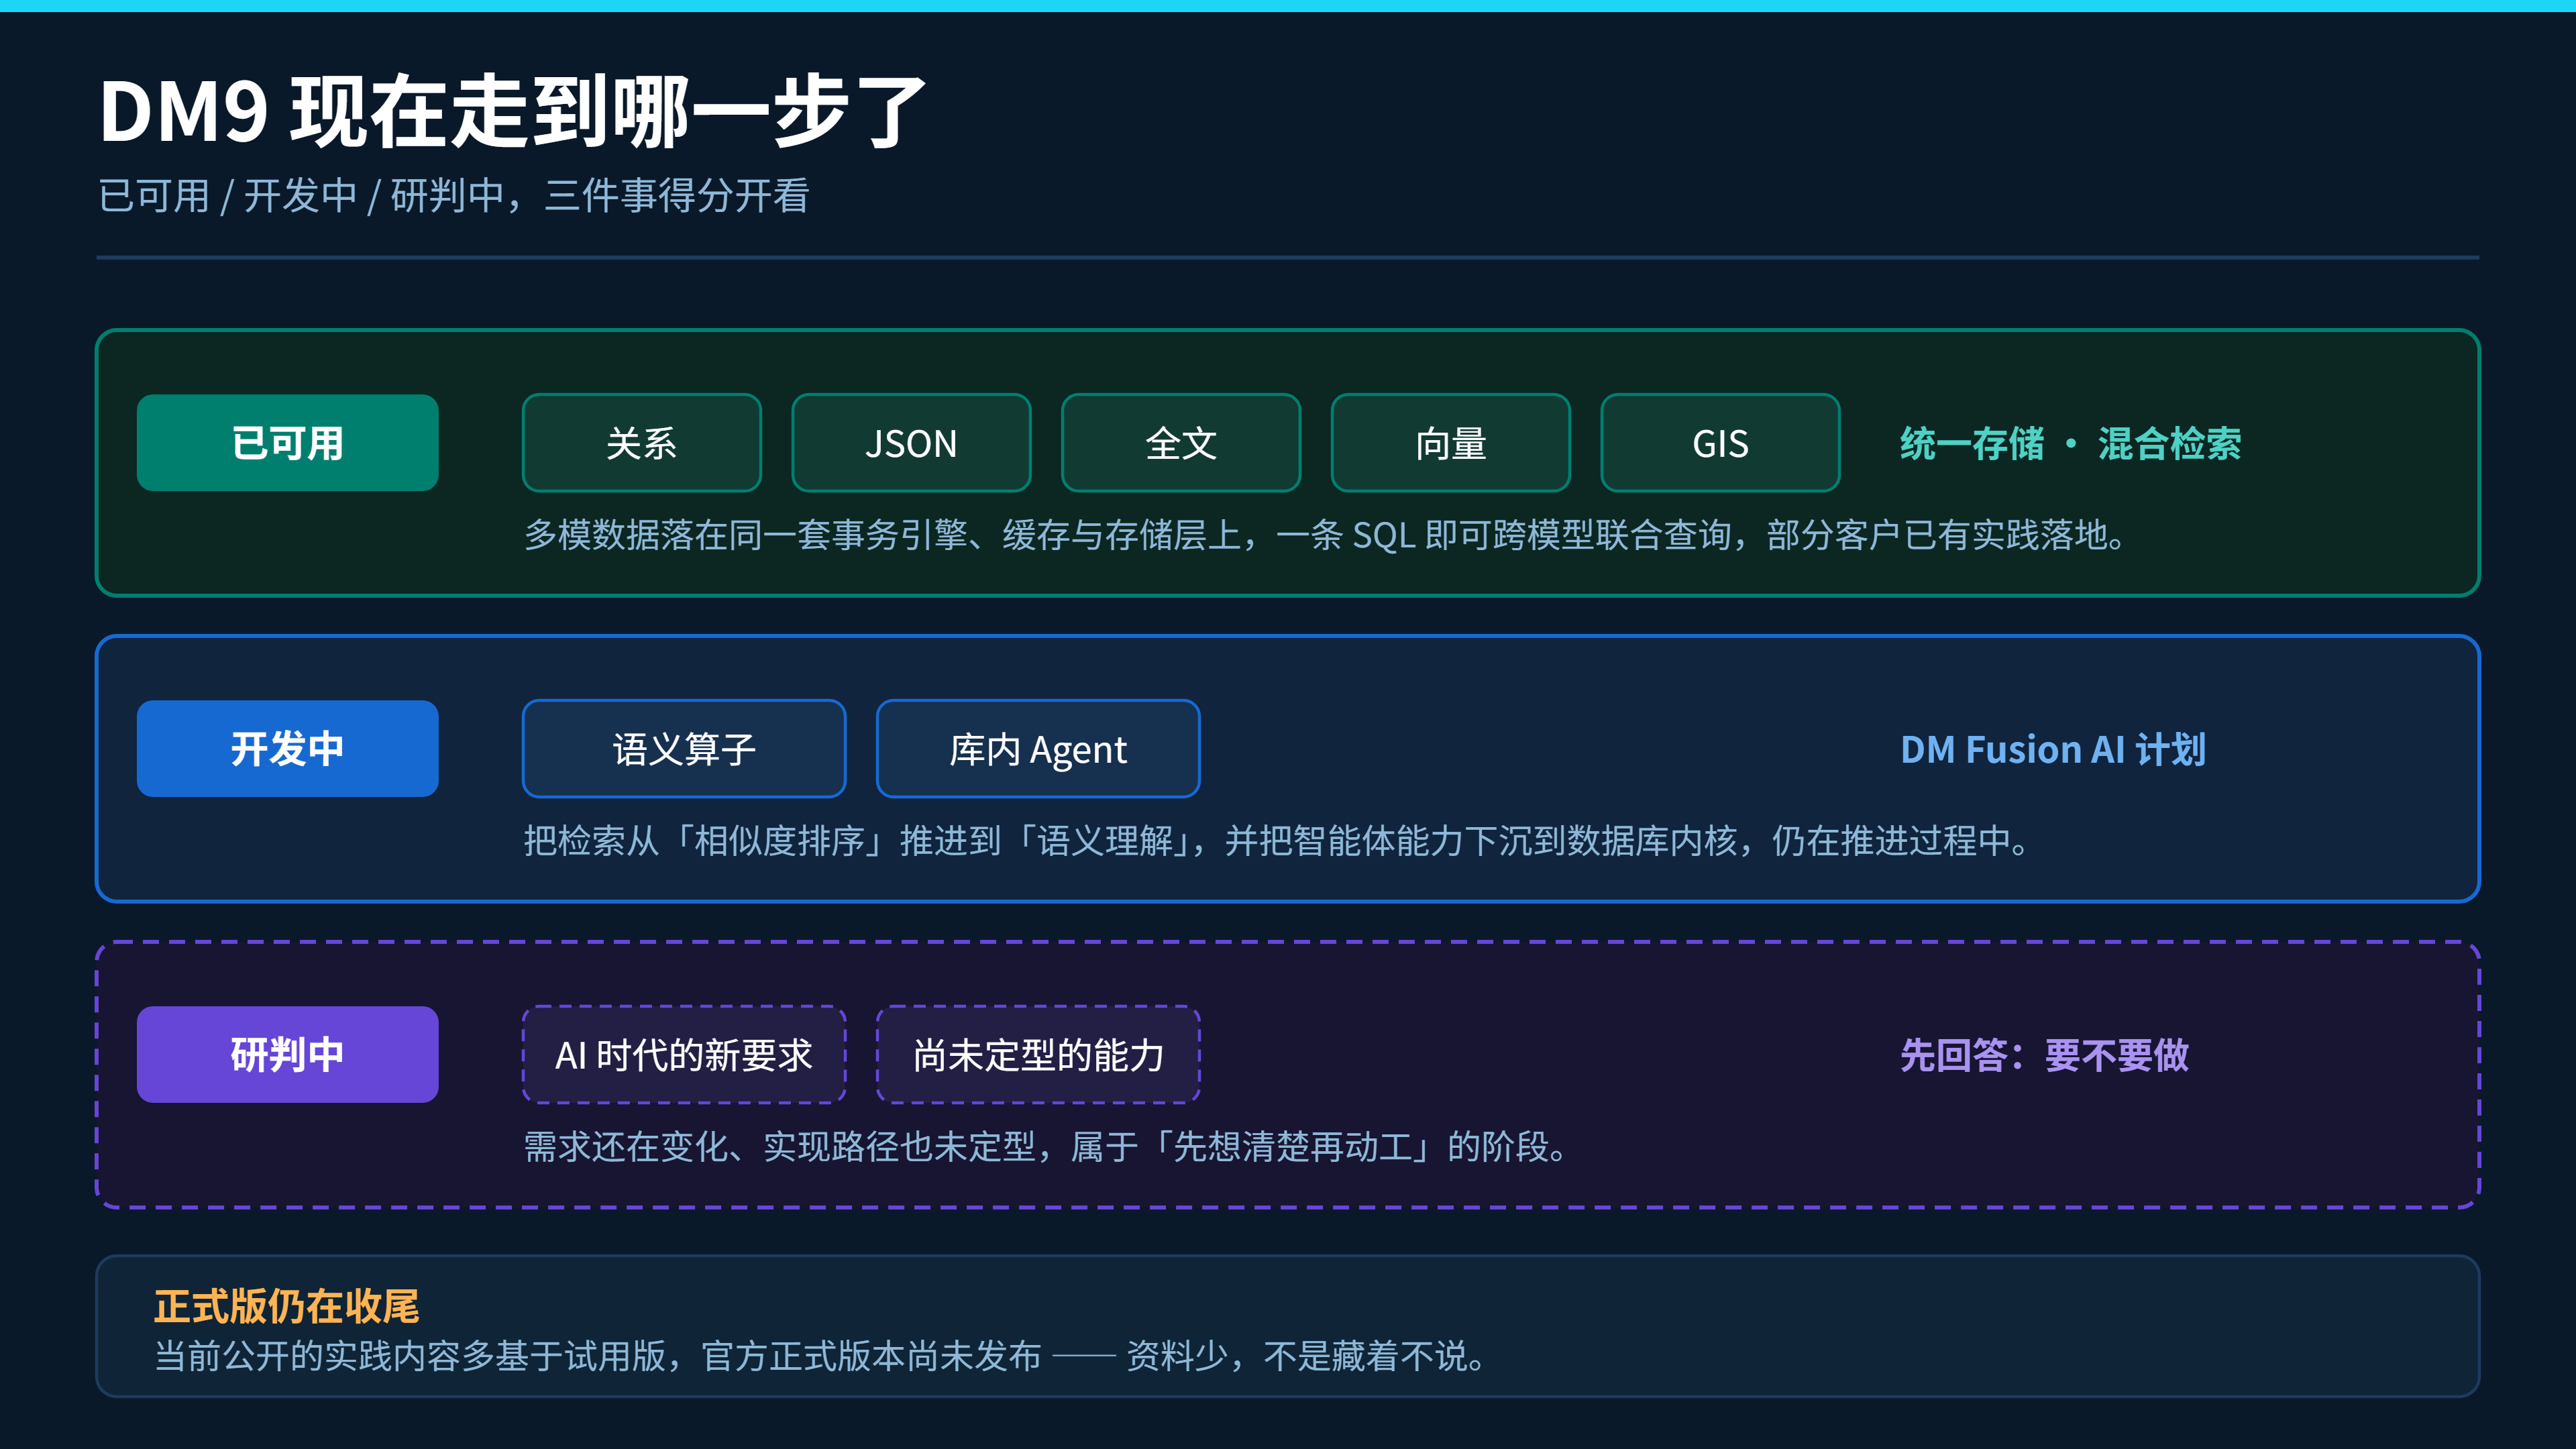
回到开头那个疑问——DM9 的资料为什么这么少,答案就在这三段里。 眼下能拿到的 DM9 基本都是试用版:8 月 20 日启动的"达梦同行者"征文大赛,9 月 24 日截稿、10 月 16 日出结果,参赛的朋友装的、测的都是它。而官方正式版还在收尾,公开材料跟不上趟,也就不奇怪了。
顺带一提,从征文活动投稿中看到一些实测,写得挺细——中文分词得先确认字符集是 UTF-8、CONTEXT 索引建完不会自动吃存量数据、得手动 REBUILD 一次,这类坑都写出来了。这些实操演示比发布会 PPT 显得更加直观。
总结
写到这里,说三层我的看法。
第一,数据库这个品类的节奏,快不一定是好事。七年一个大版本,放在互联网产品的语境里确实慢;放在"客户要把核心账本放进来"的语境里, 慢是必要的成本。近几代的 DM7、DM8、DM9 都是这个节奏,一次都没变过,说明它对自己的判断是稳定的。
第二,AI 能力进内核,会把这个节奏进一步拉长。向量检索、语义理解、库内推理这些东西的成熟曲线,跟传统数据库能力不是一回事—— SQL 语法支持容易,做到生产可用不容易。快不起来,硬上更不行。
第三,也是最容易被忽略的一点:AI 时代对数据库的新要求会一个接一个冒出来,但每一项要不要进内核,都不只是技术问题。DBA 当然希望库里什么都有,用着省事;可内核每多一样东西,长期维护成本和潜在风险也跟着涨。 对新要求先研判、而不是照单全收,我倒觉得是负责任的表现。
一个版本熬七年,听起来慢。但真正需要回答的问题只有一个: 七年之后,客户敢不敢把核心系统放在上面。
老规矩,知道写了些啥。
最后,关于我去武汉做了些什么,先卖个关子,敬请期待:
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/31466763/viewspace-3186922/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- 胖头鱼的技术专栏-483 索引里也掺了水分(20261028)
- 胖头鱼的技术专栏-482 Oracle AI DB 23.26.4新特性一览(20261027)
- 胖头鱼的技术专栏-481 MySQL 替代怎么选?聊聊 OceanBase 集中式的五个优势
- 胖头鱼的技术专栏-480 交付和运维不是低价值岗位,离客户最近的人才懂业务
- 胖头鱼的技术专栏-479 如何高效地将喂给 AI 的数据搬过去(20261015)
- 胖头鱼的技术专栏-478 Agent 成了新用户,数据库要接住它的下一步(20261014)
- 胖头鱼的技术专栏-477 26ai新特性实战:表达式分区(20261013)
- 胖头鱼的技术专栏-476 26ai新特性实战:聚合过滤(20261012)
- 胖头鱼的技术专栏-475 蹭到最后,就没人摆摊了(20261010)
- 胖头鱼的技术专栏-474 从能跑到能上线:PG SplitJSON 0.2.0 和 0.1.0 差在哪
