Oracle的执行计划,在哪里能找到执行?
对于经常和数据库打交道的朋友,优化sql时,最常见的就是执行计划,那么,什么是执行计划呢?市面上有非常多资料可以帮助理解执行计划,各类资料的实际参考效果参差不齐。
我个人认为讲解质量最高的资料来自《Troubleshooting Oracle Performance》(ISBN:1590599179)。
也可以参考 Oracle 11g 的官方文档也是最权威的,但是缺少一些实战的经验,也具备一定参考价值。
查看执行计划的手段同样多种多样,在较新版本的 Oracle中,甚至可以直接查询相关动态性能视图V$SQL_PLAN。
本文将演示几种生成执行计划的方式,同时介绍在获取 “真实准确的执行计划” 过程中可能会遇到的各类问题。
本篇博客会使用如下脚本创建测试表:
CREATE TABLE T1 (
  C1 NUMBER,
  C2 VARCHAR2(255),
  PRIMARY KEY (C1));
CREATE TABLE T2 (
  C1 NUMBER,
  C2 VARCHAR2(255),
  PRIMARY KEY (C1));
CREATE TABLE T3 (
  C1 NUMBER,
  C2 VARCHAR2(255));
CREATE TABLE T4 (
  C1 NUMBER,
  C2 VARCHAR2(255));
INSERT INTO
  T1
SELECT
  ROWNUM,
  RPAD(TO_CHAR(ROWNUM),255,'A')
FROM
  DUAL
CONNECT BY
  LEVEL<=1000000;
INSERT INTO
  T2
SELECT
  ROWNUM,
  RPAD(TO_CHAR(ROWNUM),255,'A')
FROM
  DUAL
CONNECT BY
  LEVEL<=1000000;
INSERT INTO
  T3
SELECT
  ROWNUM,
  RPAD(TO_CHAR(ROWNUM),255,'A')
FROM
  DUAL
CONNECT BY
  LEVEL<=1000000;
INSERT INTO
  T4
SELECT
  ROWNUM,
  RPAD(TO_CHAR(ROWNUM),255,'A')
FROM
  DUAL
CONNECT BY
  LEVEL<=1000000;
COMMIT;
EXEC DBMS_STATS.GATHER_TABLE_STATS(OWNNAME=>USER,TABNAME=>'T1',CASCADE=>TRUE)
EXEC DBMS_STATS.GATHER_TABLE_STATS(OWNNAME=>USER,TABNAME=>'T3',CASCADE=>TRUE)
面这段脚本会创建四张表,每张表包含 100 万行数据。前两张表由于定义了主键列,主键列上会自动生成索引。
除此之外,脚本会收集第一张和第三张表的统计信息,但不会收集第二张和第四张表的统计信息(用来配合后面几个演示场景)。
如果你使用的是 Oracle 10.1.0.1 或更高版本,可以通过 `DBMS_XPLAN.DISPLAY_CURSOR` 函数查看执行计划。
从 Oracle 10.1.0.1 版本开始,当在 SQL*Plus 中开启 AUTOTRACE 时,会自动调用这个函数。`DBMS_XPLAN.DISPLAY_CURSOR` 是查看执行计划的首选方式,
我们就从这个方法开始。
首先,我们在优化器模式(OPTIMIZER_MODE)设置为 ALL_ROWS 的情况下,生成一条 SQL 的执行计划:
SET LINESIZE 150
ALTER SESSION SET OPTIMIZER_MODE='ALL_ROWS';
SELECT
  T3.C1,
  SUBSTR(T1.C2,1,10) C2
FROM
  T3,
  T1
WHERE
  T1.C1=T3.C1
  AND T1.C1 BETWEEN 1 AND 10;
 C1 C2
--- ----------
  1 1AAAAAAAAA
  2 2AAAAAAAAA
  3 3AAAAAAAAA
  4 4AAAAAAAAA
  5 5AAAAAAAAA
  6 6AAAAAAAAA
  7 7AAAAAAAAA
  8 8AAAAAAAAA
  9 9AAAAAAAAA
 10 10AAAAAAAA
查看刚执行完的 SQL 语句执行计划的常用方式如下
(注意:第三个参数,也就是 FORMAT 参数,也可以设为 NULL,效果完全一样):
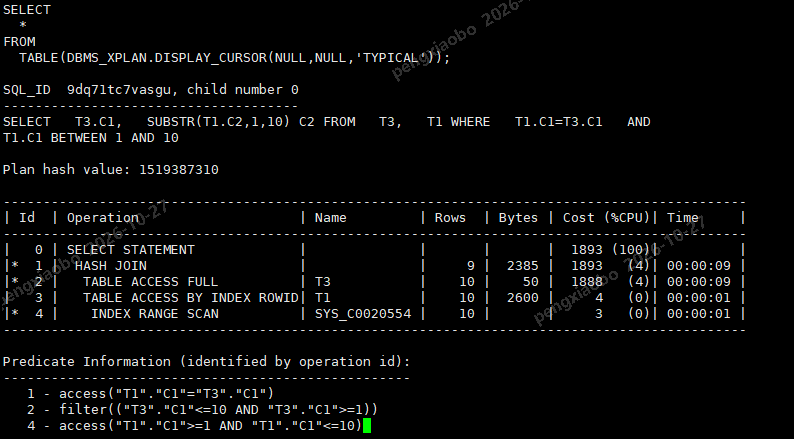
在上面的输出中,可以留意到该执行计划的计算代价为 1893。
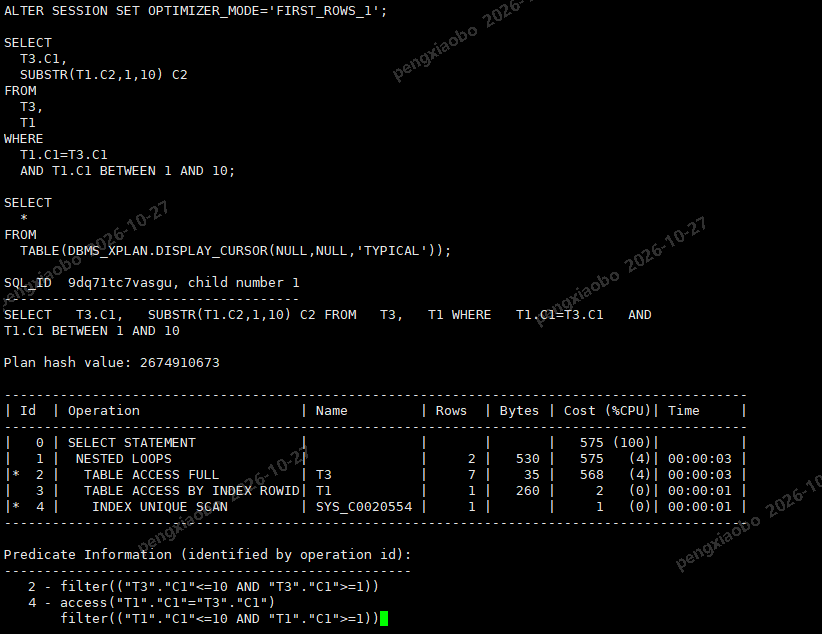
我们再做一组测试,将优化器模式设置为 FIRST_ROWS(在该模式下,Oracle 假定只会取回第一行数据,剩余行大概率不会被读取):
ALTER SESSION SET OPTIMIZER_MODE='FIRST_ROWS_1';
SELECT
T3.C1,
SUBSTR(T1.C2,1,10) C2
FROM
T3,
T1
WHERE
T1.C1=T3.C1
AND T1.C1 BETWEEN 1 AND 10;
SELECT
*
FROM
TABLE(DBMS_XPLAN.DISPLAY_CURSOR(NULL,NULL,'TYPICAL'));
SQL_ID 9dq71tc7vasgu, child number 1
-------------------------------------
SELECT T3.C1, SUBSTR(T1.C2,1,10) C2 FROM T3, T1 WHERE T1.C1=T3.C1 AND
T1.C1 BETWEEN 1 AND 10
Plan hash value: 2674910673
---------------------------------------------------------------------------------------------
| Id | Operation | Name | Rows | Bytes | Cost (%CPU)| Time |
---------------------------------------------------------------------------------------------
| 0 | SELECT STATEMENT | | | | 575 (100)| |
| 1 | NESTED LOOPS | | 2 | 530 | 575 (4)| 00:00:03 |
|* 2 | TABLE ACCESS FULL | T3 | 7 | 35 | 568 (4)| 00:00:03 |
| 3 | TABLE ACCESS BY INDEX ROWID| T1 | 1 | 260 | 2 (0)| 00:00:01 |
|* 4 | INDEX UNIQUE SCAN | SYS_C0020554 | 1 | | 1 (0)| 00:00:01 |
---------------------------------------------------------------------------------------------
Predicate Information (identified by operation id):
---------------------------------------------------
2 - filter(("T3"."C1"<=10 AND "T3"."C1">=1))
4 - access("T1"."C1"="T3"."C1")
filter(("T1"."C1"<=10 AND "T1"."C1">=1))
从上面的结果可以看到,把优化器模式从 `ALL_ROWS` 改成 `FIRST_ROWS_1` 后,
生成了一份全新的执行计划(子游标编号加 1,计划哈希值也发生了变化):该计划改用嵌套循环连接,不再使用哈希连接,同时估算代价也变小了。
你可能会有疑问:既然嵌套循环这份计划的估算代价更低,为什么在 `OPTIMIZER_MODE=ALL_ROWS` 时,Oracle 没有选择它,
而是选了哈希连接?这个问题留到另一篇博客再讨论(当然,如果有人知道答案愿意分享也欢迎)。
比较奇怪的是,相比哈希连接的执行计划,这里对表 T3 返回行数的预估变少了,预估执行时间也更低。
但只看上面这些计划,我们其实无法判断真实性能好坏。
接下来我们重新做测试,修改 SQL 语句,在调用 `DBMS_XPLAN` 时传入格式参数 `'ALLSTATS LAST'`:
ALTER SESSION SET OPTIMIZER_MODE='ALL_ROWS';
SELECT /*+ GATHER_PLAN_STATISTICS */
T3.C1,
SUBSTR(T1.C2,1,10) C2
FROM
T3,
T1
WHERE
T1.C1=T3.C1
AND T1.C1 BETWEEN 1 AND 10;
SELECT
*
FROM
TABLE(DBMS_XPLAN.DISPLAY_CURSOR(NULL,NULL,'ALLSTATS LAST'));
SQL_ID ddnbt67ftu9ds, child number 0
-------------------------------------
SELECT /*+ GATHER_PLAN_STATISTICS */ T3.C1, SUBSTR(T1.C2,1,10) C2 FROM T3,
T1 WHERE T1.C1=T3.C1 AND T1.C1 BETWEEN 1 AND 10
Plan hash value: 1519387310
-------------------------------------------------------------------------------------------------------------------------------------------
| Id | Operation | Name | Starts | E-Rows | A-Rows | A-Time | Buffers | Reads | OMem | 1Mem | Used-Mem |
-------------------------------------------------------------------------------------------------------------------------------------------
|* 1 | HASH JOIN | | 1 | 9 | 10 |00:00:04.92 | 37144 | 37125 | 1452K| 1452K| 1328K (0)|
|* 2 | TABLE ACCESS FULL | T3 | 1 | 10 | 10 |00:00:00.01 | 37138 | 37125 | | | |
| 3 | TABLE ACCESS BY INDEX ROWID| T1 | 1 | 10 | 10 |00:00:00.01 | 6 | 0 | | | |
|* 4 | INDEX RANGE SCAN | SYS_C0020554 | 1 | 10 | 10 |00:00:00.01 | 4 | 0 | | | |
-------------------------------------------------------------------------------------------------------------------------------------------
Predicate Information (identified by operation id):
---------------------------------------------------
1 - access("T1"."C1"="T3"."C1")
2 - filter(("T3"."C1"<=10 AND "T3"."C1">=1))
4 - access("T1"."C1">=1 AND "T1"."C1"<=10)
这条查询耗时 4.92 秒执行完成,返回 10 行结果;在执行内存哈希连接的过程中,占用了 1328×1024 字节的内存。
有意思的是,对 T3 表的全表扫描只用了 0.01 秒,从磁盘读取了 37125 个数据块。
假设每次多块磁盘 IO 一次读取 128 个块,折算下来就是在 0.01 秒内发生 37125/128 =290.04 次多块读,平均每 1MB 的多块读只需要 0.000034 秒。
从这个执行计划看,明显是错误的,磁盘的读比固态硬盘还要快(继续往下看)
ALTER SESSION SET OPTIMIZER_MODE='FIRST_ROWS_1';
SELECT /*+ GATHER_PLAN_STATISTICS */
T3.C1,
SUBSTR(T1.C2,1,10) C2
FROM
T3,
T1
WHERE
T1.C1=T3.C1
AND T1.C1 BETWEEN 1 AND 10;
SELECT
*
FROM
TABLE(DBMS_XPLAN.DISPLAY_CURSOR(NULL,NULL,'ALLSTATS LAST'));
SQL_ID ddnbt67ftu9ds, child number 1
-------------------------------------
SELECT /*+ GATHER_PLAN_STATISTICS */ T3.C1, SUBSTR(T1.C2,1,10) C2 FROM T3,
T1 WHERE T1.C1=T3.C1 AND T1.C1 BETWEEN 1 AND 10
Plan hash value: 2674910673
----------------------------------------------------------------------------------------------------------------
| Id | Operation | Name | Starts | E-Rows | A-Rows | A-Time | Buffers | Reads |
----------------------------------------------------------------------------------------------------------------
| 1 | NESTED LOOPS | | 1 | 2 | 10 |00:00:00.02 | 37171 | 37125 |
|* 2 | TABLE ACCESS FULL | T3 | 1 | 7 | 10 |00:00:00.02 | 37139 | 37125 |
| 3 | TABLE ACCESS BY INDEX ROWID| T1 | 10 | 1 | 10 |00:00:00.01 | 32 | 0 |
|* 4 | INDEX UNIQUE SCAN | SYS_C0020554 | 10 | 1 | 10 |00:00:00.01 | 22 | 0 |
----------------------------------------------------------------------------------------------------------------
Predicate Information (identified by operation id):
---------------------------------------------------
2 - filter(("T3"."C1"<=10 AND "T3"."C1">=1))
4 - access("T1"."C1"="T3"."C1")
filter(("T1"."C1"<=10 AND "T1"."C1">=1))
如上所示,在 `FIRST_ROWS_1` 优化器模式下,这条查询仅用 0.02 秒就执行完毕。但这里存在问题:执行计划显示从磁盘读取了 37125 个数据块,
和上一份执行计划一模一样。如果只看 ID 为 1 这一步的 A-Time 列来推算,相当于每次 1MB 的物理读只需要 0.000068 秒。
要是单纯错误解读执行计划、凭此做推断就能得到这种结果。
`GATHER_PLAN_STATISTICS` 提示非常有用,它能让 `DBMS_XPLAN` 输出上一条 SQL 的真实执行统计信息。如果你不想使用这个 Hint,
也可以在会话级别把 `STATISTICS_LEVEL` 参数设置为 ALL,示例如下:
ALTER SESSION SET OPTIMIZER_MODE='ALL_ROWS';
ALTER SESSION SET STATISTICS_LEVEL='ALL';
SELECT
T3.C1,
SUBSTR(T1.C2,1,10) C2
FROM
T3,
T1
WHERE
T1.C1=T3.C1
AND T1.C1 BETWEEN 1 AND 10;
SELECT
*
FROM
TABLE(DBMS_XPLAN.DISPLAY_CURSOR(NULL,NULL,'ALLSTATS LAST'));
SQL_ID 9dq71tc7vasgu, child number 2
-------------------------------------
SELECT T3.C1, SUBSTR(T1.C2,1,10) C2 FROM T3, T1 WHERE T1.C1=T3.C1 AND T1.C1 BETWEEN 1 AND 10
Plan hash value: 1519387310
-------------------------------------------------------------------------------------------------------------------------------------------
| Id | Operation | Name | Starts | E-Rows | A-Rows | A-Time | Buffers | Reads | OMem | 1Mem | Used-Mem |
-------------------------------------------------------------------------------------------------------------------------------------------
|* 1 | HASH JOIN | | 1 | 9 | 10 |00:00:05.59 | 37144 | 37125 | 1452K| 1452K| 1324K (0)|
|* 2 | TABLE ACCESS FULL | T3 | 1 | 10 | 10 |00:00:05.59 | 37138 | 37125 | | | |
| 3 | TABLE ACCESS BY INDEX ROWID| T1 | 1 | 10 | 10 |00:00:00.01 | 6 | 0 | | | |
|* 4 | INDEX RANGE SCAN | SYS_C0020554 | 1 | 10 | 10 |00:00:00.01 | 4 | 0 | | | |
-------------------------------------------------------------------------------------------------------------------------------------------
Predicate Information (identified by operation id):
---------------------------------------------------
1 - access("T1"."C1"="T3"."C1")
2 - filter(("T3"."C1"<=10 AND "T3"."C1">=1))
4 - access("T1"."C1">=1 AND "T1"."C1"<=10)
注意,修改 `STATISTICS_LEVEL` 参数触发了这条 SQL 的又一次硬解析,子游标编号现在变成了 2。
和使用 `GATHER_PLAN_STATISTICS` Hint 的场景不同,这次我们看到的是全表扫描的真实耗时,而不再是 0.01 秒。
仔细观察还能发现,因为修改了 `STATISTICS_LEVEL` 参数,SQL 执行时间从 4.92 秒增加到了 5.59 秒。
接下来我们再次测试,将优化器模式指定为 `FIRST_ROWS_1`。
ALTER SESSION SET OPTIMIZER_MODE='FIRST_ROWS_1';
SELECT
T3.C1,
SUBSTR(T1.C2,1,10) C2
FROM
T3,
T1
WHERE
T1.C1=T3.C1
AND T1.C1 BETWEEN 1 AND 10;
SELECT
*
FROM
TABLE(DBMS_XPLAN.DISPLAY_CURSOR(NULL,NULL,'ALLSTATS LAST'));
SQL_ID 9dq71tc7vasgu, child number 3
-------------------------------------
SELECT T3.C1, SUBSTR(T1.C2,1,10) C2 FROM T3, T1 WHERE T1.C1=T3.C1 AND T1.C1 BETWEEN 1 AND 10
Plan hash value: 2674910673
----------------------------------------------------------------------------------------------------------------
| Id | Operation | Name | Starts | E-Rows | A-Rows | A-Time | Buffers | Reads |
----------------------------------------------------------------------------------------------------------------
| 1 | NESTED LOOPS | | 1 | 2 | 10 |00:00:04.79 | 37171 | 37125 |
|* 2 | TABLE ACCESS FULL | T3 | 1 | 7 | 10 |00:00:04.79 | 37139 | 37125 |
| 3 | TABLE ACCESS BY INDEX ROWID| T1 | 10 | 1 | 10 |00:00:00.01 | 32 | 0 |
|* 4 | INDEX UNIQUE SCAN | SYS_C0020554 | 10 | 1 | 10 |00:00:00.01 | 22 | 0 |
----------------------------------------------------------------------------------------------------------------
Predicate Information (identified by operation id):
---------------------------------------------------
2 - filter(("T3"."C1"<=10 AND "T3"."C1">=1))
4 - access("T1"."C1"="T3"."C1")
filter(("T1"."C1"<=10 AND "T1"."C1">=1))
再次留意到这里发生了硬解析,子游标编号加 1。这一次,查询不再是 0.02 秒完成,而是耗时 4.79 秒,绝大部分时间都消耗在全表扫描上。
还有一处比较奇怪:优化器预估只会返回 2 行,而不是 9 行或者 10 行。
我们继续测试,这一次改用绑定变量,不再使用常量字面值:
ALTER SESSION SET OPTIMIZER_MODE='ALL_ROWS';
ALTER SESSION SET STATISTICS_LEVEL='TYPICAL';
VARIABLE N1 NUMBER
VARIABLE N2 NUMBER
EXEC :N1:=1
EXEC :N2:=10
SELECT /*+ GATHER_PLAN_STATISTICS */
T3.C1,
SUBSTR(T1.C2,1,10) C2
FROM
T3,
T1
WHERE
T1.C1=T3.C1
AND T1.C1 BETWEEN :N1 AND :N2;
SELECT
*
FROM
TABLE(DBMS_XPLAN.DISPLAY_CURSOR(NULL,NULL,'ALLSTATS LAST'));
SQL_ID cvq22z77c8fww, child number 0
-------------------------------------
SELECT /*+ GATHER_PLAN_STATISTICS */ T3.C1, SUBSTR(T1.C2,1,10) C2 FROM T3,
T1 WHERE T1.C1=T3.C1 AND T1.C1 BETWEEN :N1 AND :N2
Plan hash value: 3807353021
--------------------------------------------------------------------------------------------------------------------------------------------
| Id | Operation | Name | Starts | E-Rows | A-Rows| A-Time | Buffers | Reads | OMem | 1Mem | Used-Mem |
--------------------------------------------------------------------------------------------------------------------------------------------
|* 1 | FILTER | | 1 | | 10|00:00:05.60 | 37144 | 37125 | | | |
|* 2 | HASH JOIN | | 1 | 9 | 10|00:00:05.60 | 37144 | 37125 | 1452K| 1452K| 1328K (0)|
|* 3 | TABLE ACCESS FULL | T3 | 1 | 10 | 10|00:00:00.69 | 37138 | 37125 | | | |
| 4 | TABLE ACCESS BY INDEX ROWID| T1 | 1 | 10 | 10|00:00:00.01 | 6 | 0 | | | |
|* 5 | INDEX RANGE SCAN | SYS_C0020554 | 1 | 10 | 10|00:00:00.01 | 4 | 0 | | | |
--------------------------------------------------------------------------------------------------------------------------------------------
Predicate Information (identified by operation id):
---------------------------------------------------
1 - filter(:N1<=:N2)
2 - access("T1"."C1"="T3"."C1")
3 - filter(("T3"."C1"<=:N2 AND "T3"."C1">=:N1))
5 - access("T1"."C1">=:N1 AND "T1"."C1"<=:N2)
和之前看到的执行计划完全一样;受绑定变量窥视的影响,基数预估结果也保持不变。
区别在于,现在 ID 为 1 的步骤多了一个 FILTER 过滤操作,对应的谓词条件要求绑定变量 N1 小于等于绑定变量 N2—— 这是 SQL 中 BETWEEN 语法自动生成的谓词。
接下来我们把第二个绑定变量的值改成一个大得多的值:
EXEC :N2:=500000
SELECT /*+ GATHER_PLAN_STATISTICS */
T3.C1,
SUBSTR(T1.C2,1,10) C2
FROM
T3,
T1
WHERE
T1.C1=T3.C1
AND T1.C1 BETWEEN :N1 AND :N2;
SELECT
*
FROM
TABLE(DBMS_XPLAN.DISPLAY_CURSOR(NULL,NULL,'ALLSTATS LAST'));
SQL_ID cvq22z77c8fww, child number 0
-------------------------------------
SELECT /*+ GATHER_PLAN_STATISTICS */ T3.C1, SUBSTR(T1.C2,1,10) C2 FROM T3,
T1 WHERE T1.C1=T3.C1 AND T1.C1 BETWEEN :N1 AND :N2
Plan hash value: 3807353021
--------------------------------------------------------------------------------------------------------------------------------------------------------------
| Id | Operation | Name | Starts | E-Rows | A-Rows | A-Time | Buffers | Reads | Writes | OMem | 1Mem | Used-Mem |Used-Tmp|
--------------------------------------------------------------------------------------------------------------------------------------------------------------
|* 1 | FILTER | | 1 | | 500K|00:00:18.48 | 105K| 61283 | 4995 | | | | |
|* 2 | HASH JOIN | | 1 | 9 | 500K|00:00:17.98 | 105K| 61283 | 4995 | 15M| 3722K| 18M (1)| 43008 |
|* 3 | TABLE ACCESS FULL | T3 | 1 | 10 | 500K|00:00:01.51 | 37138 | 37125 | 0 | | | | |
| 4 | TABLE ACCESS BY INDEX ROWID| T1 | 1 | 10 | 500K|00:00:11.50 | 68480 | 19163 | 0 | | | | |
|* 5 | INDEX RANGE SCAN | SYS_C0020554 | 1 | 10 | 500K|00:00:01.00 | 25893 | 648 | 0 | | | | |
--------------------------------------------------------------------------------------------------------------------------------------------------------------
Predicate Information (identified by operation id):
---------------------------------------------------
1 - filter(:N1<=:N2)
2 - access("T1"."C1"="T3"."C1")
3 - filter(("T3"."C1"<=:N2 AND "T3"."C1">=:N1))
5 - access("T1"."C1">=:N1 AND "T1"."C1"<=:N2)
可以看到,这次没有发生硬解析(SQL_ID 和子游标编号和之前保持一致),两份 DBMS_XPLAN 输出里的 E-Rows 列的值也完全相同。
Used-Tmp 列说明,上一次执行时哈希连接发生了溢盘,在 TEMP 临时表空间中占用了 43008×1024 字节的空间。
我们修改优化器模式,再重新测试一次:
EXEC :N2:=10
ALTER SESSION SET OPTIMIZER_MODE='FIRST_ROWS_1';
SELECT /*+ GATHER_PLAN_STATISTICS */
T3.C1,
SUBSTR(T1.C2,1,10) C2
FROM
T3,
T1
WHERE
T1.C1=T3.C1
AND T1.C1 BETWEEN :N1 AND :N2;
SELECT
*
FROM
TABLE(DBMS_XPLAN.DISPLAY_CURSOR(NULL,NULL,'ALLSTATS LAST'));
SQL_ID cvq22z77c8fww, child number 1
-------------------------------------
SELECT /*+ GATHER_PLAN_STATISTICS */ T3.C1, SUBSTR(T1.C2,1,10) C2 FROM T3,
T1 WHERE T1.C1=T3.C1 AND T1.C1 BETWEEN :N1 AND :N2
Plan hash value: 3268213130
----------------------------------------------------------------------------------------------------------------
| Id | Operation | Name | Starts | E-Rows | A-Rows| A-Time | Buffers | Reads |
----------------------------------------------------------------------------------------------------------------
|* 1 | FILTER | | 1 | | 10|00:00:00.01 | 37171 | 37125 |
| 2 | NESTED LOOPS | | 1 | 2 | 10|00:00:00.01 | 37171 | 37125 |
|* 3 | TABLE ACCESS FULL | T3 | 1 | 7 | 10|00:00:00.01 | 37139 | 37125 |
| 4 | TABLE ACCESS BY INDEX ROWID| T1 | 10 | 1 | 10|00:00:00.01 | 32 | 0 |
|* 5 | INDEX UNIQUE SCAN | SYS_C0020554 | 10 | 1 | 10|00:00:00.01 | 22 | 0 |
----------------------------------------------------------------------------------------------------------------
Predicate Information (identified by operation id):
---------------------------------------------------
1 - filter(:N1<=:N2)
3 - filter(("T3"."C1"<=:N2 AND "T3"."C1">=:N1))
5 - access("T1"."C1"="T3"."C1")
filter(("T1"."C1"<=:N2 AND "T1"."C1">=:N1))
EXEC :N2:=500000
SELECT /*+ GATHER_PLAN_STATISTICS */
T3.C1,
SUBSTR(T1.C2,1,10) C2
FROM
T3,
T1
WHERE
T1.C1=T3.C1
AND T1.C1 BETWEEN :N1 AND :N2;
SELECT
*
FROM
TABLE(DBMS_XPLAN.DISPLAY_CURSOR(NULL,NULL,'ALLSTATS LAST'));
SQL_ID cvq22z77c8fww, child number 1
-------------------------------------
SELECT /*+ GATHER_PLAN_STATISTICS */ T3.C1, SUBSTR(T1.C2,1,10) C2 FROM T3,
T1 WHERET1.C1=T3.C1 AND T1.C1 BETWEEN :N1 AND :N2
Plan hash value: 3268213130
-----------------------------------------------------------------------------------------------------------------
| Id | Operation | Name | Starts | E-Rows | A-Rows | A-Time | Buffers | Reads |
-----------------------------------------------------------------------------------------------------------------
|* 1 | FILTER | | 1 | | 500K|00:00:18.03 | 1603K| 56267 |
| 2 | NESTED LOOPS | | 1 | 2 | 500K|00:00:17.53 | 1603K| 56267 |
|* 3 | TABLE ACCESS FULL | T3 | 1 | 7 | 500K|00:00:04.51 | 70472 | 37125 |
| 4 | TABLE ACCESS BY INDEX ROWID| T1 | 500K| 1 | 500K|00:00:13.43 | 1533K| 19142 |
|* 5 | INDEX UNIQUE SCAN | SYS_C0020554 | 500K| 1 | 500K|00:00:04.21 | 1033K| 637 |
-----------------------------------------------------------------------------------------------------------------
Predicate Information (identified by operation id):
---------------------------------------------------
1 - filter(:N1<=:N2)
3 - filter(("T3"."C1"<=:N2 AND "T3"."C1">=:N1))
5 - access("T1"."C1"="T3"."C1")
filter(("T1"."C1"<=:N2 AND "T1"."C1">=:N1))
当优化器模式设置为 `FIRST_ROWS_1` 时,这条 SQL 执行耗时 18.03 秒;设置为 `ALL_ROWS` 时耗时 18.48 秒(而之前只取回 10 行数据的场景,耗时分别是 0.01 秒和 5.60 秒)。
这么一看,是不是意味着想要优化性能,就应该把 `OPTIMIZER_MODE` 设置成 `FIRST_ROWS_1`?简短回答:**并不是**。这个问题我们会放在后续博客中深入探讨。
接下来我们来看**未收集统计信息的表**。我们修改这条使用绑定变量的原始 SQL,让它访问两张表 —— 这两张表以及它们的索引都没有最新的统计信息:
EXEC :N2:=10
ALTER SESSION SET OPTIMIZER_MODE='ALL_ROWS';
SELECT /*+ GATHER_PLAN_STATISTICS */
T4.C1,
SUBSTR(T2.C2,1,10) C2
FROM
T4,
T2
WHERE
T2.C1=T4.C1
AND T2.C1 BETWEEN :N1 AND :N2;
SELECT
*
FROM
TABLE(DBMS_XPLAN.DISPLAY_CURSOR(NULL,NULL,'ALLSTATS LAST'));
SQL_ID 94bv1jwkzcc38, child number 0
-------------------------------------
SELECT /*+ GATHER_PLAN_STATISTICS */ T4.C1, SUBSTR(T2.C2,1,10) C2 FROM T4,
T2 WHERE T2.C1=T4.C1 AND T2.C1 BETWEEN :N1 AND :N2
Plan hash value: 3374068464
-------------------------------------------------------------------------------------------------------------------------------------------
| Id | Operation | Name | Starts | E-Rows | A-Rows| A-Time | Buffers | Reads | OMem | 1Mem | Used-Mem |
-------------------------------------------------------------------------------------------------------------------------------------------
|* 1 | FILTER | | 1 | | 10|00:00:00.01 | 74124 | 36361 | | | |
|* 2 | HASH JOIN | | 1 | 10 | 10|00:00:00.01 | 74124 | 36361 | 711K| 711K| 1087K (0)|
| 3 | TABLE ACCESS BY INDEX ROWID| T2 | 1 | 10 | 10|00:00:00.01 | 5 | 1 | | | |
|* 4 | INDEX RANGE SCAN | SYS_C0020555 | 1 | 10 | 10|00:00:00.01 | 3 | 0 | | | |
|* 5 | TABLE ACCESS FULL | T4 | 1 | 408 | 10|00:00:00.01 | 74119 | 36360 | | | |
-------------------------------------------------------------------------------------------------------------------------------------------
Predicate Information (identified by operation id):
---------------------------------------------------
1 - filter(:N1<=:N2)
2 - access("T2"."C1"="T4"."C1")
4 - access("T2"."C1">=:N1 AND "T2"."C1"<=:N2)
5 - filter(("T4"."C1">=:N1 AND "T4"."C1"<=:N2))
Note
-----
- dynamic sampling used for this statement
里唯一的变化是:Oracle 现在预估返回 10 行,而不是之前看到的 9 行;
另外在谓词信息下方有一行备注,标明本次使用了动态采样。还有一点,执行计划里 `HASH JOIN` 下方两行行源的顺序发生了变化。
ALTER SESSION SET OPTIMIZER_MODE='FIRST_ROWS_1';
SELECT /*+ GATHER_PLAN_STATISTICS */
T4.C1,
SUBSTR(T2.C2,1,10) C2
FROM
T4,
T2
WHERE
T2.C1=T4.C1
AND T2.C1 BETWEEN :N1 AND :N2;
SELECT
*
FROM
TABLE(DBMS_XPLAN.DISPLAY_CURSOR(NULL,NULL,'ALLSTATS LAST'));
SQL_ID 94bv1jwkzcc38, child number 1
-------------------------------------
SELECT /*+ GATHER_PLAN_STATISTICS */ T4.C1, SUBSTR(T2.C2,1,10) C2 FROM T4,
T2 WHERE T2.C1=T4.C1 AND T2.C1 BETWEEN :N1 AND :N2
Plan hash value: 3374068464
--------------------------------------------------------------------------------------------------------------------------------------------
| Id | Operation | Name | Starts | E-Rows | A-Rows| A-Time | Buffers | Reads | OMem | 1Mem | Used-Mem |
--------------------------------------------------------------------------------------------------------------------------------------------
|* 1 | FILTER | | 1 | | 10|00:00:00.01 | 37143 | 37120 | | | |
|* 2 | HASH JOIN | | 1 | 10 | 10|00:00:00.01 | 37143 | 37120 | 711K| 711K| 1087K (0)|
| 3 | TABLE ACCESS BY INDEX ROWID| T2 | 1 | 10 | 10|00:00:00.01 | 4 | 0 | | | |
|* 4 | INDEX RANGE SCAN | SYS_C0020555 | 1 | 10 | 10|00:00:00.01 | 3 | 0 | | | |
|* 5 | TABLE ACCESS FULL | T4 | 1 | 2307 | 10|00:00:00.01 | 37139 | 37120 | | | |
--------------------------------------------------------------------------------------------------------------------------------------------
Predicate Information (identified by operation id):
---------------------------------------------------
1 - filter(:N1<=:N2)
2 - access("T2"."C1"="T4"."C1")
4 - access("T2"."C1">=:N1 AND "T2"."C1"<=:N2)
5 - filter(("T4"."C1">=:N1 AND "T4"."C1"<=:N2))
Note
-----
- dynamic sampling used for this statement
好的,和 SQL 访问 T1、T3 表时相比,这份执行计划发生了一些变化。执行计划不再使用嵌套循环连接,实际上,它采用的和优化器模式设为 `ALL_ROWS` 时一样的计划。
Oracle 9i 以及更早版本的默认优化器模式是 `CHOOSE`,我们看看在这两张表上使用该优化器模式会是什么效果:
ALTER SESSION SET OPTIMIZER_MODE='CHOOSE';
SELECT /*+ GATHER_PLAN_STATISTICS */
T4.C1,
SUBSTR(T2.C2,1,10) C2
FROM
T4,
T2
WHERE
T2.C1=T4.C1
AND T2.C1 BETWEEN :N1 AND :N2;
SELECT
*
FROM
TABLE(DBMS_XPLAN.DISPLAY_CURSOR(NULL,NULL,'ALLSTATS LAST'));
SQL_ID 94bv1jwkzcc38, child number 2
-------------------------------------
SELECT /*+ GATHER_PLAN_STATISTICS */ T4.C1, SUBSTR(T2.C2,1,10) C2 FROM T4,
T2 WHERE T2.C1=T4.C1 AND T2.C1 BETWEEN :N1 AND :N2
Plan hash value: 1544755769
-------------------------------------------------------------------------------------------------------
| Id | Operation | Name | Starts | A-Rows | A-Time | Buffers | Reads |
-------------------------------------------------------------------------------------------------------
| 1 | NESTED LOOPS | | 1 | 10 |00:00:00.02 | 2039K| 39001 |
| 2 | TABLE ACCESS FULL | T4 | 1 | 1000K|00:00:02.02 | 37139 | 37125 |
| 3 | TABLE ACCESS BY INDEX ROWID| T2 | 1000K| 10 |00:00:06.80 | 2001K| 1876 |
|* 4 | INDEX UNIQUE SCAN | SYS_C0020555 | 1000K| 10 |00:00:04.78 | 2001K| 1876 |
-------------------------------------------------------------------------------------------------------
Predicate Information (identified by operation id):
---------------------------------------------------
4 - access("T2"."C1"="T4"."C1")
filter(("T2"."C1"<=:N2 AND "T2"."C1">=:N1))
Note
-----
- rule based optimizer used (consider using cbo)
注意执行计划的备注部分标明使用了**基于规则的优化器(RBO)**,然而 Oracle 官方文档(http://download.oracle.com/docs/cd/B19306_01/server.102/b14238/compat.htm)写明,
从 Oracle 10.1 版本开始,就已经不再支持 RULE 规则优化器。
另外还能看到,当前执行计划改用嵌套循环连接,FILTER 过滤算子已经消失;并且在`NESTED LOOPS`算子下方,全表扫描排在第一位,这和优化器模式设置为`FIRST_ROWS_1`、查询访问 T1 与 T3 表时的表现完全一致。
我们假设 C1 列存储的是信用卡号。
接下来做一项实验:获取`SQL_ID = cvq22z77c8fww`的全部子游标,同时拿到该 SQL 第一次硬解析时传入的绑定变量值。
**生产环境要谨慎管控该功能的访问权限,因为它可能泄露敏感数据。**
SELECT
*
FROM
TABLE(DBMS_XPLAN.DISPLAY_CURSOR('cvq22z77c8fww',NULL,'ALLSTATS LAST +PEEKED_BINDS'));
PLAN_TABLE_OUTPUT
------------------------------------------------------------------------------------------------------------------------------------------------------
SQL_ID cvq22z77c8fww, child number 0
-------------------------------------
SELECT /*+ GATHER_PLAN_STATISTICS */ T3.C1, SUBSTR(T1.C2,1,10) C2 FROM T3, T1 WHERE T1.C1=T3.C1 AND T1.C1 BETWEEN :N1 AND :N2
Plan hash value: 3807353021
------------------------------------------------------------------------------------------------------------------------------------------------------
| Id | Operation | Name | Starts | E-Rows | A-Rows | A-Time | Buffers | Reads | OMem | 1Mem | Used-Mem | Used-Tmp|
------------------------------------------------------------------------------------------------------------------------------------------------------
|* 1 | FILTER | | 1 | | 10 |00:00:04.28 | 37144 | 37125 | | | | |
|* 2 | HASH JOIN | | 1 | 9 | 10 |00:00:04.28 | 37144 | 37125 | 1452K| 1452K| 2315K (0)| |
|* 3 | TABLE ACCESS FULL | T3 | 1 | 10 | 10 |00:00:00.01 | 37138 | 37125 | | | | |
| 4 | TABLE ACCESS BY INDEX ROWID| T1 | 1 | 10 | 10 |00:00:00.01 | 6 | 0 | | | | |
|* 5 | INDEX RANGE SCAN | SYS_C0020554 | 1 | 10 | 10 |00:00:00.01 | 4 | 0 | | | | |
------------------------------------------------------------------------------------------------------------------------------------------------------
Peeked Binds (identified by position):
--------------------------------------
1 - (NUMBER): 1
2 - (NUMBER): 10
Predicate Information (identified by operation id):
---------------------------------------------------
1 - filter(:N1<=:N2)
2 - access("T1"."C1"="T3"."C1")
3 - filter(("T3"."C1"<=:N2 AND "T3"."C1">=:N1))
5 - access("T1"."C1">=:N1 AND "T1"."C1"<=:N2)
-
SQL_ID cvq22z77c8fww, child number 1
-------------------------------------
SELECT /*+ GATHER_PLAN_STATISTICS */ T3.C1, SUBSTR(T1.C2,1,10) C2 FROM T3, T1 WHERE
T1.C1=T3.C1 AND T1.C1 BETWEEN :N1 AND :N2
Plan hash value: 3268213130
-----------------------------------------------------------------------------------------------------------------
| Id | Operation | Name | Starts | E-Rows | A-Rows | A-Time | Buffers | Reads |
-----------------------------------------------------------------------------------------------------------------
|* 1 | FILTER | | 1 | | 500K|00:00:18.03 | 1603K| 56267 |
| 2 | NESTED LOOPS | | 1 | 2 | 500K|00:00:17.53 | 1603K| 56267 |
|* 3 | TABLE ACCESS FULL | T3 | 1 | 7 | 500K|00:00:04.51 | 70472 | 37125 |
| 4 | TABLE ACCESS BY INDEX ROWID| T1 | 500K| 1 | 500K|00:00:13.43 | 1533K| 19142 |
|* 5 | INDEX UNIQUE SCAN | SYS_C0020554 | 500K| 1 | 500K|00:00:04.21 | 1033K| 637 |
-----------------------------------------------------------------------------------------------------------------
Peeked Binds (identified by position):
--------------------------------------
1 - (NUMBER): 1
2 - (NUMBER): 10
Predicate Information (identified by operation id):
---------------------------------------------------
1 - filter(:N1<=:N2)
3 - filter(("T3"."C1"<=:N2 AND "T3"."C1">=:N1))
5 - access("T1"."C1"="T3"."C1")
filter(("T1"."C1"<=:N2 AND "T1"."C1">=:N1))
-
SQL_ID 94bv1jwkzcc38, child number 2
-------------------------------------
SELECT /*+ GATHER_PLAN_STATISTICS */ T4.C1, SUBSTR(T2.C2,1,10) C2 FROM T4,
T2 WHERET2.C1=T4.C1 AND T2.C1 BETWEEN :N1 AND :N2
Plan hash value: 1544755769
-------------------------------------------------------------------------------------------------------
| Id | Operation | Name | Starts | A-Rows | A-Time | Buffers | Reads |
-------------------------------------------------------------------------------------------------------
| 1 | NESTED LOOPS | | 1 | 10 |00:00:00.02 | 2039K| 39001 |
| 2 | TABLE ACCESS FULL | T4 | 1 | 1000K|00:00:02.02 | 37139 | 37125 |
| 3 | TABLE ACCESS BY INDEX ROWID| T2 | 1000K| 10 |00:00:06.80 | 2001K| 1876 |
|* 4 | INDEX UNIQUE SCAN | SYS_C0020555 | 1000K| 10 |00:00:04.78 | 2001K| 1876 |
-------------------------------------------------------------------------------------------------------
Predicate Information (identified by operation id):
---------------------------------------------------
4 - access("T2"."C1"="T4"."C1")
filter(("T2"."C1"<=:N2 AND "T2"."C1">=:N1))
Note
-----
- rule based optimizer used (consider using cbo)
想要了解更多关于 `DBMS_XPLAN.DISPLAY_CURSOR` 的内容,可以查阅官方文档:http://download.oracle.com/docs/cd/E11882_01/appdev.112/e10577/d_xplan.htm#sthref14168。
那么,如果我们想知道**这些子游标为什么会被创建**,该怎么做?我们可以执行类似下面这样的查询:
DESC V$SQL_SHARED_CURSOR
SET LINESIZE 200
SET HEADING ON
BREAK ON SQL_ID SKIP 1
SELECT
*
FROM
V$SQL_SHARED_CURSOR
WHERE
SQL_ID='94bv1jwkzcc38';
SQL_ID ADDRESS CHILD_ADDRESS CHILD_NUMBER USOOSLSEBPISTABDLTRIIRLIOSMUTNFAITDLDBPCSRPTMBMROPMFL
------------- ---------------- ---------------- ------------ -----------------------------------------------------
94bv1jwkzcc38 000007FF9829D308 000007FFA68C1038 0 NNNNNNNNNNNNNNNNNNNNNNNNNNNNNNNNNNNNNNNNNNNNNNNNNNNNN
000007FF9829D308 000007FF94E0D950 1 NNNNNNNNNNNNNNNNNNNNNNNNNNNNNNNNNNNNNNNNNNNNNNNNYNNNN
000007FF9829D308 000007FF98046318 2 NNNNNNNNNNNNNNNNNNNNNNNNNNNNNNNNNNNNNNNNNNNNNNNNYNNNN
上面的结果表明,子游标之所以被创建,原因是**优化器模式不匹配**(没错,我们修改过 `OPTIMIZER_MODE`)。
我们也可以检查绑定变量的定义(本例中其实不需要,因为我们已经在 `DBMS_XPLAN` 里使用了未公开的格式参数 `PEEKED_BINDS`,查看了大部分相关信息):
SELECT
S.CHILD_NUMBER CN,
SBM.*
FROM
V$SQL_BIND_METADATA SBM,
V$SQL S
WHERE
S.SQL_ID='94bv1jwkzcc38'
AND S.CHILD_ADDRESS=SBM.ADDRESS
ORDER BY
S.CHILD_NUMBER,
SBM.POSITION;
CN ADDRESS POSITION DATATYPE MAX_LENGTH ARRAY_LEN BIND_NAME
--- ---------------- ---------- ---------- ---------- ---------- ---------
0 000007FFA68C1038 1 2 22 0 N1
0 000007FFA68C1038 2 2 22 0 N2
1 000007FF94E0D950 1 2 22 0 N1
1 000007FF94E0D950 2 2 22 0 N2
2 000007FF98046318 1 2 22 0 N1
2 000007FF98046318 2 2 22 0 N2
好了,刚才我们稍微跑题了,现在回到查看执行计划这个主题上来。上面这些示例展示的是 SQL**实际执行所采用的执行计划**,
它和 `explain plan` 生成的预估计划有可能不一样。我们来试一试 `EXPLAIN PLAN FOR` 语法(`DBMS_XPLAN.DISPLAY` 在 Oracle 9.2.0.1 及以上版本可用):
ALTER SYSTEM FLUSH SHARED_POOL;
ALTER SESSION SET OPTIMIZER_MODE='ALL_ROWS';
EXPLAIN PLAN FOR
SELECT
T3.C1,
SUBSTR(T1.C2,1,10) C2
FROM
T3,
T1
WHERE
T1.C1=T3.C1
AND T1.C1 BETWEEN 1 AND 10;
Explained.
SELECT
*
FROM
TABLE(DBMS_XPLAN.DISPLAY());
Plan hash value: 1519387310
---------------------------------------------------------------------------------------------
| Id | Operation | Name | Rows | Bytes | Cost (%CPU)| Time |
---------------------------------------------------------------------------------------------
| 0 | SELECT STATEMENT | | 9 | 2385 | 1893 (4)| 00:00:09 |
|* 1 | HASH JOIN | | 9 | 2385 | 1893 (4)| 00:00:09 |
|* 2 | TABLE ACCESS FULL | T3 | 10 | 50 | 1888 (4)| 00:00:09 |
| 3 | TABLE ACCESS BY INDEX ROWID| T1 | 10 | 2600 | 4 (0)| 00:00:01 |
|* 4 | INDEX RANGE SCAN | SYS_C0020554 | 10 | | 3 (0)| 00:00:01 |
---------------------------------------------------------------------------------------------
Predicate Information (identified by operation id):
---------------------------------------------------
1 - access("T1"."C1"="T3"."C1")
2 - filter("T3"."C1"<=10 AND "T3"."C1">=1)
4 - access("T1"."C1">=1 AND "T1"."C1"<=10)
上面这份计划看起来和第一条真实执行计划完全相同。接下来我们使用绑定变量再做一次测试:
VARIABLE N1 NUMBER
VARIABLE N2 NUMBER
EXEC :N1:=1
EXEC :N2:=10
EXPLAIN PLAN FOR
SELECT
T3.C1,
SUBSTR(T1.C2,1,10) C2
FROM
T3,
T1
WHERE
T1.C1=T3.C1
AND T1.C1 BETWEEN :N1 AND :N2;
Explained.
SELECT
*
FROM
TABLE(DBMS_XPLAN.DISPLAY());
Plan hash value: 3807353021
----------------------------------------------------------------------------------------------
| Id | Operation | Name | Rows | Bytes | Cost (%CPU)| Time |
----------------------------------------------------------------------------------------------
| 0 | SELECT STATEMENT | | 2499 | 646K| 2084 (5)| 00:00:10 |
|* 1 | FILTER | | | | | |
|* 2 | HASH JOIN | | 2499 | 646K| 2084 (5)| 00:00:10 |
|* 3 | TABLE ACCESS FULL | T3 | 2500 | 12500 | 1905 (5)| 00:00:10 |
| 4 | TABLE ACCESS BY INDEX ROWID| T1 | 2500 | 634K| 178 (0)| 00:00:01 |
|* 5 | INDEX RANGE SCAN | SYS_C0020554 | 4500 | | 11 (0)| 00:00:01 |
----------------------------------------------------------------------------------------------
Predicate Information (identified by operation id):
---------------------------------------------------
1 - filter(TO_NUMBER(:N1)<=TO_NUMBER(:N2))
2 - access("T1"."C1"="T3"."C1")
3 - filter("T3"."C1">=TO_NUMBER(:N1) AND "T3"."C1"<=TO_NUMBER(:N2))
5 - access("T1"."C1">=TO_NUMBER(:N1) AND "T1"."C1"<=TO_NUMBER(:N2))
可以留意到,在上面结果的谓词信息部分,每个绑定变量外面都包裹了 `TO_NUMBER` 转换,
尽管这些绑定变量本身定义的就是 NUMBER 数据类型。代价值也出现了小幅上升。
接下来我们使用 AUTOTRACE 查看执行计划(从 Oracle 10.1.0.1 版本开始,AUTOTRACE 底层会调用 DBMS_XPLAN 输出格式化后的执行计划)。
SET AUTOTRACE TRACEONLY EXPLAIN
SELECT
T3.C1,
SUBSTR(T1.C2,1,10) C2
FROM
T3,
T1
WHERE
T1.C1=T3.C1
AND T1.C1 BETWEEN :N1 AND :N2;
Execution Plan
----------------------------------------------------------
Plan hash value: 3807353021
----------------------------------------------------------------------------------------------
| Id | Operation | Name | Rows | Bytes | Cost (%CPU)| Time |
----------------------------------------------------------------------------------------------
| 0 | SELECT STATEMENT | | 2499 | 646K| 2084 (5)| 00:00:10 |
|* 1 | FILTER | | | | | |
|* 2 | HASH JOIN | | 2499 | 646K| 2084 (5)| 00:00:10 |
|* 3 | TABLE ACCESS FULL | T3 | 2500 | 12500 | 1905 (5)| 00:00:10 |
| 4 | TABLE ACCESS BY INDEX ROWID| T1 | 2500 | 634K| 178 (0)| 00:00:01 |
|* 5 | INDEX RANGE SCAN | SYS_C0020554 | 4500 | | 11 (0)| 00:00:01 |
----------------------------------------------------------------------------------------------
Predicate Information (identified by operation id):
---------------------------------------------------
1 - filter(TO_NUMBER(:N1)<=TO_NUMBER(:N2))
2 - access("T1"."C1"="T3"."C1")
3 - filter("T3"."C1">=TO_NUMBER(:N1) AND "T3"."C1"<=TO_NUMBER(:N2))
5 - access("T1"."C1">=TO_NUMBER(:N1) AND "T1"."C1"<=TO_NUMBER(:N2))
好的,在 Oracle 10.1.0.1 及以上版本中,这里的输出和前面示例是一样的,谓词信息部分依旧存在不正确的内容。
我们再同时查看运行时统计信息以及 explain plan:
SET AUTOTRACE TRACEONLY STATISTICS EXPLAIN
SELECT
T3.C1,
SUBSTR(T1.C2,1,10) C2
FROM
T3,
T1
WHERE
T1.C1=T3.C1
AND T1.C1 BETWEEN :N1 AND :N2;
10 rows selected.
Execution Plan
----------------------------------------------------------
Plan hash value: 3807353021
----------------------------------------------------------------------------------------------
| Id | Operation | Name | Rows | Bytes | Cost (%CPU)| Time |
----------------------------------------------------------------------------------------------
| 0 | SELECT STATEMENT | | 2499 | 646K| 2084 (5)| 00:00:10 |
|* 1 | FILTER | | | | | |
|* 2 | HASH JOIN | | 2499 | 646K| 2084 (5)| 00:00:10 |
|* 3 | TABLE ACCESS FULL | T3 | 2500 | 12500 | 1905 (5)| 00:00:10 |
| 4 | TABLE ACCESS BY INDEX ROWID| T1 | 2500 | 634K| 178 (0)| 00:00:01 |
|* 5 | INDEX RANGE SCAN | SYS_C0020554 | 4500 | | 11 (0)| 00:00:01 |
----------------------------------------------------------------------------------------------
Predicate Information (identified by operation id):
---------------------------------------------------
1 - filter(TO_NUMBER(:N1)<=TO_NUMBER(:N2))
2 - access("T1"."C1"="T3"."C1")
3 - filter("T3"."C1">=TO_NUMBER(:N1) AND "T3"."C1"<=TO_NUMBER(:N2))
5 - access("T1"."C1">=TO_NUMBER(:N1) AND "T1"."C1"<=TO_NUMBER(:N2))
Statistics
----------------------------------------------------------
0 recursive calls
0 db block gets
37144 consistent gets
37125 physical reads
0 redo size
579 bytes sent via SQL*Net to client
334 bytes received via SQL*Net from client
2 SQL*Net roundtrips to/from client
0 sorts (memory)
0 sorts (disk)
10 rows processed
请注意:上面这份计划**未必是真实执行计划**,哪怕我们同时看到了真实的运行时统计。这一点很容易让人困惑:我们看到的是一份粗略估算出来的执行计划,搭配着真实的执行统计数据。
想要了解更多 `EXPLAIN PLAN` 的用法,可参考官方文档:http://download.oracle.com/docs/cd/E11882_01/server.112/e10821/ex_plan.htm。
再来做一组测试。这一次我们配置 Oracle,让它每次发生硬解析时,都把真实执行计划写入跟踪文件。我们通过在 SQL 语句中增加注释的方式,强制触发一次硬解析:
ALTER SESSION SET TRACEFILE_IDENTIFIER = '10132_HARD_PARSE';
ALTER SESSION SET EVENTS '10132 TRACE NAME CONTEXT FOREVER, LEVEL 1';
SELECT /* TEST */
  T3.C1,
  SUBSTR(T1.C2,1,10) C2
FROM
  T3,
  T1
WHERE
  T1.C1=T3.C1
  AND T1.C1 BETWEEN :N1 AND :N2;
ALTER SESSION SET EVENTS '10132 TRACE NAME CONTEXT OFF';
如果我们查看跟踪文件里的输出内容,可能会看到类似下面这样的信息:
sql_id=3g3fc5qyju0j3.
Current SQL statement for this session:
SELECT /* TEST */
T3.C1,
SUBSTR(T1.C2,1,10) C2
FROM
T3,
T1
WHERE
T1.C1=T3.C1
AND T1.C1 BETWEEN :N1 AND :N2
============
Plan Table
============
-----------------------------------------------------+-----------------------------------+
| Id | Operation | Name | Rows | Bytes | Cost | Time |
-----------------------------------------------------+-----------------------------------+
| 0 | SELECT STATEMENT | | | | 1893 | |
| 1 | FILTER | | | | | |
| 2 | HASH JOIN | | 9 | 2385 | 1893 | 00:00:09 |
| 3 | TABLE ACCESS FULL | T3 | 10 | 50 | 1888 | 00:00:09 |
| 4 | TABLE ACCESS BY INDEX ROWID | T1 | 10 | 2600 | 4 | 00:00:01 |
| 5 | INDEX RANGE SCAN | SYS_C0020554| 10 | | 3 | 00:00:01 |
-----------------------------------------------------+-----------------------------------+
Predicate Information:
----------------------
1 - filter(:N1<=:N2)
2 - access("T1"."C1"="T3"."C1")
3 - filter(("T3"."C1"<=:N2 AND "T3"."C1">=:N1))
5 - access("T1"."C1">=:N1 AND "T1"."C1"<=:N2)
Content of other_xml column
===========================
db_version : 10.2.0.2
parse_schema : TESTUSER
plan_hash : 3807353021
Peeked Binds
============
Bind variable information
position=1
datatype(code)=2
datatype(string)=NUMBER
precision=0
scale=0
max length=22
value=1
Bind variable information
position=2
datatype(code)=2
datatype(string)=NUMBER
precision=0
scale=0
max length=22
value=10
Outline Data:
/*+
BEGIN_OUTLINE_DATA
IGNORE_OPTIM_EMBEDDED_HINTS
OPTIMIZER_FEATURES_ENABLE('10.2.0.1')
ALL_ROWS
OUTLINE_LEAF(@"SEL$1")
FULL(@"SEL$1" "T3"@"SEL$1")
INDEX(@"SEL$1" "T1"@"SEL$1" ("T1"."C1"))
LEADING(@"SEL$1" "T3"@"SEL$1" "T1"@"SEL$1")
USE_HASH(@"SEL$1" "T1"@"SEL$1")
END_OUTLINE_DATA
*/
Optimizer environment:
optimizer_mode_hinted = false
optimizer_features_hinted = 0.0.0
parallel_execution_enabled = false
parallel_query_forced_dop = 0
parallel_dml_forced_dop = 0
parallel_ddl_forced_degree = 0
parallel_ddl_forced_instances = 0
_query_rewrite_fudge = 90
optimizer_features_enable = 10.2.0.1
_optimizer_search_limit = 5
cpu_count = 4
active_instance_count = 1
parallel_threads_per_cpu = 2
hash_area_size = 131072
bitmap_merge_area_size = 1048576
sort_area_size = 65536
sort_area_retained_size = 0
_sort_elimination_cost_ratio = 0
_optimizer_block_size = 8192
_sort_multiblock_read_count = 2
_hash_multiblock_io_count = 0
_db_file_optimizer_read_count = 128
_optimizer_max_permutations = 2000
pga_aggregate_target = 204800 KB
_pga_max_size = 204800 KB
_query_rewrite_maxdisjunct = 257
_smm_auto_min_io_size = 56 KB
_smm_auto_max_io_size = 248 KB
_smm_min_size = 204 KB
_smm_max_size = 40960 KB
_smm_px_max_size = 102400 KB
_cpu_to_io = 0
_optimizer_undo_cost_change = 10.2.0.1
parallel_query_mode = enabled
parallel_dml_mode = disabled
parallel_ddl_mode = enabled
optimizer_mode = all_rows
sqlstat_enabled = false
_optimizer_percent_parallel = 101
_always_anti_join = choose
_always_semi_join = choose
_optimizer_mode_force = true
_partition_view_enabled = true
_always_star_transformation = false
_query_rewrite_or_error = false
_hash_join_enabled = true
cursor_sharing = exact
_b_tree_bitmap_plans = true
star_transformation_enabled = false
_optimizer_cost_model = choose
_new_sort_cost_estimate = true
_complex_view_merging = true
_unnest_subquery = true
_eliminate_common_subexpr = true
_pred_move_around = true
_convert_set_to_join = false
_push_join_predicate = true
_push_join_union_view = true
_fast_full_scan_enabled = true
_optim_enhance_nnull_detection = true
_parallel_broadcast_enabled = true
_px_broadcast_fudge_factor = 100
_ordered_nested_loop = true
_no_or_expansion = false
optimizer_index_cost_adj = 100
optimizer_index_caching = 0
_system_index_caching = 0
_disable_datalayer_sampling = false
query_rewrite_enabled = true
query_rewrite_integrity = enforced
_query_cost_rewrite = true
_query_rewrite_2 = true
_query_rewrite_1 = true
_query_rewrite_expression = true
_query_rewrite_jgmigrate = true
_query_rewrite_fpc = true
_query_rewrite_drj = true
_full_pwise_join_enabled = true
_partial_pwise_join_enabled = true
_left_nested_loops_random = true
_improved_row_length_enabled = true
_index_join_enabled = true
_enable_type_dep_selectivity = true
_improved_outerjoin_card = true
_optimizer_adjust_for_nulls = true
_optimizer_degree = 0
_use_column_stats_for_function = true
_subquery_pruning_enabled = true
_subquery_pruning_mv_enabled = false
_or_expand_nvl_predicate = true
_like_with_bind_as_equality = false
_table_scan_cost_plus_one = true
_cost_equality_semi_join = true
_default_non_equality_sel_check = true
_new_initial_join_orders = true
_oneside_colstat_for_equijoins = true
_optim_peek_user_binds = true
_minimal_stats_aggregation = true
_force_temptables_for_gsets = false
workarea_size_policy = auto
_smm_auto_cost_enabled = true
_gs_anti_semi_join_allowed = true
_optim_new_default_join_sel = true
optimizer_dynamic_sampling = 2
_pre_rewrite_push_pred = true
_optimizer_new_join_card_computation = true
_union_rewrite_for_gs = yes_gset_mvs
_generalized_pruning_enabled = true
_optim_adjust_for_part_skews = true
_force_datefold_trunc = false
statistics_level = typical
_optimizer_system_stats_usage = true
skip_unusable_indexes = true
_remove_aggr_subquery = true
_optimizer_push_down_distinct = 0
_dml_monitoring_enabled = true
_optimizer_undo_changes = false
_predicate_elimination_enabled = true
_nested_loop_fudge = 100
_project_view_columns = true
_local_communication_costing_enabled = true
_local_communication_ratio = 50
_query_rewrite_vop_cleanup = true
_slave_mapping_enabled = true
_optimizer_cost_based_transformation = linear
_optimizer_mjc_enabled = true
_right_outer_hash_enable = true
_spr_push_pred_refspr = true
_optimizer_cache_stats = false
_optimizer_cbqt_factor = 50
_optimizer_squ_bottomup = true
_fic_area_size = 131072
_optimizer_skip_scan_enabled = true
_optimizer_cost_filter_pred = false
_optimizer_sortmerge_join_enabled = true
_optimizer_join_sel_sanity_check = true
_mmv_query_rewrite_enabled = true
_bt_mmv_query_rewrite_enabled = true
_add_stale_mv_to_dependency_list = true
_distinct_view_unnesting = false
_optimizer_dim_subq_join_sel = true
_optimizer_disable_strans_sanity_checks = 0
_optimizer_compute_index_stats = true
_push_join_union_view2 = true
_optimizer_ignore_hints = false
_optimizer_random_plan = 0
_query_rewrite_setopgrw_enable = true
_optimizer_correct_sq_selectivity = true
_disable_function_based_index = false
_optimizer_join_order_control = 3
_optimizer_cartesian_enabled = true
_optimizer_starplan_enabled = true
_extended_pruning_enabled = true
_optimizer_push_pred_cost_based = true
_sql_model_unfold_forloops = run_time
_enable_dml_lock_escalation = false
_bloom_filter_enabled = true
_update_bji_ipdml_enabled = 0
_optimizer_extended_cursor_sharing = udo
_dm_max_shared_pool_pct = 1
_optimizer_cost_hjsmj_multimatch = true
_optimizer_transitivity_retain = true
_px_pwg_enabled = true
optimizer_secure_view_merging = true
_optimizer_join_elimination_enabled = true
flashback_table_rpi = non_fbt
_optimizer_cbqt_no_size_restriction = true
_optimizer_enhanced_filter_push = true
_optimizer_filter_pred_pullup = true
_rowsrc_trace_level = 0
_simple_view_merging = true
_optimizer_rownum_pred_based_fkr = true
_optimizer_better_inlist_costing = all
_optimizer_self_induced_cache_cost = false
_optimizer_min_cache_blocks = 10
_optimizer_or_expansion = depth
_optimizer_order_by_elimination_enabled = true
_optimizer_outer_to_anti_enabled = true
_selfjoin_mv_duplicates = true
_dimension_skip_null = true
_force_rewrite_enable = false
_optimizer_star_tran_in_with_clause = true
_optimizer_complex_pred_selectivity = true
_optimizer_connect_by_cost_based = false
_gby_hash_aggregation_enabled = true
_globalindex_pnum_filter_enabled = false
_fix_control_key = 0
_optimizer_skip_scan_guess = false
_enable_row_shipping = false
*********************************
Bug Fix Control Environment
***************************
fix 4611850 = disabled
fix 4663804 = disabled
fix 4663698 = disabled
fix 4545833 = disabled
fix 3499674 = disabled
fix 4584065 = disabled
fix 4602374 = disabled
fix 4569940 = enabled
fix 4631959 = disabled
fix 4519340 = disabled
fix 4550003 = enabled
fix 4488689 = disabled
fix 3118776 = enabled
fix 4519016 = enabled
fix 4487253 = enabled
fix 4556762 = 0
fix 4728348 = disabled
fix 4723244 = disabled
fix 4554846 = disabled
fix 4175830 = enabled
fix 5240607 = disabled
fix 4722900 = enabled
Query Block Registry:
*********************
SEL$1 0x122d9358 (PARSER) [FINAL]
Optimizer State Dump: call(in-use=53568, alloc=81816), compile(in-use=76816, alloc=126256)
注意,从上面的内容中,我们可以看到真实执行计划、被窥视的绑定变量、能够复现该执行计划的 Hint 集合,以及大量常规和隐藏的优化器参数。
我们可以生成级别为 1 的 10053 跟踪文件,用来查明优化器为何选择这份计划,但这里暂时先不演示。
下面是级别 4 的 10046 跟踪示例(我们必须在待分析 SQL 之后再执行一条其他 SQL,
这样目标 SQL 的 STAT 统计行才会写入跟踪文件):
ALTER SESSION SET TRACEFILE_IDENTIFIER = '10046_EXECUTION_PLAN';
ALTER SESSION SET EVENTS '10046 TRACE NAME CONTEXT FOREVER, LEVEL 4';
SELECT /* TEST */
  T3.C1,
  SUBSTR(T1.C2,1,10) C2
FROM
  T3,
  T1
WHERE
  T1.C1=T3.C1
  AND T1.C1 BETWEEN :N1 AND :N2;
SELECT SYSDATE FROM DUAL;
生成的跟踪文件大致如下:
=====================
PARSING IN CURSOR #34 len=118 dep=0 uid=31 oct=3 lid=31 tim=2087403486 hv=3172794915 ad='9811b110'
SELECT /* TEST */
  T3.C1,
  SUBSTR(T1.C2,1,10) C2
FROM
  T3,
  T1
WHERE
  T1.C1=T3.C1
  AND T1.C1 BETWEEN :N1 AND :N2
END OF STMT
PARSE #34:c=0,e=162,p=0,cr=0,cu=0,mis=0,r=0,dep=0,og=1,tim=2087403479
BINDS #34:
kkscoacd
 Bind#0
  oacdty=02 mxl=22(22) mxlc=00 mal=00 scl=00 pre=00
  oacflg=03 fl2=1000000 frm=00 csi=00 siz=48 off=0
  kxsbbbfp=13beb440  bln=22  avl=02  flg=05
  value=1
 Bind#1
  oacdty=02 mxl=22(22) mxlc=00 mal=00 scl=00 pre=00
  oacflg=03 fl2=1000000 frm=00 csi=00 siz=0 off=24
  kxsbbbfp=13beb458  bln=22  avl=02  flg=01
  value=10
EXEC #34:c=0,e=170,p=0,cr=0,cu=0,mis=0,r=0,dep=0,og=1,tim=2087403808
FETCH #34:c=1078125,e=3875649,p=37124,cr=37142,cu=0,mis=0,r=1,dep=0,og=1,tim=2091279513
FETCH #34:c=0,e=180,p=0,cr=2,cu=0,mis=0,r=9,dep=0,og=1,tim=2091280273
STAT #34 id=1 cnt=10 pid=0 pos=1 obj=0 op='FILTER  (cr=37144 pr=37124 pw=0 time=3875627 us)'
STAT #34 id=2 cnt=10 pid=1 pos=1 obj=0 op='HASH JOIN  (cr=37144 pr=37124 pw=0 time=3875620 us)'
STAT #34 id=3 cnt=10 pid=2 pos=1 obj=114232 op='TABLE ACCESS FULL T3 (cr=37138 pr=37124 pw=0 time=19345 us)'
STAT #34 id=4 cnt=10 pid=2 pos=2 obj=114228 op='TABLE ACCESS BY INDEX ROWID T1 (cr=6 pr=0 pw=0 time=66 us)'
STAT #34 id=5 cnt=10 pid=4 pos=1 obj=114229 op='INDEX RANGE SCAN SYS_C0020554 (cr=4 pr=0 pw=0 time=37 us)'
=====================
当然,我们也可以直接从 10046 跟踪文件里读取真实执行计划、绑定变量的值以及数据类型。
不过这里我们改用 TKPROF 工具处理(使用 TKPROF 时,**无法看到绑定变量的值**)。
C:\> tkprof test_ora_4436_10046_execution_plan.trc test_ora_4436_10046_execution_plan.txt
call     count       cpu    elapsed       disk      query    current        rows
------- ------  -------- ---------- ---------- ---------- ----------  ----------
Parse        1      0.00       0.00          0          0          0           0
Execute      1      0.00       0.00          0          0          0           0
Fetch        2      1.07       3.87      37124      37144          0          10
------- ------  -------- ---------- ---------- ---------- ----------  ----------
total        4      1.07       3.87      37124      37144          0          10
Misses in library cache during parse: 0
Optimizer mode: ALL_ROWS
Parsing user id: 31
Rows     Row Source Operation
-------  ---------------------------------------------------
     10  FILTER  (cr=37144 pr=37124 pw=0 time=3875627 us)
     10   HASH JOIN  (cr=37144 pr=37124 pw=0 time=3875620 us)
     10    TABLE ACCESS FULL T3 (cr=37138 pr=37124 pw=0 time=19345 us)
     10    TABLE ACCESS BY INDEX ROWID T1 (cr=6 pr=0 pw=0 time=66 us)
     10     INDEX RANGE SCAN SYS_C0020554 (cr=4 pr=0 pw=0 time=37 us)(object id 114229)
当然,有一个相当普遍的误区:有些人会在 TKPROF 里使用 EXPLAIN,而不是直接解读**行源操作(Row Source Operation)**这部分内容(行源操作记录的才是真实发生的执行过程 —— 当然也有例外,详情可以参考这篇文章: C:\>tkprof test_ora_4436_10046_execution_plan.trc test_ora_4436_10046_execution_plan.txt EXPLAIN=TESTUSER/TESTPASS
请注意,如果「行源操作(Row Source Operation)」里的计划和下方「执行计划(Execution Plan)」截然不同,
输出结果就非常容易让人混淆:前者是**真实执行计划**,而后者本质上只是 `EXPLAIN PLAN FOR` 这类预估计划:
Rows     Row Source Operation
-------  ---------------------------------------------------
     10  FILTER  (cr=37144 pr=37124 pw=0 time=3875627 us)
     10   HASH JOIN  (cr=37144 pr=37124 pw=0 time=3875620 us)
     10    TABLE ACCESS FULL T3 (cr=37138 pr=37124 pw=0 time=19345 us)
     10    TABLE ACCESS BY INDEX ROWID T1 (cr=6 pr=0 pw=0 time=66 us)
     10     INDEX RANGE SCAN SYS_C0020554 (cr=4 pr=0 pw=0 time=37 us)(object id 114229)
Rows     Execution Plan
-------  ---------------------------------------------------
      0  SELECT STATEMENT   MODE: ALL_ROWS
     10   FILTER
     10    HASH JOIN
     10     TABLE ACCESS   MODE: ANALYZED (FULL) OF 'T3' (TABLE)
     10     TABLE ACCESS   MODE: ANALYZED (BY INDEX ROWID) OF 'T1'
                (TABLE)
     10      INDEX   MODE: ANALYZED (RANGE SCAN) OF 'SYS_C0020554'
                 (INDEX (UNIQUE))
希望到这里,你已经明白什么是执行计划、去哪里查看它,以及需要避开哪些容易踩坑的陷阱。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/12798004/viewspace-3186817/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- 第85期 为什么直方图和绑定变量一起使用时,有时会引发性能问题
- 第84期 查询RAC之间私网的流量信息,监控 RAC 私网流量变化
- 第83期 MySQL JSON Duality View + HeatWave Vector Search for RAG
- 第82期 Oracle 19c RAC集群:如何在线迁移/替换 OCR 磁盘组
- 第81期 批量抓取数据库中耗时最高的SQL自动生成【Active HTML格式的SQL Monitor报告】
- 第80期 追踪 SQL 性能随时间变化、执行计划是否漂移、资源消耗变化
- 第79期 Oracle Buffer Busy Waits 等待事件 P3 参数详解
- 第78期 Oracle Buffer Busy Waits等待事件深入解读
- 第77期 ogg实现REPLICAT进程FILTER数据过滤
- 第76期 明明Oracle表LCADDRESS列定义VARCHAR2(80)ORA-12899报错值太大
