1. 实验环境信息
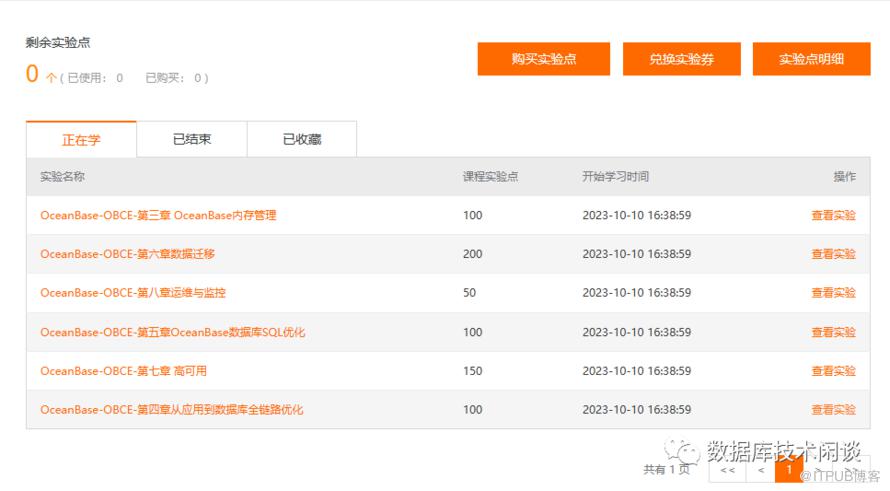
进入实验后,环境并未初始化,点击“资源创建” 。
创建成功后开始紧张的实验环节,倒计时 02:00:00 。
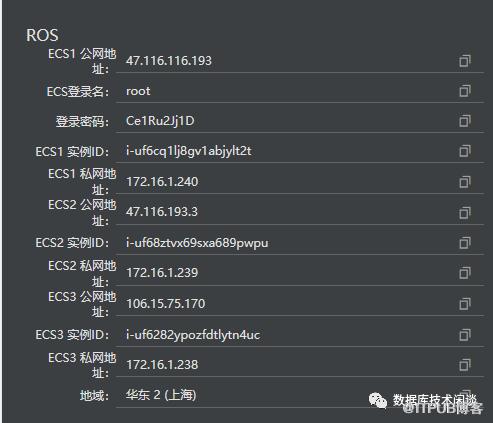
左边会显式部署环境。一共有 3台 ECS 服务器,从公网IP子网类型看是分属于两个地域的。3台ECS服务器都有公网 IP 和私网 IP ,登录第一台 ECS 做为跳板机同时也是 OB 其中一台服务器。注意后面部署 OB 集群使用私网 IP。三台服务器的root 密码都相同。
2. 部署环境
登录第一台ECS后,目录下有 t-oceanbase-antman 目录,下有一个 3ecs-3ob-cluster.yaml 文件。以及两个 RPM 包。
这里实验的虽然是企业版 OceanBase,但是不用 OCP 部署,也不用 Antman 工具部署(后来叫 OAT 命令行版本),而是使用 OceanBase 社区版提供的工具 OBD(OceanBase Deploy)部署。具体介绍可以参考社区官网文档。
OBD 支持在命令行下部署 OceanBase 集群,如果手动部署过 OceanBase 集群,就理解在 OceanBase 部署的过程中要创建很多目录,还要指定进程 observer 和 obproxy 的启动参数。自动化部署也需要指定这些参数,参数信息就写在 YAML 文件(3ecs-3ob-cluster.yaml)中。
自动化部署的思想就是从一台服务器出发(又叫中控机),SSH 到目标机器上执行相关操作。SSH 可以通过用户名密码连接,也可以提前打通 SSH 信任关系。这里我选择打通 SSH信任关系。
此时还要选择将 OB 进程部署在哪个用户下。企业版的部署工具都是部署在普通 OS 用户 admin 下(不要被名字迷惑,只是一个普通权限的用户)。OB 社区版工具和文档常常引导用户部署到了 root 用户下,生产不要这么做。这里我选择部署在 admin 用户下,所以后面这个 YAML 配置文件要修改。
这里先打通中控机到 OB 机器的 admin 用户信任关系。不过目标 ECS 上并没有 admin 用户,需要提前创建。下面批量操作,命令比较简单就不一一解释了。
IPS="172.16.1.238172.16.1.239172.16.1.240"ssh-keygen -t rsafor ip in $IPS;do echo $ip; ssh-copy-id $ip; donefor ip in $IPS;do echo $ip; ssh $ip "useradd admin && echo 'admin:admIN@123' | chpasswd"; donefor ip in $IPS;do echo $ip; ssh-copy-id admin@$ip; done
2.2 OBD 配置文件修改
你也可以不修改,直接修改原来配置文件中需要填写IP的部分。这里我对实验环境的配置文件做了一些简化。
user:username: adminport: 22oceanbase:servers:- name: ob1ip: 172.16.1.240- name: ob2ip: 172.16.1.239- name: ob3ip: 172.16.1.238global:devname: eth0cluster_id: 1memory_limit: 12Gsystem_memory: 3Gstack_size: 512Kcpu_count: 16cache_wash_threshold: 1G__min_full_resource_pool_memory: 268435456workers_per_cpu_quota: 10schema_history_expire_time: 1dnet_thread_count: 4major_freeze_duty_time: Disableminor_freeze_times: 10enable_separate_sys_clog: 0enable_merge_by_turn: FALSEdatafile_disk_percentage: 20syslog_level: INFOenable_syslog_wf: false # Print system logs whose levels are higher than WARNING to a separate log file. The default value is true.enable_syslog_recycle: true # Enable auto system log recycling or not. The default value is false.max_syslog_file_count: 4 # The maximum number of reserved log files before enabling auto recycling. The default value is 0.appname: obce_testmysql_port: 2881rpc_port: 2882data_dir: /data/home_path: /home/admin/oceanbase/ob1:zone: zone1ob2:zone: zone2ob3:zone: zone3obproxy:depends:- oceanbaseservers:- name: obproxy1ip: 172.16.1.240- name: obproxy2ip: 172.16.1.239- name: obproxy3ip: 172.16.1.238global:listen_port: 2883home_path: /home/admin/obproxy/
user 下的 那个 user 是错误的,改为 username。这个表示使用哪个用户 SSH 到目标节点并部署 OB 相关进程。前面解释了,建议用 admin。
密码我删掉了,不指定使用 SSH 信任关系登录。
oceanbase 和 obproxy 分别表示对应的配置信息,后者依赖前者的时候,rootservice list 信息、集群名称信息都可以自动获取,不需要指定。
oceanbase 和 obproxy 下多个节点的配置里相同的部分都可以写在 global 下,表示适用所有节点。不同的地方单独在某个节点下指定。
ECS 16G内存,分配给 OB 12G 内存(memory_limit),OB内部内存控制在 3GB(system_memory)。这里实验提供的参数就是小规格内存部署 OB 集群经常需要调整的参数。
这一步是可选的。对 OBD 感兴趣的可以看看。
OBD 是社区版的命令行部署工具,只要使用了OceanBas e的YUM 仓库文件就可以获取。
[root@iZuf6cq1lj8gv1abjylt2tZ t-oceanbase-antman]# rpm -qa|grep ob-deployob-deploy-1.3.x-1.el7.x86_64[root@iZuf6cq1lj8gv1abjylt2tZ t-oceanbase-antman]# yum list |grep ob-deployob-deploy.x86_64 1.3.x-1.el7 @/ob-deploy-1.3.x-1.el7.x86_64
OBD 使用会依赖本地一个隐藏目录 ~/.obd ,结构如下:
[root@iZuf6cq1lj8gv1abjylt2tZ ~]# tree .obd -L 2.obd├── cluster│ └── obce_test├── config_parser│ ├── oceanbase│ └── oceanbase-ce -> oceanbase├── lock│ ├── deploy_obce_test│ ├── global│ └── mirror_and_repo├── log│ ├── obd│ └── obd.2022-09-14├── mirror│ ├── local│ └── remote├── plugins│ ├── commands│ ├── general│ ├── mysqltest│ ├── obagent│ ├── ob-deploy│ ├── obproxy│ ├── obproxy-ce│ ├── oceanbase│ ├── oceanbase-ce -> oceanbase│ ├── oceanbase-ce-libs│ ├── sysbench│ ├── tpcc│ └── tpch├── repository│ ├── obproxy│ └── oceanbase└── version27 directories, 6 files[root@iZuf6cq1lj8gv1abjylt2tZ ~]# tree .obd/mirror/.obd/mirror/├── local│ ├── obproxy-3.2.4-20220824140950.el7.x86_64.rpm│ └── oceanbase-3.2.3.0-20220530152606.el7.x86_64.rpm└── remote└── OceanBase.repo
OBD 维护了一个本地的仓库和远程的仓库。本地的仓库放了部署相关的 RPM 包。这里是实验用 OB 3.2.3 和 OBProxy 3.2.4 版本。小版本的不一样可能会导致实验结果跟官网培训手册说的有点不一样。
OBD 默认禁用了远程的镜像仓库,所以它会认为这个 OBD 是最新的。实际上开启远程仓库就可以更新。
[root@iZuf6cq1lj8gv1abjylt2tZ t-oceanbase-antman]# obd mirror enable remoteEnable remote okTrace ID: 5314479a-7e0c-11ee-83fa-00163e286f75[root@iZuf6cq1lj8gv1abjylt2tZ t-oceanbase-antman]# obd updateUpdate OceanBase-community-stable-el7 okUpdate OceanBase-development-kit-el7 okDownload ob-deploy-2.3.1-2.el7.x86_64.rpm (59.60 M): 100% [######################################################################################################################################################################################] Time: 0:01:23 743.96 kB/sFound a higher version package for OBDname: ob-deployversion: 2.3.1release:2.el7arch: x86_64md5: b3957d4062626882527729564864125b168613b3Upgrade successful.Current version : 2.3.1Trace ID: 55ad10cc-7e0c-11ee-906f-00163e286f75
我测试了,更新后的 OBD 也是可以做这个实验的。不过,如果第一次做这个实验,这一步还是别做了,免得后面部署出意外。:)
2.4 OBD 部署相关目录
OBD 部署OB集群和 OBProxy 产品分为两步。第一步,创建相关目录并安装软件。第二步,启动进程。
obd cluster deploy obce_test -c 3ecs-3ob-cluster.yaml这一步很快就会返回,然后你可以查看 3个 OB 上的软件目录。我在 YAML 文件里修改了 OBProxy的目录,全部放到 /home/admin/ 下。
OBD 安装软件是对 RPM 软件包解压缩到指定目录,并不适用 rpm 安装命令。所以,普通用户 admin 不需要安装软件的权限。
如果调整了YAML 中的 username,则目录所有者都会是 admin.admin 。否则,就是 root.root 。
2.5 OB 初始化/启动集群
OBD 初始化集群的命令就是启动集群,第一次启动会初始化。命令如下:
[root@iZuf6cq1lj8gv1abjylt2tZ t-oceanbase-antman]# obd cluster start obce_testGet local repositories and plugins okOpen ssh connection okLoad cluster param plugin okCheck before start observer ok[WARN] OBD-2000: (172.16.1.240) not enough memory. (Free: 9.8G, Need: 12.0G)[WARN] (172.16.1.240) clog and data use the same disk (/)[WARN] OBD-2000: (172.16.1.239) not enough memory. (Free: 10.9G, Need: 12.0G)[WARN] (172.16.1.239) clog and data use the same disk (/)[WARN] OBD-2000: (172.16.1.238) not enough memory. (Free: 10.9G, Need: 12.0G)[WARN] (172.16.1.238) clog and data use the same disk (/)Check before start obproxy okStart observer okobserver program health check okConnect to observer okInitialize clusterCluster bootstrap okWait for observer init ok+------------------------------------------------+| observer |+--------------+---------+------+-------+--------+| ip | version | port | zone | status |+--------------+---------+------+-------+--------+| 172.16.1.238 | 3.2.3.0 | 2881 | zone3 | active || 172.16.1.239 | 3.2.3.0 | 2881 | zone2 | active || 172.16.1.240 | 3.2.3.0 | 2881 | zone1 | active |+--------------+---------+------+-------+--------+Start obproxy okobproxy program health check okConnect to obproxy okInitialize cluster+------------------------------------------------+| obproxy |+--------------+------+-----------------+--------+| ip | port | prometheus_port | status |+--------------+------+-----------------+--------+| 172.16.1.240 | 2883 | 2884 | active || 172.16.1.239 | 2883 | 2884 | active || 172.16.1.238 | 2883 | 2884 | active |+--------------+------+-----------------+--------+obce_test runningTrace ID: d6a63206-7e04-11ee-9a34-00163e286f75
最后一个 Trace ID 是用于查看部署日志的。如果部署报错的话,看日志。这是一个很好的设计,不过这里一般很顺利,用不上。命令如下:
obd display-trace d6a63206-7e04-11ee-9a34-00163e286f75
到这里 OB 集群和 OBProxy 就部署成功了。
OBD 命令也可以再次查看部署信息。命令是:
obd cluster listobd cluster display obce_test
2.6 OB 集群连接
如果你不喜欢命令行下发SQL,可以使用图形化客户端 DBeaver 或 ODC 。通过公网地址(第一台 ECS)连接这个 OB 集群即可。方法参考以前文章:《OceanBase 2.x体验:推荐用DBeaver工具连接数据库》。
如果是命令行下,后面因为要测试 OB的ORACLE租户,只能使用 obclient 工具。这个默认安装了。如果没有就 YUM 安装一下。
[root@server066 ~]$yum list |grep obclientobclient.x86_64 2.2.3-1.el7 @oceanbase.community.stablelibobclient.x86_64 2.2.3-1.el7 oceanbase.community.stable[root@server066 ~]$yum -y install obclient.x86_64
2.7 OB 租户初始化
select a.zone,concat(a.svr_ip,':',a.svr_port) observer, cpu_total, (cpu_total-cpu_assigned) cpu_free, round(mem_total/1024/1024/1024) mem_total_gb, round((mem_total-mem_assigned)/1024/1024/1024,2) mem_free_gb, round(disk_total/1024/1024/1024) disk_total_gb, round((disk_total-disk_assigned)/1024/1024/1024) disk_free_gbfrom __all_virtual_server_stat a join __all_server b on (a.svr_ip=b.svr_ip and a.svr_port=b.svr_port)order by a.zone, a.svr_ip;+-------+-------------------+-----------+----------+--------------+-------------+---------------+--------------+| zone | observer | cpu_total | cpu_free | mem_total_gb | mem_free_gb | disk_total_gb | disk_free_gb |+-------+-------------------+-----------+----------+--------------+-------------+---------------+--------------+| zone1 | 172.16.1.240:2882 | 14 | 11.5 | 9 | 6.75 | 38 | 0 || zone2 | 172.16.1.239:2882 | 14 | 11.5 | 9 | 6.75 | 38 | 0 || zone3 | 172.16.1.238:2882 | 14 | 11.5 | 9 | 6.75 | 38 | 0 |+-------+-------------------+-----------+----------+--------------+-------------+---------------+--------------+3 rows in set (0.012 sec)
查看资源分配细节。
select t1.name resource_pool_name, t2.`name` unit_config_name, t2.max_cpu, t2.min_cpu, round(t2.max_memory/1024/1024/1024) max_mem_gb, round(t2.min_memory/1024/1024/1024) min_mem_gb, round(t2.max_disk_size/1024/1024/1024) max_disk_size , t4.tenant_namefrom __all_resource_pool t1 join __all_unit_config t2 on (t1.unit_config_id=t2.unit_config_id)join __all_unit t3 on (t1.`resource_pool_id` = t3.`resource_pool_id`)left join __all_tenant t4 on (t1.tenant_id=t4.tenant_id)order by t1.`resource_pool_id`, t2.`unit_config_id`, t3.unit_id;+--------------------+------------------+---------+---------+------------+------------+---------------+-------------+| resource_pool_name | unit_config_name | max_cpu | min_cpu | max_mem_gb | min_mem_gb | max_disk_size | tenant_name |+--------------------+------------------+---------+---------+------------+------------+---------------+-------------+| sys_pool | sys_unit_config | 5 | 2.5 | 3 | 2 | 38 | sys || sys_pool | sys_unit_config | 5 | 2.5 | 3 | 2 | 38 | sys || sys_pool | sys_unit_config | 5 | 2.5 | 3 | 2 | 38 | sys |+--------------------+------------------+---------+---------+------------+------------+---------------+-------------+3 rows in set (0.008 sec)
create resource unit u1_ora max_cpu=4,min_cpu=4,max_memory='2G',min_memory='2G',max_iops=128,max_disk_size='10G',max_session_num=100;create resource pool pool_ora unit='u1_ora',unit_num=1,zone_list=('zone1','zone2','zone3');CREATE TENANT IF NOT EXISTS ob_pay charset='utf8mb4', replica_num=1,zone_list=('zone1','zone2','zone3'), resource_pool_list=('pool_ora') SET ob_tcp_invited_nodes='%', ob_compatibility_mode='oracle';
alter proxyconfig set query_digest_time_threshold='100us';使用 obclient 登录租户 创建用户和修改内存参数(可选)。
obclient -h172.16.1.240 -usys@ob_pay#obce_test -P2883 -p -c -AEnter password:create user tpcc identified by obce_test;grant dba to tpcc;alter system set writing_throttling_trigger_percentage=90;
切换到用户 TPCC 再次登录这个租户,创建测试表和数据。
create table tab1 (c1 int primary key, c2 int, c3 varchar(10)) partition by hash(c1) partitions 10;create table tab2 (c1 int primary key, c2 int, c3 varchar(10)) partition by hash(c1) partitions 10;create table tab3 (d1 int primary key, d2 int) partition by list (d1)(partition p0 values(1,2,3,4,5),partition p1 values(6,7,8,9,10),partition p2 values (11,12,13,14,15));insert into tab1 select level, mod(level,10),'003' from dual connect by level<=150;insert into tab2 select level, mod(level,5),'004' from dual connect by level<=150;insert into tab3 select level, mod(level,3) from dual connect by level<=15;commit;
表 tab1和tab2 分区策略相同,表tab3分区策略不同。
2.9 查看表分区位置
SELECT t5.tenant_name, t5.primary_zone tnt_primary_zone, t4.database_name, t4.primary_zone db_primary_zone, t3.tablegroup_name, t3.primary_zone tg_primary_zone, conv(t1.table_id, 10, 16) table_id, t1.primary_zone , t1.table_name, t2.partition_id, t2.role, t2.zone, concat(t2.svr_ip, ':', t2.svr_port) observer, round(t2.data_size / 1024 / 1024) data_size_mb, t2. row_countFROM gv$table t1JOIN gv$partition t2 ON(t1.tenant_id = t2.tenant_idAND t1.table_id = t2.table_id)LEFT JOIN __all_virtual_tablegroup t3 ON(t1.tenant_id = t3.tenant_idAND t1.tablegroup_id = t3.tablegroup_id)JOIN gv$database t4 ON(t1.tenant_Id = t4.tenant_idAND t1.database_id = t4.database_id)JOIN gv$tenant t5 ON(t1.tenant_id = t5.tenant_id)WHERE t5.tenant_id = 1005-- AND t2.role = 1AND t4.database_name = 'TPCC'AND t1.table_name LIKE 'TAB%'ORDER BYt5.tenant_name, t4.database_name, t3.tablegroup_name, t2.partition_id;
测试实验时忘记这一步截图了,下面是内部测试环境的截图。
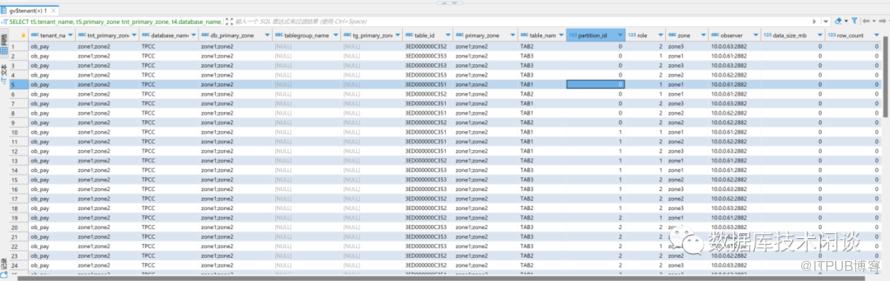
看 observer 列,三个表各个分区主副本位置完全随机。
测试分三组。第一组,默认情况下看SQL性能。第二组,通过表分组调整表分区的主副本位置看SQL性能。第三组,关闭只读SQL的事务功能看SQL性能。
3.1 数据随机分布场景测试
测试 SQL 很简单,很理想。有一定业务代表性。
select c1,c2 from tab1 where c1=10;select c1,c2 from tab2 where c1=10;update tab3 set d2=2 where d1=10;commit;select c1,c2 from tab1 where c1=11;select c1,c2 from tab2 where c1=11;update tab3 set d2=3 where d1=11;commit;
实验手册里有一部分是 tcpdump 抓包。这个照着手册做就行。这里不展示了。
直接通过 SQL 审计视图查看上面SQL执行性能信息。
SELECT svr_ip, query_sql, sql_id, plan_id, trace_id, rpc_count, plan_type, is_hit_plan, elapsed_time, execute_time, get_plan_timeFROM gv$sql_auditWHERE query_sql LIKE '%TAB1%'OR query_sql LIKE '%TAB2%'OR query_sql LIKE '%TAB3%'AND tenant_id = 1001AND user_name = 'tpcc'ORDER BY request_time;
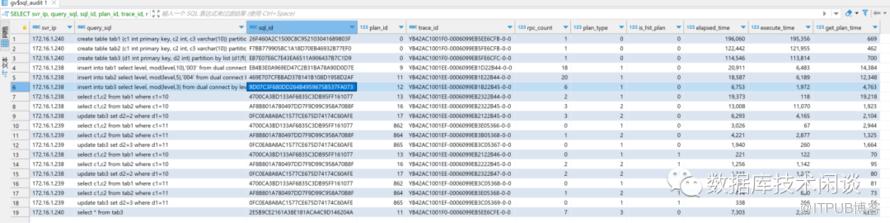
这个结果里展示了上面SQL的路由节点(也是执行节点,看 svr_ip)类型(plan_type)和总体时间(elapsed_time)。用于后面对比。
可以看出,我跑了多次(中间跑完后断开过 obclient 会话),每个事务都被路由到同一个节点执行。并且有的select是远程sql(plan_type=2)。
3.2 使用表分组优化表数据分区的主副本位置
下面开始使用表分组技术。
create tablegroup tab_group partition by hash partitions 10;alter table tab1 tablegroup tab_group;alter table tab2 tablegroup tab_group;
表分组用上后,等个十几秒。再查看各个分区主副本的位置。
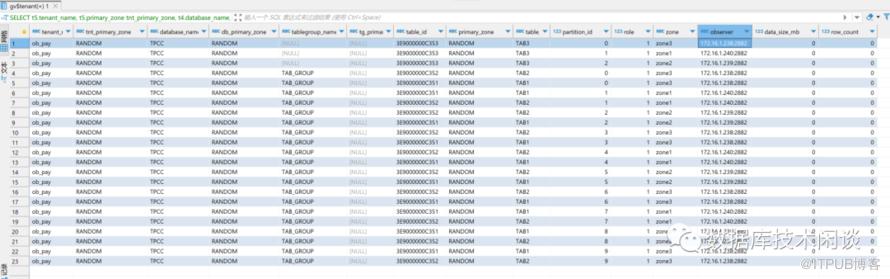
可以看出 TAB3 位置不会变。TAB1和TAB2的同号分区(partition_id)的主副本位置都在同一个节点(observer)。
然后再跑测试SQL,查看SQL审计试图。
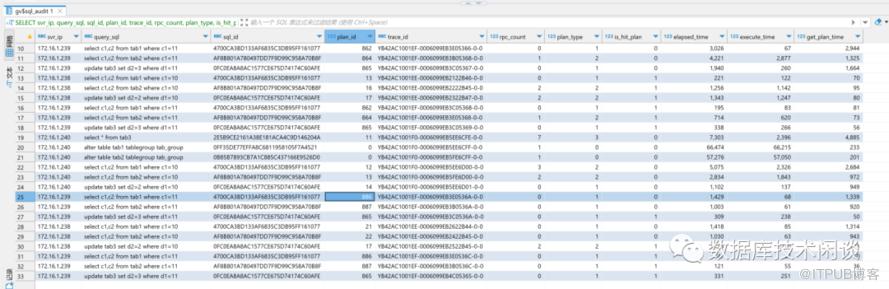
前后两次对比也很明显,后面每个事务SQL路由依然在同一个给节点,但是 tab1 和 tab2 的 SQL 都是本地 SQL(plan_type=1) , tab3 还是远程 SQL。执行时间也比前面快了一些(注意,跑两次后第二次select明显都比第一次快,这是缓存原因)。此外,还要注意由于测试数据量特别小,所以提升也不是那么大。重点看 SQL 类型,执行时间不要过于较真。
3.3 关闭只读SQL事务功能
上面测试结果里看出查询语句(select)其实是开启了事务功能,所以跟后面DML的路由节点都一致。这一步关闭只读查询SQL事务功能。
alter system set ob_proxy_readonly_transaction_routing_policy=false tenant=ob_pay;
重新跑测试 SQL,然后看 SQL 审计视图。
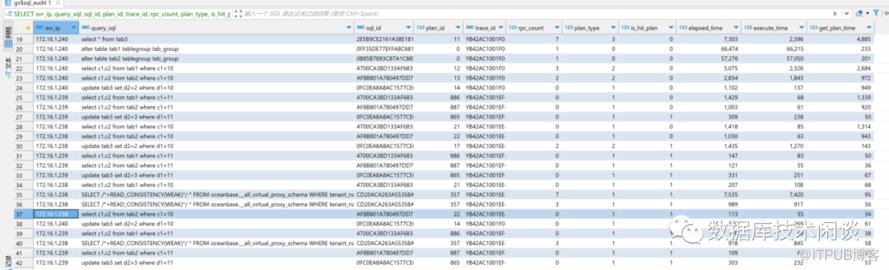
可以看出,每个事务的只读 SQL 的 SQL 类型都是本地 SQL(plan_type=1),因为它们都独立路由了,TAB3 的 update 也是本地 SQL,因为它开启了事务,是事务的第一句SQL,所以路由后SQL类型肯定是本地 SQL。
4. 总结
这个实验很简单,却总结了 OB 业务 SQL 优化的关键方法。
实际项目中,传统业务数据库从 ORACLE 平迁到 OB 后,性能大概率是比ORACLE 要差很多,因为缺乏优化。优化的思路就是本实验展示的。
以金融行业核心交易延时优化为例。从ORACLE 平迁到 OB 后,首先要通过SQL审计抓取业务核心交易的事务的SQL。业务上可能存在在十几种事务场景(SQL不同),挑比例最多的几个事务开始分析。分析事务开始的第一句SQL,如果它是查询(大概率是),再分析第一句 DML 等。关闭只读查询SQL的事务功能,可以优化一部分性能。此外看各个SQL的查询和更新条件。看核心表是否可以找出共同的分区字段。传统金融业务设计往往很混乱,查询更新标识一个用户的有多种ID,每个地方还不一样,这就需要尽量统一。统一到某个ID上,这个ID就是水平拆分的最佳选择。表分组也按这个ID分区。这种优化需要投入大量的精力,但却是值得的。这也是为什么OB的金融核心案例很多客户的交易事务演示能缩短到几百毫秒的原因。
参考
原文作者:数据库技术闲谈;如有侵权,请联系管理员删除。

