1.1 SQL 解析和绑定变量
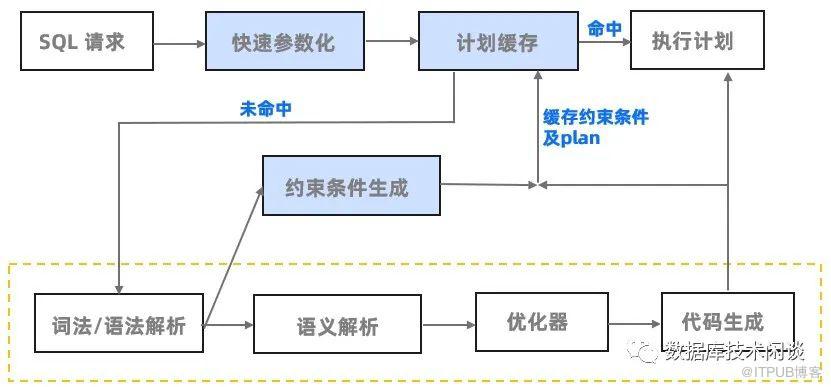
SELECT * FROM T1 WHERE c1 = 5 AND c2 ='oceanbase';上面 SQL 会被替换为
SELECT * FROM T1 WHERE c1 = ? AND c2 = ?;快速参数化也不是简单的进行字符常量文本替换,有些常量是不能替换的。如 SELECT 投射字段里的常量、一些字符串函数里的常量、ORDER BY 后的常量等等,官网文档有详细介绍。根据 ORACLE SQL 绑定变量相关的使用经验,不难想到 OB SQL 快速参数化有利有弊,推测 OB 优化器后面也要实现类似 ORACLE cursor_sharing 的 SIMILAR 类似的功能,在完全参数化和完全不参数化之间取一个平衡。OB 后面版本 SQL 优化器也有 Adaptive Cursor Sharing(ACS) 技术支持一个 SQL_ID 存储多个版本的执行计划。此外,OB SQL 优化器也在发展“执行反馈”功能,当实际执行时间或返回行数等跟执行计划预估的差异很大时,会重新解析一次生成新的执行计划。当然,有一定概率新的执行计划也不是很好。OB 优化器还支持大纲绑定(OUTLINE)执行计划的功能。
1.3 OB SQL 大纲(OUTLINE)
OUTLINE 曾是 ORACLE SQL 引擎一个非常实用的功能,在 SQL 走错执行计划时可以在线通过 OUTLINE 调整 SQL 的执行计划,可以立即生效。OUTLINE 是针对 SQL 设置的。ORACLE 19C 有更新的技术,OUTLINE 逐渐被废弃。OB 2.2 就实现了 OUTLINE,在统计信息功能并不很完善的情况下,OUTLINE 对于解决线上 SQL 执行计划走偏问题有非常大的作用。
就 OB OUTLINE 概念理解,个人认为是执行计划中关于 查询块及其扫描算法、连接顺序、使用的索引以及其他影响执行计划的 HINT 信息等。大纲的格式比较特殊。如下面是一个全表扫描的大纲数据。
/*+ BEGIN_OUTLINE_DATA FULL(@"SEL$1" "TPCC100.BMSQL_OORDER"@"SEL$1") END_OUTLINE_DATA*/每个 SQL 的执行计划都对应着一个OUTLINE 数据,OUTLINE 干预 SQL 执行计划的原理就是替换这个执行计划的 OUTLINE 数据。
2.1 实验准备说明
第五章实验的第二部分首先是准备两个表数据(一个小表 table_small 和一个大表 table_big)。数据导入使用 obload 命令,这次就不介绍了。测试数据文件(csv)我也备份了一份,有需要的可以给我留言。
表结构如下:
CREATE TABLE "TABLE_SMALL" ("ACCT_NUM" VARCHAR2(40) NOT NULL ,"ACCT_CODE" VARCHAR2(10) NOT NULL ,"TXN_DATE" VARCHAR2(8) NOT NULL ,"TXN_ORG" VARCHAR2(3) DEFAULT '1' NOT NULL ,"TXN_EMP" VARCHAR2(10) DEFAULT NULL,CONSTRAINT "TABLE_SMALL_OBPK_1660880212108693" PRIMARY KEY ("ACCT_NUM", "ACCT_CODE")) partition by hash(ACCT_NUM) PARTITIONS 3;CREATE TABLE "TABLE_BIG" ("ACCT_NUM" VARCHAR2(40) NOT NULL ENABLE,"ACCT_CODE" VARCHAR2(10) NOT NULL ENABLE,"ACCT_OPEN_ORG" VARCHAR2(3) NOT NULL ENABLE,"TXN_DATE" VARCHAR2(8) NOT NULL ENABLE,"CASH_FLAG" CHAR(1) NOT NULL ENABLE,"TXN_AMT" NUMBER(20,2) NOT NULL ENABLE,"TXN_STAT" VARCHAR2(1) DEFAULT '1' NOT NULL ENABLE,"TXN_DETAIL" VARCHAR2(1000) DEFAULT NULL,CONSTRAINT "TABLE_BIG_OBPK_1660877810895937" PRIMARY KEY ("ACCT_NUM", "ACCT_CODE", "ACCT_OPEN_ORG")) partition by hash(ACCT_NUM) PARTITIONS 3;
然后跑三个 SQL 脚本。先了解这三个脚本的设计目的对做实验有帮助。
run1.sql : 两个业务逻辑相同的 SQL,只是条件中的值不同。第一个 SQL 预期很快,但是第二个 SQL 复用了第一个 SQL 执行计划变得很慢(报执行超时 -4012 错误)。收集表的统计信息后重跑这个案例,结果依然一样。 run2.sql :三个业务逻辑相同的 SQL,前面两个 SQL跟 run1.sql 一样,第三个 SQL 就是第二个 SQL重复执行,利用执行反馈功能,重新生成一次执行计划(这次更好),第三个 SQL 执行成功。 run3.sql:两个业务逻辑相同的 SQL,就是 run1.sql 里两条 SQL 顺序对调一下。同样第二个 SQL 复用了第一个 SQL 的执行计划,跟 run1.sql 不一样,这次执行计划对二者都很友好。可以姑且理解为这个执行计划是期望的执行计划。然后用 SQL OUTLINE 技术绑定这个执行计划到这个 SQL 上,然后重跑 run1.sql 观察效果。
set ob_query_timeout=60000000;alter system flush plan cache global;select 'Query 1' as Query, to_char(systimestamp,'hh24:mi:ss:ff') as start_time from dual;select /*+ obce_test */ *from ( select row_.*, rownum rownum_from ( select m.acct_num,acct_code,m.txn_date,txn_amtfrom table_big mjoin ( select a.acct_num, a.txn_datefrom table_big ajoin table_small bon (a.acct_num = b.acct_num)where a.cash_flag = 'U'and a.txn_amt != 0and a.txn_stat = '0'and a.txn_date>= '20221231'and a.txn_date<= '20221231'group by a.acct_num, a.txn_date) non ( m.acct_num = n.acct_numand m.txn_date= n.txn_date)where m.cash_flag = 'U'and m.txn_stat = '0'and m.txn_amt != 0) row_where rownum <= 100)where rownum_ > 0;select 'Query 1' as Query, to_char(systimestamp,'hh24:mi:ss:ff') as end_time from dual;select 'Query 2' as Query, to_char(systimestamp,'hh24:mi:ss:ff') as start_time from dual;select /*+ obce_test */ *from ( select row_.*, rownum rownum_from ( select m.acct_num,acct_code,m.txn_date,txn_amtfrom table_big mjoin ( select a.acct_num, a.txn_datefrom table_big ajoin table_small bon (a.acct_num = b.acct_num)where a.cash_flag = 'U'and a.txn_amt != 0and a.txn_stat = '0'and a.txn_date>= '20220601'and a.txn_date<= '20220630'group by a.acct_num, a.txn_date) non ( m.acct_num = n.acct_numand m.txn_date= n.txn_date)where m.cash_flag = 'C'and m.txn_stat = '1'and m.txn_amt != 0) row_where rownum <= 100)where rownum_ > 0;select 'Query 2' as Query, to_char(systimestamp,'hh24:mi:ss:ff') as end_time from dual;
为了避免 SQL 执行计划里内容太多,我对 SQL脚本做了两点修改。一是将最内层的 * 替换为具体的三个列(不完全在索引列和主键列,保持回表)。而是加了 HINT /*+ obce_test */ 方便在 SQL审计视图里定位 SQL 执行计划。
修改时 SQL 脚本时需要特别注意,三个脚本里的所有 SQL 除了条件列的具体值不一样,其他就严格一样(包括空格、换行、注释 HINT 等);否则,可能得出错误的结论。
2.2 SQL 相关视图用法
OB 3.2 版本测试过下面这些视图在业务租户里都有。如果你的 OB 版本里没有就到 SYS 租户下 oceanbase 下查看。
从 SQL 审计视图里定位 SQL 如下:
SELECT usec_to_time(request_time) req_time, svr_ip, svr_port, sql_id,plan_id, is_hit_plan, client_ip, user_client_ip, tenant_name, user_name, db_name, query_sql, ret_code, plan_type, request_type, elapsed_time, execute_time, queue_time, affected_rows, return_rows, partition_cnt, eventFROM gv$sql_auditWHERE tenant_id = 1003AND is_inner_sql = 0AND request_type IN (2)AND user_name IN ('TPCC')AND query_sql LIKE '%obce_test%'ORDER BY request_time DESCLIMIT 3;
SQL 审计视图主要是拿到查看 SQL 实际执行计划的4元组信息(tenant_id,svr_ip, svr_port,plan_id)。额外的有用信息还有 sql_id(SQL唯一标识)、plan_type(执行计划类型:本地、远程、分布式)、ret_code(报错信息:0、负值)、elapsed_time(执行时间) 。拿到 4 元组信息后就可以到视图 gv$plan_cache_plan_explain 查看 SQL 实际执行计划。这个视图的访问条件非常严格,必须提供这 4 个 条件,且必须是等值条件;否则返回记录数为空。这个要注意。
示例SQL 如下。
SELECT plan_depth depth, plan_line_id line_id, operator,name,ROWS,cost,propertyFROM gv$plan_cache_plan_explainWHERE tenant_id=1003 AND ip = '10.0.0.61' AND port=2882 AND plan_id = 58007 ;
通过 SQL_ID 还可以到视图 gv$plan_cache_plan_stat 里查看执行计划的详情。如 query_sql (生成执行计划的原始 SQL)、statement(参数化的 SQL)、plan_type(执行计划类型)、hit_count(执行计划命中次数)等等。
(TPCC@10.0.0.63:2883) [TPCC]> SELECT tenant_id, svr_ip, svr_port,plan_id,sql_id,TYPE,STATEMENT,query_sql FROM gv$plan_cache_plan_stat WHERE tenant_id=1003 AND sql_id='FC3FED8CCB2946DE54F1C5BA3656023C'\G*************************** 1. row ***************************TENANT_ID: 1003SVR_IP: 10.0.0.61SVR_PORT: 2882PLAN_ID: 64742SQL_ID: FC3FED8CCB2946DE54F1C5BA3656023CTYPE: 1STATEMENT: SELECT d_tax, d_next_o_id FROM bmsql_district WHERE d_w_id = ? AND d_id = ? FOR UPDATEQUERY_SQL: SELECT d_tax, d_next_o_id FROM bmsql_district WHERE d_w_id = 2 AND d_id = 6 FOR UPDATE1 row in set (0.191 sec)
这里 QUERY_SQL 就是生成这条执行计划时的原始 SQL,它会决定这个执行计划的细节,也决定了这个 SQL 的执行性能。或者说就是这个 SQL 将这个执行计划引导到了一个好的或坏的方向。
2.3 其他影响测试结论的因素
如果从集群的安装 部署、租户的创建,严格安装实验手册步骤,应该能跟手册里的结论一致。如果是在自己的测试环境,还有一些因素会影响测试结论。
如租户必须是三副本架构,并且 PRIMARY_ZONE 是两个或三个 ZONE 。这是由于实验用的两个表都是分区表(3分区),租户 PRIMARY_ZONE 设置为多个 ZONE,分区表的分区的主副本就可以分散在不同的节点上,测试的 SQL 实际执行就会跨节点,执行计划里会有远程数据发送和接收相关的算子。这个会体现在优化器评估执行计划的成本里。此外两个表的同号分区主副本是否在一个节点上,对结果影响也很大。这个以前的文章介绍过。
此外,分区表多分区,优化器也会启用 PX 在多个分区间并行扫描,如果在 SQL 注释里禁用掉了 PX (HINT: /*+ use_no_px */ ,执行计划更可能会因为多个分区主副本位置原因发生变化。
测试中有时候看的是实际执行计划,有时候看的是静态解析执行计划(指 EXPLAIN)。实际执行计划可能跟解析执行计划相同,也可能不同。在 OB 里不同的可能性还高一些(快速参数化 加上条件列值数据倾斜严重的原因)。看解析执行计划通常是为了看到我们预期的执行计划,看实际执行计划是为了看实际执行性能好或坏的原因。解析执行计划的格式比实际执行计划可读性稍微好一些(体现在算子的名称上)。
测试数据构造后,默认是没有收集统计信息的。也不要合并(可以多转储几轮),所以也不会自动收集统计信息。大表上有个索引,存储层会默认收集索引第一列(txt_date)的统计信息,这个会在执行计划生成中起作用。这列条件的不同,也会导致解析执行计划不同。
2.4 SQL 实验 RUN1
在 obclient 里连接 ORACLE 租户,执行 source run1.sql 就是执行 SQL 脚本。
预期的是:第一个 SQL 很快,第二个 SQL 超时。
然后查看实际 SQL 审计视图。记录如下,根据执行时间到排序,取前三笔。
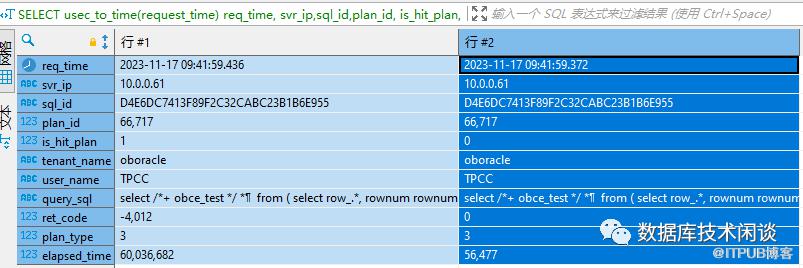
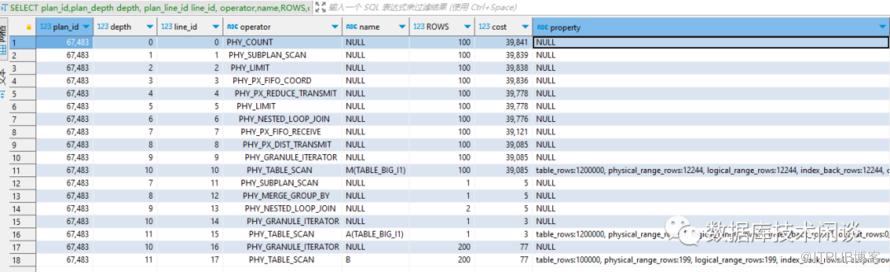
行 #2 先执行,没有命中缓存(is_hit_plan=0,因为缓存被清空了),所以自己生成执行计划(4元组:1003,10.0.0.61,2882,66086)。查看实际执行计划如下。
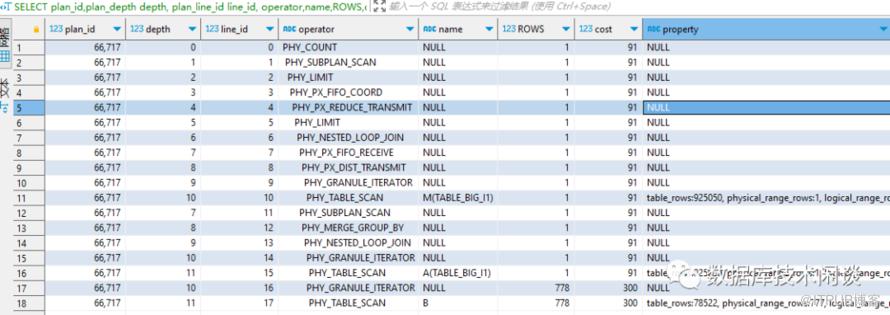
这个 SQL 就是三表连接,其中两个表先连接,然后再跟第三个表连接。执行计划应该很简单,在 OB 里看得有点复杂,主要是分布式架构下有并行扫描、有跨节点执行等。上面的执行计划简单说就是 A(TABLE_BIG)跟B(TABLE_SMALL) 用 NESTED-LOOP 做表连接,然后结果再跟 M(TABLE_BIG)用 NESTED-LOOP 做表连接,M 是驱动表。第 10 行算子认为 M 返回记录是 1 笔。这是 Query1 里A(TABLE_BIG) 上条件 txn_date 是等值条件, 优化器做了改写,将这个条件也应用到 M(TABLE_BIG)上,选了索引(TABLE_BIG_I1),估算行数是 1。所以选择了 M 作为嵌套循环的驱动表。但是到 Query2 复用了这个执行计划就变得很糟糕,因为 M 返回的行数非常的多(使用 M 的过滤条件计算),SQL 整体执行性能急剧下降,也就难怪超时了。
关于 M 返回行数的估算这里是用到了存储引擎上关于索引(TABLE_BIG_1)的列(txn_date)的 统计信息,直接就判断出 Query1 的 A 的时间过滤条件值不存在(所以返回行估算为 1)。此时,即使对表收集统计信息(包括所有列的直方图信息)也没有改变结果。不过收集统计信息后可以单独看看 Query2 的执行计划预期。
==========================================================================|ID|OPERATOR |NAME |EST. ROWS|COST |--------------------------------------------------------------------------|0 |COUNT | |26 |395554||1 | SUBPLAN SCAN |VIEW1 |26 |395553||2 | LIMIT | |26 |395553||3 | PX COORDINATOR | |26 |395553||4 | EXCHANGE OUT DISTR |:EX10001 |26 |395538||5 | LIMIT | |26 |395538||6 | NESTED-LOOP JOIN | |26 |395537||7 | EXCHANGE IN DISTR | |26 |364100||8 | EXCHANGE OUT DISTR (BC2HOST)|:EX10000 |26 |364091||9 | PX PARTITION ITERATOR | |26 |364091||10| TABLE SCAN |M |26 |364091||11| SUBPLAN SCAN |N |1 |1233 ||12| MERGE GROUP BY | |1 |1233 ||13| NESTED-LOOP JOIN | |2 |1233 ||14| PX PARTITION ITERATOR | |1 |1232 ||15| TABLE SCAN |A(TABLE_BIG_I1)|1 |1232 ||16| PX PARTITION ITERATOR | |778 |301 ||17| TABLE SCAN |B |778 |301 |==========================================================================Outputs & filters:-------------------------------------0 - output([VIEW1.ROW_.ACCT_NUM(0x7fcb248d4340)], [VIEW1.ROW_.ACCT_CODE(0x7fcb248d4640)], [VIEW1.ROW_.TXN_DATE(0x7fcb248d4940)], [VIEW1.ROW_.TXN_AMT(0x7fcb248d4c40)], [rownum()(0x7fcb248c2850) + ?(0x7fcb24761300)]), filter(nil)1 - output([VIEW1.ROW_.ACCT_NUM(0x7fcb248d4340)], [VIEW1.ROW_.ACCT_CODE(0x7fcb248d4640)], [VIEW1.ROW_.TXN_DATE(0x7fcb248d4940)], [VIEW1.ROW_.TXN_AMT(0x7fcb248d4c40)]), filter(nil),access([VIEW1.ROW_.ACCT_NUM(0x7fcb248d4340)], [VIEW1.ROW_.ACCT_CODE(0x7fcb248d4640)], [VIEW1.ROW_.TXN_DATE(0x7fcb248d4940)], [VIEW1.ROW_.TXN_AMT(0x7fcb248d4c40)])2 - output([M.ACCT_NUM(0x7fcb602b2680)], [M.ACCT_CODE(0x7fcb602b7fa0)], [M.TXN_DATE(0x7fcb602b2ce0)], [M.TXN_AMT(0x7fcb602b7c70)]), filter(nil), limit(?), offset(?)3 - output([M.ACCT_NUM(0x7fcb602b2680)], [M.ACCT_CODE(0x7fcb602b7fa0)], [M.TXN_DATE(0x7fcb602b2ce0)], [M.TXN_AMT(0x7fcb602b7c70)]), filter(nil)4 - output([M.ACCT_NUM(0x7fcb602b2680)], [M.ACCT_CODE(0x7fcb602b7fa0)], [M.TXN_DATE(0x7fcb602b2ce0)], [M.TXN_AMT(0x7fcb602b7c70)]), filter(nil), dop=15 - output([M.ACCT_NUM(0x7fcb602b2680)], [M.ACCT_CODE(0x7fcb602b7fa0)], [M.TXN_DATE(0x7fcb602b2ce0)], [M.TXN_AMT(0x7fcb602b7c70)]), filter(nil), limit(cast(cast(?, NUMBER(-1, -1))(0x7fcb24939ec0) + cast(?, NUMBER(-1, -1))(0x7fcb2493a9e0)(0x7fcb24939610), BIGINT(-1, 0))(0x7fcb2493b650)), offset(nil)6 - output([M.ACCT_NUM(0x7fcb602b2680)], [M.ACCT_CODE(0x7fcb602b7fa0)], [M.TXN_DATE(0x7fcb602b2ce0)], [M.TXN_AMT(0x7fcb602b7c70)]), filter(nil),conds(nil), nl_params_([M.ACCT_NUM(0x7fcb602b2680)], [M.TXN_DATE(0x7fcb602b2ce0)]), batch_join=false7 - output([M.ACCT_NUM(0x7fcb602b2680)], [M.TXN_DATE(0x7fcb602b2ce0)], [M.TXN_AMT(0x7fcb602b7c70)], [M.ACCT_CODE(0x7fcb602b7fa0)]), filter(nil)8 - output([M.ACCT_NUM(0x7fcb602b2680)], [M.TXN_DATE(0x7fcb602b2ce0)], [M.TXN_AMT(0x7fcb602b7c70)], [M.ACCT_CODE(0x7fcb602b7fa0)]), filter(nil), dop=19 - output([M.ACCT_NUM(0x7fcb602b2680)], [M.TXN_DATE(0x7fcb602b2ce0)], [M.TXN_AMT(0x7fcb602b7c70)], [M.ACCT_CODE(0x7fcb602b7fa0)]), filter(nil),force partition granule.10 - output([M.ACCT_NUM(0x7fcb602b2680)], [M.TXN_DATE(0x7fcb602b2ce0)], [M.TXN_AMT(0x7fcb602b7c70)], [M.ACCT_CODE(0x7fcb602b7fa0)]), filter([M.TXN_STAT(0x7fcb602b3670) = ?(0x7fcb602b8cd0)], [M.CASH_FLAG(0x7fcb602b3340) = 'C'(0x7fcb602bb6b0)], [M.TXN_DATE(0x7fcb602b2ce0) <= ?(0x7fcb602ba5f0)], [M.TXN_DATE(0x7fcb602b2ce0) >= ?(0x7fcb602bae50)], [M.TXN_AMT(0x7fcb602b7c70) != 0(0x7fcb602bc1a0)]),access([M.ACCT_NUM(0x7fcb602b2680)], [M.TXN_DATE(0x7fcb602b2ce0)], [M.CASH_FLAG(0x7fcb602b3340)], [M.TXN_STAT(0x7fcb602b3670)], [M.TXN_AMT(0x7fcb602b7c70)], [M.ACCT_CODE(0x7fcb602b7fa0)]), partitions(p[0-2]),is_index_back=false, filter_before_indexback[false,false,false,false,false],range_key([M.ACCT_NUM(0x7fcb602b2680)], [M.ACCT_CODE(0x7fcb602b7fa0)], [M.ACCT_OPEN_ORG(0x7fcb602ea7f0)]), range(MIN,MIN,MIN ; MAX,MAX,MAX)always true11 - output([remove_const(1)(0x7fcbfcebce50)]), filter(nil),access([N.ACCT_NUM(0x7fcb602b29b0)], [N.TXN_DATE(0x7fcb602b3010)])12 - output([A.ACCT_NUM(0x7fcbfcd813e0)], [A.TXN_DATE(0x7fcbfcd866a0)]), filter(nil),group(nil), agg_func(nil)13 - output([A.ACCT_NUM(0x7fcbfcd813e0)], [A.TXN_DATE(0x7fcbfcd866a0)]), filter(nil),conds(nil), nl_params_([A.ACCT_NUM(0x7fcbfcd813e0)]), batch_join=false14 - output([A.ACCT_NUM(0x7fcbfcd813e0)], [A.TXN_DATE(0x7fcbfcd866a0)]), filter(nil),access all, force partition granule.15 - output([A.ACCT_NUM(0x7fcbfcd813e0)], [A.TXN_DATE(0x7fcbfcd866a0)]), filter([A.CASH_FLAG(0x7fcbfcd81a40) = 'U'(0x7fcbfcd869d0)], [A.TXN_STAT(0x7fcbfcd820a0) = ?(0x7fcbfcd874c0)], [A.TXN_AMT(0x7fcbfcd81d70) != 0(0x7fcbfcd89640)]),access([A.ACCT_NUM(0x7fcbfcd813e0)], [A.CASH_FLAG(0x7fcbfcd81a40)], [A.TXN_AMT(0x7fcbfcd81d70)], [A.TXN_STAT(0x7fcbfcd820a0)], [A.TXN_DATE(0x7fcbfcd866a0)]), partitions(p[0-2]),is_index_back=true, filter_before_indexback[false,false,false],range_key([A.TXN_DATE(0x7fcbfcd866a0)], [A.ACCT_NUM(0x7fcbfcd813e0)], [A.ACCT_CODE(0x7fcbfcdfff10)], [A.ACCT_OPEN_ORG(0x7fcbfce00210)]), range(20220601,MIN,MIN,MIN ; 20220630,MAX,MAX,MAX),range_cond([A.TXN_DATE(0x7fcbfcd866a0) >= ?(0x7fcbfcd87d20)], [A.TXN_DATE(0x7fcbfcd866a0) <= ?(0x7fcbfcd88580)], [? = A.ACCT_NUM(0x7fcbfcd813e0)(0x7fcbfcd8b190)], [? = A.TXN_DATE(0x7fcbfcd866a0)(0x7fcbfcdd11d0)])16 - output([remove_const(1)(0x7fcbfcebd6a0)]), filter(nil),access all, param down, force partition granule.17 - output([remove_const(1)(0x7fcbfcebdef0)]), filter(nil),access([B.ACCT_NUM(0x7fcbfcd81710)]), partitions(p[0-2]),is_index_back=false,range_key([B.ACCT_NUM(0x7fcbfcd81710)], [B.ACCT_CODE(0x7fcbfce1acf0)]), range(MIN ; MAX),range_cond([? = B.ACCT_NUM(0x7fcbfcd81710)(0x7fcbfce2ab90)])Outline Data:-------------------------------------/*+BEGIN_OUTLINE_DATALEADING(@"SEL$5" ("TPCC.M"@"SEL$5" "N"@"SEL$5" ))USE_NL(@"SEL$5" ("N"@"SEL$5" ))PQ_DISTRIBUTE(@"SEL$5" ("N"@"SEL$5" ) BC2HOST NONE)NO_USE_NL_MATERIALIZATION(@"SEL$5" ("N"@"SEL$5" ))FULL(@"SEL$5" "TPCC.M"@"SEL$5")NO_USE_HASH_AGGREGATION(@"SEL$4")LEADING(@"SEL$4" ("TPCC.A"@"SEL$4" "TPCC.B"@"SEL$4" ))USE_NL(@"SEL$4" ("TPCC.B"@"SEL$4" ))PQ_DISTRIBUTE(@"SEL$4" ("TPCC.B"@"SEL$4" ) NONE NONE)NO_USE_NL_MATERIALIZATION(@"SEL$4" ("TPCC.B"@"SEL$4" ))INDEX(@"SEL$4" "TPCC.A"@"SEL$4" "TABLE_BIG_I1")FULL(@"SEL$4" "TPCC.B"@"SEL$4")END_OUTLINE_DATA*/Plan Type:-------------------------------------DISTRIBUTEDOptimization Info:-------------------------------------M:table_rows:925050, physical_range_rows:925200, logical_range_rows:925050, index_back_rows:0, output_rows:4, est_method:local_storage, optimization_method=cost_based, avaiable_index_name[TABLE_BIG_I1,TABLE_BIG], estimation info[table_id:1102810162710170, (table_type:1, version:0-1700157610566946-1700157610566946, logical_rc:0, physical_rc:0), (table_type:7, version:1700157610566946-1700183444412118-1700185215592957, logical_rc:308350, physical_rc:308400), (table_type:5, version:1700185171176689-1700185171176689-1700185215592957, logical_rc:0, physical_rc:0), (table_type:0, version:1700185215592957-1700185215592957-9223372036854775807, logical_rc:0, physical_rc:0)]A:table_rows:925050, physical_range_rows:25, logical_range_rows:25, index_back_rows:25, output_rows:0, est_method:local_storage, optimization_method=cost_based, avaiable_index_name[TABLE_BIG_I1,TABLE_BIG], estimation info[table_id:1102810162710171, (table_type:1, version:0-1700184921278565-1700184921278565, logical_rc:0, physical_rc:0), (table_type:7, version:1700157610566946-1700183444412118-1700185215592957, logical_rc:88394, physical_rc:88394), (table_type:5, version:1700185171176689-1700185171176689-1700185215592957, logical_rc:0, physical_rc:0), (table_type:0, version:1700185215592957-1700185215592957-9223372036854775807, logical_rc:0, physical_rc:0)]B:table_rows:78522, physical_range_rows:777, logical_range_rows:777, index_back_rows:0, output_rows:777, est_method:local_storage, optimization_method=cost_based, avaiable_index_name[TABLE_SMALL], estimation info[table_id:1102810162710172, (table_type:1, version:0-1700157610566946-1700157610566946, logical_rc:0, physical_rc:0), (table_type:0, version:1700157610566946-1700157610566946-9223372036854775807, logical_rc:26174, physical_rc:26174)]
直接看 Query2 的解析执行计划,总体跟前面差不多,但原理细节有点不一样。第10行扫描 M 的算子依然是 TABLE_SCAN 但是对象是表(主键),不是索引。所以估算行数看的是过滤条件(cash_flag、txn_stat、txn_amt),每个列的选择率都是默认选择率 1/100 ,估算总体返回是 26 行。所以执行计划依然是嵌套循环连接 并选择 M作为驱动表。这仍然是个错误的执行计划。从最后面优化器返回信息里也看出来
上面解析执行计划里还有 OUTLINE DATA 信息,这个就不解读了。可以对比看 Query1 的 OUTLINE DATA 数据。
此时就靠收集表和列的统计信息来拯救了。
(TPCC@10.0.0.63:2883) [TPCC]> call dbms_stats.gather_table_stats('tpcc','table_small', method_opt=>'for all columns size auto');Query OK, 0 rows affected (3.858 sec)(TPCC@10.0.0.63:2883) [TPCC]> call dbms_stats.gather_table_stats('tpcc','table_big', method_opt=>'for all columns size auto');Query OK, 0 rows affected (1 min 43.698 sec)
查看统计信息如下。
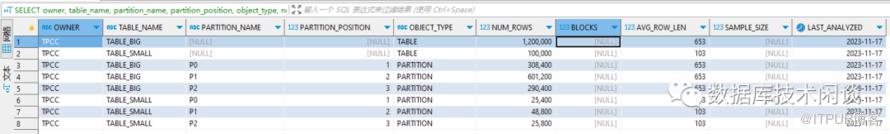
Query2 执行计划变更如下。
===============================================================|ID|OPERATOR |NAME |EST. ROWS|COST|---------------------------------------------------------------|0 |COUNT | |100 |1905||1 | SUBPLAN SCAN |VIEW1 |100 |1903||2 | LIMIT | |100 |1902||3 | PX COORDINATOR | |100 |1900||4 | EXCHANGE OUT DISTR |:EX10000 |100 |1841||5 | LIMIT | |100 |1841||6 | PX PARTITION ITERATOR| |100 |1840||7 | LIMIT | |100 |1840||8 | NESTED-LOOP JOIN | |100 |1838||9 | SUBPLAN SCAN |N |50 |1584||10| MERGE GROUP BY | |50 |1583||11| NESTED-LOOP JOIN| |387 |1568||12| TABLE SCAN |A(TABLE_BIG_I1)|4 |1191||13| TABLE SCAN |B |200 |78 ||14| TABLE SCAN |M(TABLE_BIG_I1)|1 |4 |===============================================================Outputs & filters:-------------------------------------0 - output([VIEW1.ROW_.ACCT_NUM(0x7fcb62554340)], [VIEW1.ROW_.ACCT_CODE(0x7fcb62554640)], [VIEW1.ROW_.TXN_DATE(0x7fcb62554940)], [VIEW1.ROW_.TXN_AMT(0x7fcb62554c40)], [rownum()(0x7fcb62542850) + ?(0x7fcb623e1300)]), filter(nil)1 - output([VIEW1.ROW_.ACCT_NUM(0x7fcb62554340)], [VIEW1.ROW_.ACCT_CODE(0x7fcb62554640)], [VIEW1.ROW_.TXN_DATE(0x7fcb62554940)], [VIEW1.ROW_.TXN_AMT(0x7fcb62554c40)]), filter(nil),access([VIEW1.ROW_.ACCT_NUM(0x7fcb62554340)], [VIEW1.ROW_.ACCT_CODE(0x7fcb62554640)], [VIEW1.ROW_.TXN_DATE(0x7fcb62554940)], [VIEW1.ROW_.TXN_AMT(0x7fcb62554c40)])2 - output([M.ACCT_NUM(0x7fcbc1e38680)], [M.ACCT_CODE(0x7fcbc1e3dfa0)], [M.TXN_DATE(0x7fcbc1e38ce0)], [M.TXN_AMT(0x7fcbc1e3dc70)]), filter(nil), limit(?), offset(?)3 - output([M.ACCT_NUM(0x7fcbc1e38680)], [M.ACCT_CODE(0x7fcbc1e3dfa0)], [M.TXN_DATE(0x7fcbc1e38ce0)], [M.TXN_AMT(0x7fcbc1e3dc70)]), filter(nil)4 - output([M.ACCT_NUM(0x7fcbc1e38680)], [M.ACCT_CODE(0x7fcbc1e3dfa0)], [M.TXN_DATE(0x7fcbc1e38ce0)], [M.TXN_AMT(0x7fcbc1e3dc70)]), filter(nil), dop=15 - output([M.ACCT_NUM(0x7fcbc1e38680)], [M.ACCT_CODE(0x7fcbc1e3dfa0)], [M.TXN_DATE(0x7fcbc1e38ce0)], [M.TXN_AMT(0x7fcbc1e3dc70)]), filter(nil), limit(cast(cast(?, NUMBER(-1, -1))(0x7fccf9256ff0) + cast(?, NUMBER(-1, -1))(0x7fccf9257b10)(0x7fccf9256740), BIGINT(-1, 0))(0x7fccf9258780)), offset(nil)6 - output([M.ACCT_NUM(0x7fcbc1e38680)], [M.ACCT_CODE(0x7fcbc1e3dfa0)], [M.TXN_DATE(0x7fcbc1e38ce0)], [M.TXN_AMT(0x7fcbc1e3dc70)]), filter(nil),partition wise, force partition granule.7 - output([M.ACCT_NUM(0x7fcbc1e38680)], [M.ACCT_CODE(0x7fcbc1e3dfa0)], [M.TXN_DATE(0x7fcbc1e38ce0)], [M.TXN_AMT(0x7fcbc1e3dc70)]), filter(nil), limit(cast(cast(?, NUMBER(-1, -1))(0x7fccf9256ff0) + cast(?, NUMBER(-1, -1))(0x7fccf9257b10)(0x7fccf9256740), BIGINT(-1, 0))(0x7fccf9258780)), offset(nil)8 - output([M.ACCT_NUM(0x7fcbc1e38680)], [M.ACCT_CODE(0x7fcbc1e3dfa0)], [M.TXN_DATE(0x7fcbc1e38ce0)], [M.TXN_AMT(0x7fcbc1e3dc70)]), filter(nil),conds(nil), nl_params_([N.ACCT_NUM(0x7fcbc1e389b0)], [N.TXN_DATE(0x7fcbc1e39010)]), batch_join=true9 - output([N.ACCT_NUM(0x7fcbc1e389b0)], [N.TXN_DATE(0x7fcbc1e39010)]), filter(nil),access([N.ACCT_NUM(0x7fcbc1e389b0)], [N.TXN_DATE(0x7fcbc1e39010)])10 - output([A.ACCT_NUM(0x7fcbc1e86500)], [A.TXN_DATE(0x7fcbc1e8b7c0)]), filter(nil),group([A.TXN_DATE(0x7fcbc1e8b7c0)], [A.ACCT_NUM(0x7fcbc1e86500)]), agg_func(nil)11 - output([A.ACCT_NUM(0x7fcbc1e86500)], [A.TXN_DATE(0x7fcbc1e8b7c0)]), filter(nil),conds(nil), nl_params_([A.ACCT_NUM(0x7fcbc1e86500)]), batch_join=true12 - output([A.ACCT_NUM(0x7fcbc1e86500)], [A.TXN_DATE(0x7fcbc1e8b7c0)]), filter([A.CASH_FLAG(0x7fcbc1e86b60) = 'U'(0x7fcbc1ed10d0)], [A.TXN_STAT(0x7fcbc1e871c0) = ?(0x7fcbc1ed1bc0)], [A.TXN_AMT(0x7fcbc1e86e90) != 0(0x7fcbc1ed3d40)]),access([A.ACCT_NUM(0x7fcbc1e86500)], [A.CASH_FLAG(0x7fcbc1e86b60)], [A.TXN_AMT(0x7fcbc1e86e90)], [A.TXN_STAT(0x7fcbc1e871c0)], [A.TXN_DATE(0x7fcbc1e8b7c0)]), partitions(p[0-2]),is_index_back=true, filter_before_indexback[false,false,false],range_key([A.TXN_DATE(0x7fcbc1e8b7c0)], [A.ACCT_NUM(0x7fcbc1e86500)], [A.ACCT_CODE(0x7fcbc1f026a0)], [A.ACCT_OPEN_ORG(0x7fcbc1f029a0)]), range(20220601,MIN,MIN,MIN ; 20220630,MAX,MAX,MAX),range_cond([A.TXN_DATE(0x7fcbc1e8b7c0) >= ?(0x7fcbc1ed2420)], [A.TXN_DATE(0x7fcbc1e8b7c0) <= ?(0x7fcbc1ed2c80)])13 - output([remove_const(1)(0x7fccf9269cc0)]), filter(nil),access([B.ACCT_NUM(0x7fcbc1e86830)]), partitions(p[0-2]),is_index_back=false,range_key([B.ACCT_NUM(0x7fcbc1e86830)], [B.ACCT_CODE(0x7fcbc1f1b070)]), range(MIN ; MAX),range_cond([? = B.ACCT_NUM(0x7fcbc1e86830)(0x7fcbc1f2b400)])14 - output([M.ACCT_NUM(0x7fcbc1e38680)], [M.TXN_DATE(0x7fcbc1e38ce0)], [M.TXN_AMT(0x7fcbc1e3dc70)], [M.ACCT_CODE(0x7fcbc1e3dfa0)]), filter([M.TXN_STAT(0x7fcbc1e39670) = ?(0x7fcbc1e3ecd0)], [M.CASH_FLAG(0x7fcbc1e39340) = 'C'(0x7fcbc1e416b0)], [M.TXN_AMT(0x7fcbc1e3dc70) != 0(0x7fcbc1e421a0)]),access([M.ACCT_NUM(0x7fcbc1e38680)], [M.TXN_DATE(0x7fcbc1e38ce0)], [M.CASH_FLAG(0x7fcbc1e39340)], [M.TXN_STAT(0x7fcbc1e39670)], [M.TXN_AMT(0x7fcbc1e3dc70)], [M.ACCT_CODE(0x7fcbc1e3dfa0)]), partitions(p[0-2]),is_index_back=true, filter_before_indexback[false,false,false],range_key([M.TXN_DATE(0x7fcbc1e38ce0)], [M.ACCT_NUM(0x7fcbc1e38680)], [M.ACCT_CODE(0x7fcbc1e3dfa0)], [M.ACCT_OPEN_ORG(0x7fcbc1e707e0)]), range(MIN ; MAX),range_cond([M.TXN_DATE(0x7fcbc1e38ce0) <= ?(0x7fcbc1e405f0)], [M.TXN_DATE(0x7fcbc1e38ce0) >= ?(0x7fcbc1e40e50)], [M.ACCT_NUM(0x7fcbc1e38680) = ?(0x7fccf921cae0)], [M.TXN_DATE(0x7fcbc1e38ce0) = ?(0x7fccf921d650)])Plan Type:-------------------------------------DISTRIBUTEDOptimization Info:-------------------------------------A:table_rows:1200000, physical_range_rows:101110, logical_range_rows:101110, index_back_rows:101110, output_rows:1011, est_method:basic_stat, optimization_method=cost_based, avaiable_index_name[TABLE_BIG_I1,TABLE_BIG]B:table_rows:100000, physical_range_rows:199, logical_range_rows:199, index_back_rows:0, output_rows:199, est_method:basic_stat, optimization_method=cost_based, avaiable_index_name[TABLE_SMALL]M:table_rows:1200000, physical_range_rows:1, logical_range_rows:1, index_back_rows:1, output_rows:0, est_method:basic_stat, optimization_method=cost_based, avaiable_index_name[TABLE_BIG_I1,TABLE_BIG]
统计信息更新后,三表连接顺序和算法发生大的变化。表 A 和表 B 连接的结果作为驱动表, M(TABLE_BIG)作为被驱动表,扫描的是索引 TABLE_BIG_I1 ,传递的条件(看 range_cond )是 txn_date, acct_num, 索引扫描行数(看 physical_range_rows)是1, 估算返回行数是 1 。
此时,如果单独重跑 Query2 可以很快跑出来,但是重跑 CASE 1 ,依旧是超时。依然是被 Query1 将执行计划带偏。
2.5 SQL 实验 RUN2
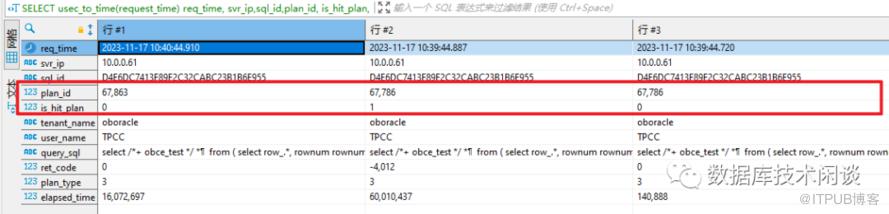
run2.sql 比 run1.sql 就是多跑一次 Query2 (变为 Query3) ,第二次执行计划就针对性调整了。
看 SQL 审计视图,可以看到 Query3 又重新生成执行计划了。
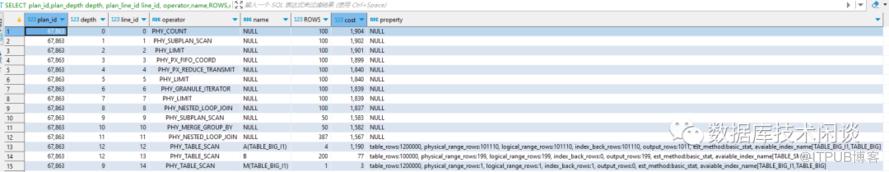
看看 Query3 使用的实际执行计划,跟 2.4 里预期的 Query2 执行计划一样了。
如果查看 Query2 对应的执行计划(4 元组条件值一定要写对,不然引起误判),会发现已经不存在了(被刷掉了)。这就是目前 OB 的执行反馈功能。参考 ORACLE 的能力可知这个后面应该还有更大改进空间。比如说保留多个执行计划适应不同的参数值。
2.6 SQL 实验 RUN3
这一步实验主要是验证 OUTLINE 干预能力。
上面 Query3 的执行计划是我们期望的执行计划,可以提取一下它的 OUTLINE DATA 信息。从视图里取或者 explain 里取都可以。内容如下第一行,我们也可以获取一下最坏的那个执行计划的 OUTLINE DATA,对比一下。
/*+ BEGIN_OUTLINE_DATA LEADING(@"SEL$5" ("N"@"SEL$5" "TPCC.M"@"SEL$5" )) USE_NL(@"SEL$5" ("TPCC.M"@"SEL$5" )) PQ_DISTRIBUTE(@"SEL$5" ("TPCC.M"@"SEL$5" ) NONE NONE) NO_USE_NL_MATERIALIZATION(@"SEL$5" ("TPCC.M"@"SEL$5" )) NO_USE_HASH_AGGREGATION(@"SEL$4") LEADING(@"SEL$4" ("TPCC.A"@"SEL$4" "TPCC.B"@"SEL$4" )) USE_NL(@"SEL$4" ("TPCC.B"@"SEL$4" )) PQ_DISTRIBUTE(@"SEL$4" ("TPCC.B"@"SEL$4" ) NONE NONE) NO_USE_NL_MATERIALIZATION(@"SEL$4" ("TPCC.B"@"SEL$4" )) INDEX(@"SEL$4" "TPCC.A"@"SEL$4" "TABLE_BIG_I1") FULL(@"SEL$4" "TPCC.B"@"SEL$4") INDEX(@"SEL$5" "TPCC.M"@"SEL$5" "TABLE_BIG_I1") END_OUTLINE_DATA*//*+ BEGIN_OUTLINE_DATA LEADING(@"SEL$5" ("TPCC.M"@"SEL$5" "N"@"SEL$5" )) USE_NL(@"SEL$5" ("N"@"SEL$5" )) PQ_DISTRIBUTE(@"SEL$5" ("N"@"SEL$5" ) BC2HOST NONE) NO_USE_NL_MATERIALIZATION(@"SEL$5" ("N"@"SEL$5" )) INDEX(@"SEL$5" "TPCC.M"@"SEL$5" "TABLE_BIG_I1") NO_USE_HASH_AGGREGATION(@"SEL$4") LEADING(@"SEL$4" ("TPCC.A"@"SEL$4" "TPCC.B"@"SEL$4" )) USE_NL(@"SEL$4" ("TPCC.B"@"SEL$4" )) PQ_DISTRIBUTE(@"SEL$4" ("TPCC.B"@"SEL$4" ) NONE NONE) NO_USE_NL_MATERIALIZATION(@"SEL$4" ("TPCC.B"@"SEL$4" )) INDEX(@"SEL$4" "TPCC.A"@"SEL$4" "TABLE_BIG_I1") FULL(@"SEL$4" "TPCC.B"@"SEL$4") END_OUTLINE_DATA*/
我们认为好坏两个执行计划的关键是表连接的顺序,就是 OUTLINE 里面的 LEADING 和 USE_NL 部分。所以 OUTLINE 替换时指定这个 HINT 。
create outline big_sql on 'D4E6DC7413F89F2C32CABC23B1B6E955' USING HINT /*+ LEADING(@"SEL$5" ("N"@"SEL$5" "TPCC.M"@"SEL$5" )) USE_NL(@"SEL$5" ("TPCC.M"@"SEL$5" ))*/;注意,每个 SQL_ID 只能绑定一个 OUTLINE。并且基于 SQL文本的 OUTLINE 会覆盖基于 SQL_ID 创建的 OUTLINE。但是 SQL_ID 使用简单。
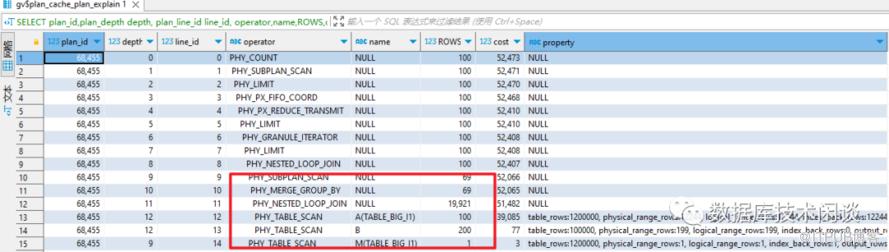
创建 OUTLINE 后重跑 run1.sql
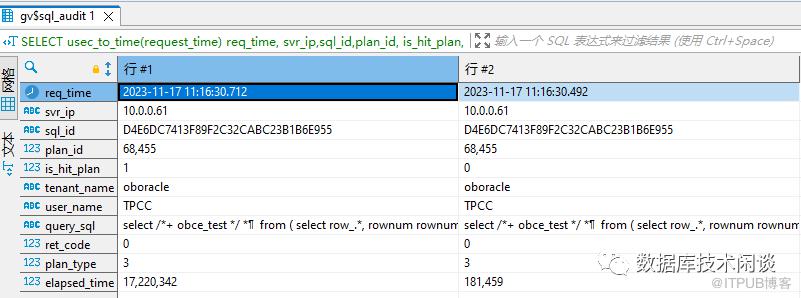
Query2 跑成功了。查看这个实际执行计划,符合预期。OUTLINE 干预执行计划成功。
2.7 表分组
上面所有截图和执行计划都是在租户的PRIMARY ZONE 是单个ZONE 情况下,所以表分组就不测试了(效果一样)。以前的文章多次测试验证了表分组对执行计划的影响。
3. 总结
OB 的 SQL 快速参数化功能使得应用 SQL 即使没有使用绑定变量也不会有 SQL 硬解析成本太高的问题。不过绑定变量的使用基本上也深入研发人心了,这点还是希望能继续坚持。OB 的 SQL 快速参数化能满足大部分业务场景的性能,但如果条件列数据倾斜很严重的情形下,执行计划有可能被带偏。OB SQL优化器的执行反馈功能能及时发现并重新生成一次执行计划来化解这个问题。如果没有解决,还可以通过 OUTLINE 在线干预 SQL 执行计划。
OB 表的数据在合并后会自动收集基本的统计信息,索引列的头列还会收集详细的数据分布信息。是否使用索引列的统计信息取决于执行计划里是否选择了这个索引列。这个场景还是有点小。大部分时候表收集统计信息(包括索引列的直方图信息)还是更推荐一些。如果更新了统计信息执行计划还是不如意,还可以清空一下该 SQL ID 的执行计划缓存让它重新生成一次。
更多阅读请参考:
OBCE V3 培训实验:应用到数据库全链路分析(上) OBCE V3 培训实验:SQL优化之表统计信息 OBCE V3 培训:应用到数据库全链路优化实验部分 OCEANBASE TABLEGROUP 用法介绍
原文作者:数据库技术闲谈;如有侵权,请联系管理员删除。

