关于业务系统双活建设中分布式数据库集群冲突数据更新的问题
为了提高核心业务系统的健壮性和安全性,通常运维要求对该核心系统进行双活和多活的建设,降低遭遇自然灾害、火灾等灾害引发整个机房无法正常工作引发的业务中断的风险。
所谓双活,就是两个数据中心都是进行工作的状态,通常的双活,我们是认为两个数据中心都是处于双写的状态,下面我们是针对此种场景进行重点说明。 ( 如果是一方读写,另一方是只读,我认为是读写分离,与热备相似度是比较高的。 )
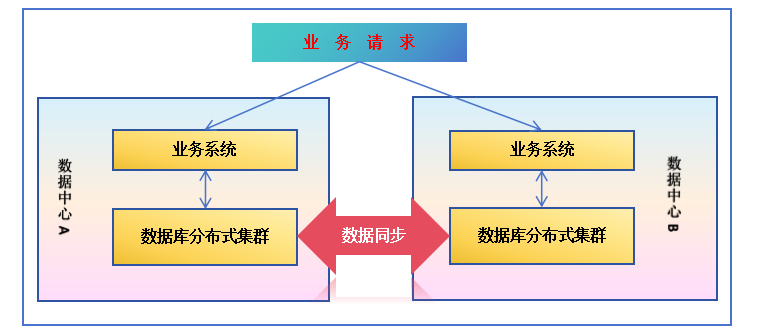
理想情况下,从请求方的角度来讲,他们与受理方是完全解耦的状态,请求方完全可以按照自己设定的分配规则来跟受理方发起请求,不用考虑受理方,这其实是完全理想的状态。如果不考虑两个数据中心的数据同步问题,这完全是没有问题的。
由于双活的业务场景,需要两个数据中心进行数据同步,数据同步的时延和效率直接影响了整个业务场景的整体设计。
如果数据中心之间数据同步时延小,同步效率非常高,可以认为是非常实时的情况,这样就只考虑最极端的情况:有请求同时对同一条记录或者相同的数据集进行更新操作时如何处理?首先这种情况是可能会发生的,在数据库分布式集群比较繁忙的时候或者遇到网络抖动出现较大网络时延的情况或者就是请求方同时发起相同数据操作却又发向不同的数据中心的时候,都会出现这种情况。
针对以上的问题,所以对于双活建设两个方案:
1. 两个数据中心独立处理
通常我们进行双活建设时,认为每个数据中心的数据库分布式集群都是一个整体,两个数据中心之间的数据库分布式集群都是独立的,彼此之间不存在耦合性关系。
针对本节开始提出的同一条 / 相同的数据集进行更新操作时,就要看各自的数据库产品的同步机制。以我们的产品为例,我们目前的产品提供两种处理机制,可以通过参数进行配置,具体到数据同步的颗粒度,也就是针对不同的复制,实现特定的同步策略的确定。同时,我们的产品可以通过自有的机制避免出现死循环的复制情况发生:
(1) 不校验变更前的数据,一切以源库为主。
(2) 校验变更前的数据,存在数据变更,即不处理,在日志进行记录,需要人工介入处理。
举例说明:现在以 Test 表为例,只有两个字段: ID 和 NAME ,现在两个数据中心的其中一条数据都是: 1 ,“张三”,现在有两个请求过来,分别到数据中心 A 和数据中心 B 来处理:
数据中心 A :将此条记录变更为: 1 ,“李四”
数据中心 B :将此条记录变更为: 1 ,“王五”
现在分场景讨论:
① 在其中某个数据中心处理完毕,并同步到对方完毕后,另外一个请求才来,这样就变更为最后处理的请求数据。例如:
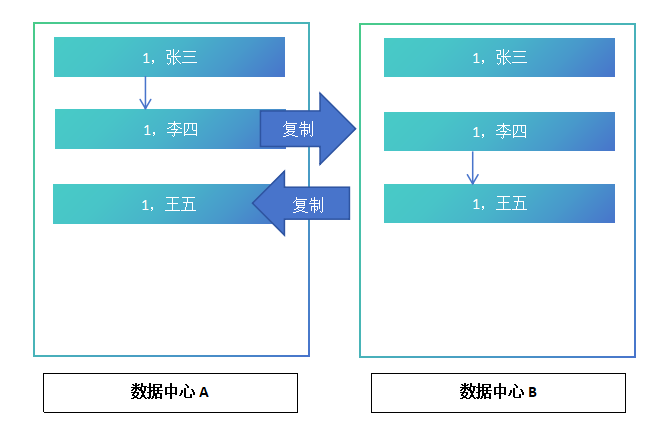
正常情况都是没有问题的,但是如果在数据库处理的过程中,因为数据库繁忙等问题,导致出现先到达的报文后处理的情况,那这种情况也是不可避免的,是存在问题可能性的。
② 在其中某个数据中心处理完毕,但尚未同步到对方完毕后,另外一个请求也已经到达,这样就比较有意思的:原则是 变更为最后处理的请求数据。 例如:数据中心 A 的更新报文先到处理完毕后,再向数据中心进行复制(此处默认是异步复制,同步复制也支持,但是对于数据库的性能还是影响比较大的,通常的业务系统中的数据库复制要求是异步复制。),此时,数据中心 B 的请求报文也到了。
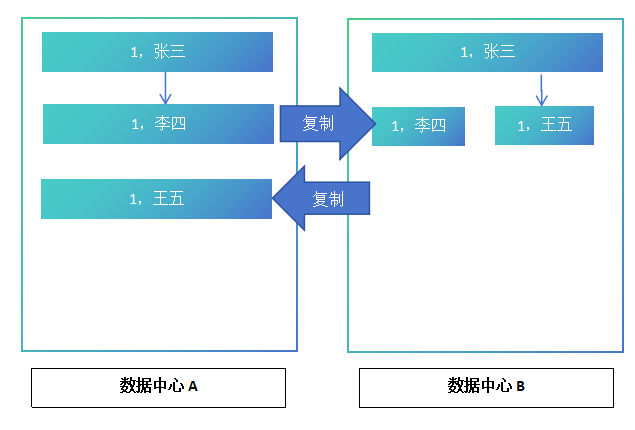
数据中心 B 的处理过程中:对于更新为“ 1 ,李四”和“ 1 ,王五”的过程,对于数据库而言都是两个事务,谁先到谁先处理,后处理的事务待已经处理的事务处理完毕解锁后再进行处理。所以,数据中心 B 的数据要根据复制和请求“ 1 ,王五”的先后来定。
数据中心 A 的处理过程:将数据变更为后来才到的“ 1 ,王五”。
总结:如果是复制先处理,那这样两个数据中心是一致的,其实就是转变为 ①的场景,最终都是“ 1 ,王五”。
如果是请求 “ 1 ,王五”先处理,那么就演变成数据中心 A 和数据中心 B 对该条数据都变更完毕了,然后彼此向对方发送复制数据。对于最终是否数据一致,需要看复制的参数设置规则。
A、 如果都是设置为以源库为主,那么数据中心 A 最终的数据为:“ 1 ,王五”,数据中心 B 最终的数据为:“ 1 ,李四”。
B、 如果都是设置为冲突即不做更新处理,那么数据中心 A 最终的数据为;“ 1 ,李四”,数据中心 B 最终的数据为:“ 1 ,王五”。
C、 对于以上 A 和 B ,该数据的最终是不一致的。
D、 如果双方设置不同,那么最终是一致的,要么是 “ 1 ,李四”,要么是“ 1 ,王五”,这种最终一致性,但其实也可能是有问题的。
以上是如果存在同时更新一条或者多条相同数据的情况发生时不可避免存在的问题,这样就需要业务侧在处理请求报文时,能够按照某个特定的规则将数据进行区分处理,这样确保两个规则是分开的,这样就会避免同时更新一条或者多条相同数据的情况,以上问题出现的概率就大大降低了,再发生类似的情况可能就是在双活切换的瞬间可能存在这种情况。(在每个数据中心存在数据库的高可用,一般不建议进行双活之间的切换,除非特别极端的情况。即使需要切换,通常也建议在业务低峰期时进行切换)
2. 两个数据中心耦合性处理
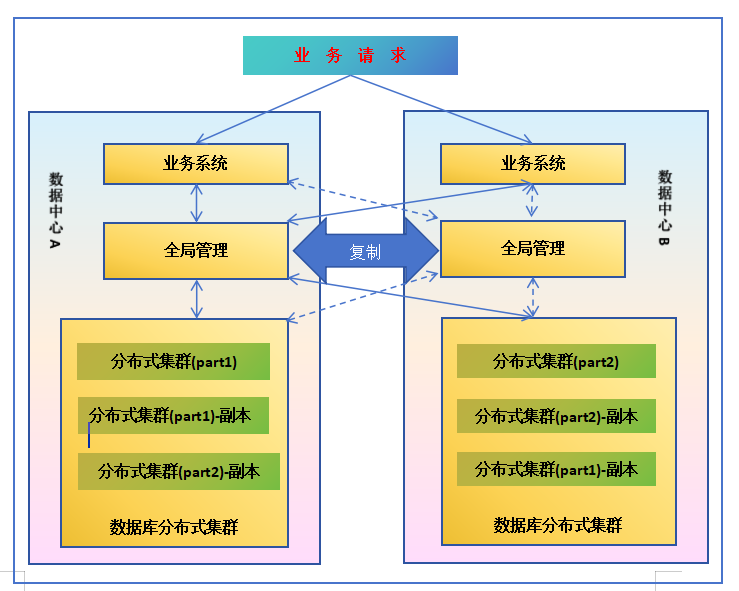
如果存在耦合性关系那就是要增加两个数据中心的数据库 / 数据库分布式集群的全局管理,如此设计将会大大降低双活的处理效率和处理容量。
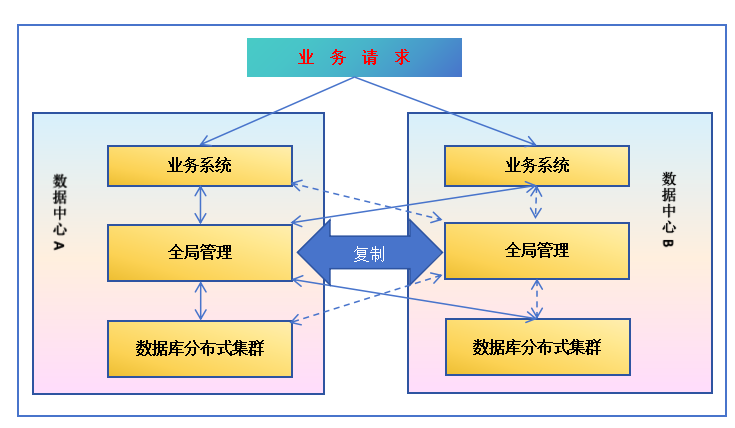
全局管理需要考虑到双活的建设背景,将其添加到数据库或者数据库分布式集群的上方,考虑到全局事务的处理,部署在两个数据中心的全局管理必须采用热备处理,这个模块不能采用双活方式进行运行。
其实,在运行后,目前的运行架构很类似于底层是一个大的分布式数据库集群。只不过,是相当于将数据库分布式集群部署在数据中心 A 和数据中心 B 。
对于分布式数据库集群而言,分布式集群( part1 )和分布式集群( part2 )合起来是一个完整的分布式集群,按照下图的设定进行处理,在数据中心内部已经实现了部分集群之间的高可用,如某个数据中心出现问题,在剩下的数据中心也可以实现全部分布式集群的处理。
这个方案的前提因素有个重点是:数据中心 A 和数据中心 B 之间最好有专线连接,确保网络的稳定性和及时性。
特别补充说明:
1. 对于一个事务中,需要更新多张表的情况,如果多个事务经常频繁引发锁的情况,需要添加一个业务锁的情况,例如:设定业务锁表 USER_LOCK 。
2. 当对某个对象的相关表进行更新时,首先在 User_lock 中插入一条该对象的记录,或者将该对象对应的记录进行特殊标记(标记为正在处理),并提交;
3. 开启第二个事务,将相关的业务表数据进行处理,
(1) 处理完毕后,将 user_lock 表中该对象的记录删除或者将其记录进行特殊标记(标记为已完成或者未处理)并提交。
(2) 如处理失败,将该事务进行回滚,同时,在此事务中将 user_lock 表中该对象的记录删除或者将其记录进行特殊标记(标记为未处理)并提交。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/7741585/viewspace-3080088/ ,如需转载,请注明出处,否则将追究法律责任。

