创建一个常规的堆表,并在上面建一个复合索引
SQL> create table t1 as select * from all_objects;
表已创建。
SQL> create index idx_t1_1 on t1(owner,object_type);
索引已创建。
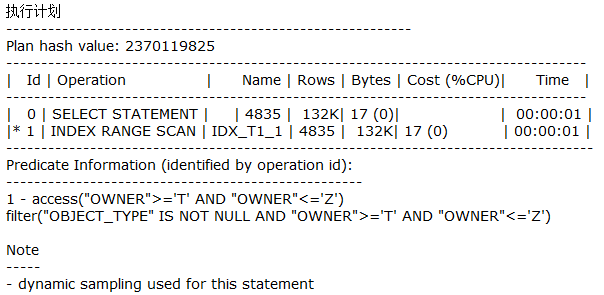
下面这个查询语句比较特殊,
order by的条件与select的列表栏位都在符合索引内,
所以这个查询的检索根本没有涉及到堆表,而完全在索引内完成。
而且因为索引本身就是依序存储的,所以查询计划中并没有sort这一项。
SQL> set autotrace traceonly explain;
SQL> select owner,object_type from t1
2 where owner between 'T' and 'Z'
3 and object_type is not null
4 order by owner,object_type;
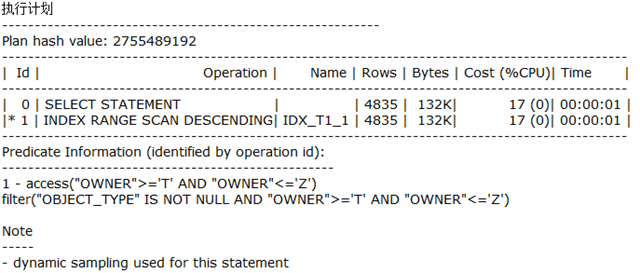
下面的查询也类似,虽然排序条件中指定使用降序,但是db需要做的只是反向扫描索引。
所以仍然没有sort的步骤
select owner,object_type from t1
where owner between 'T' and 'Z'
and object_type is not null
order by owner desc,object_type desc;
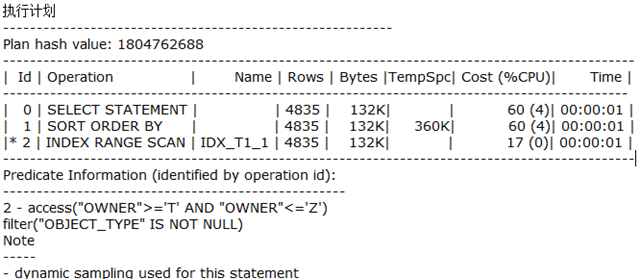
可以看出,下面的查询使查询计划多出了一个sort的步骤。
这是因为,虽然order by和select列表的栏位都在索引内,且数据也只会在索引存储内取得,
但是因为索引都是依升序排列的,所以在取得数据后,db还是要针对第二个栏位进行排序。
select owner,object_type from t1
where owner between 'T' and 'Z'
and object_type is not null
order by owner,object_type desc;
接下来创建一个相同的堆表,但是建复合索引时指定第二个栏位为降序
SQL> create table t2 as select * from all_objects;
表已创建。
SQL> create index idx_t2_1 on t2(owner,object_type desc);
索引已创建。
执行以下查询,会发现,因为索引定义时指定第二个栏位为降序,该语句的执行计划没有sort这一步骤。
select owner,object_type from t2
where owner between 'T' and 'Z'
and object_type is not null
order by owner,object_type desc;
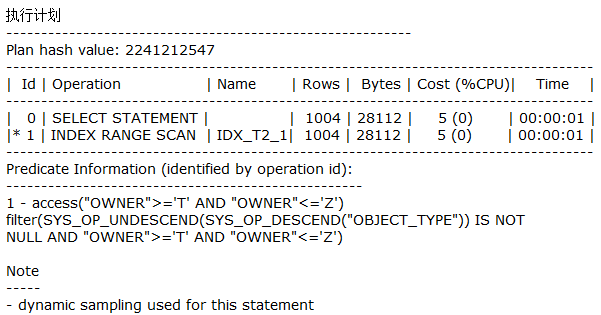
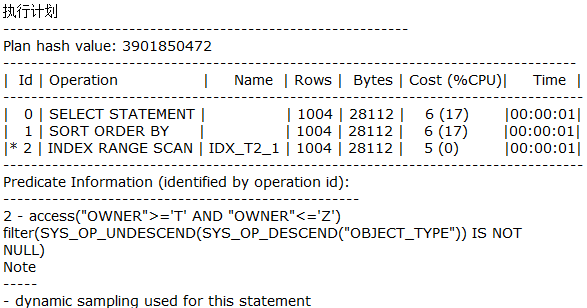
但是当order by条件变为全部为升序时,sort的步骤再次出现。
select owner,object_type from t2
where owner between 'T' and 'Z'
and object_type is not null
order by owner,object_type;
SQL> spool off
以上是一个简单的例子。当表变得比较大时,一个排序的任务可能会占用较多的资源和时间。
当遭遇性能问题时,有时可以尝试结合复合索引及排序条件看有没有改善空间。
http://hi.baidu.com/ljm0211/blog/item/11c6962b8feee0fde7cd40ab.html
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/720091/viewspace-1058314/ ,如需转载,请注明出处,否则将追究法律责任。

