YARN 上运行 MapReduce 程序
1 首先配置yarn-env.sh
| export JAVA_HOME=/opt/module/jdk1.8.0_144 |
2 配置 yarn-site.xml
<!-- reducer 获取数据的方式 -->
<property>
    <name>yarn.nodemanager.aux-services</name>
    <value>mapreduce_shuffle</value>
</property>
<!-- 指定 YARN 的 ResourceManager 的地址 -->
<property>
    <name>yarn.resourcemanager.hostname</name>
    <value>hadoop101</value>
</property>
3 配置 mapred-env.sh
| export JAVA_HOME=/opt/module/jdk1.8.0_144 |
4 对 mapred-site.xml.template 重新命名为 mapred-site.xml 并配置如下:
<!-- 指定 mr 运行在 yarn 上 -->
<property>
    <name>mapreduce.framework.name</name>
    <value>yarn</value>
</property>
5 启动集群
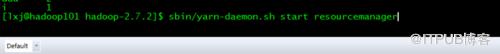



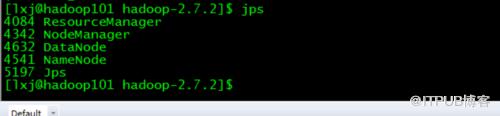
6 浏览器打开 http://192.168.43.101:8088/cluster/apps
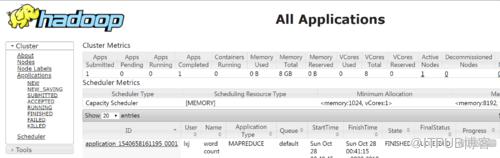
7 运行mapreduce程序

8 查看运行结果
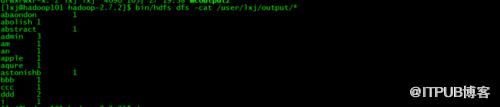
注意: 该案例需要配合Namenode Datanode一起使用,Yarn只负责资源调度等。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/717/viewspace-2816111/ ,如需转载,请注明出处,否则将追究法律责任。

请登录后发表评论
登录
全部评论
