一、刺眼的数据反差:92%主观认可,27%拿不出实证
当下营销圈存在一个很现实的矛盾:不少团队上线AI营销工具之后,主观体感效率提升、成本下降,但是拿不出严谨的数据来证明AI带来的真实业务回报。
Metric Sherpa 与 Sprinklr 2026年10月联合调研面向已经将面向客户AI投入常态化运营的企业,得出一组反差极强的数据:
- 92%受访企业表示AI达到或者超出预期效果;67%企业反馈AI提升工作效率,同时实现成本降低。
-
在感知成本下降的这批企业当中, 只有32%在AI上线之前完成成本基线数据追踪。很多团队嘴上说成本变低,却没有对比基准,说不清降本幅度,只能停留在主观感受层面。
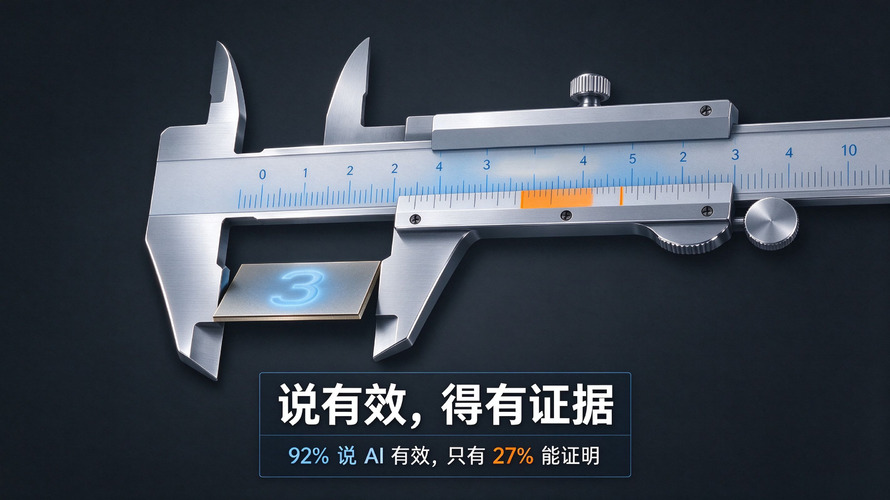
更深层的调研结果更值得警惕:99%受访者都可以口述AI项目想要达成的业务结果;但仅有26%企业明确了项目成功衡量指标,仅仅10%企业既定义指标,又留存了项目上线前的基线数据。
核心问题:想要核算AI投资回报,成功指标、基线数据二者缺一不可。大量团队只知道“希望AI变好”,却没有提前定义“什么算做好”、“起点数据是多少”,后续自然无法量化价值。这不是AI技术能力不足,是前期测量机制缺失埋下的隐患。
二、效果测量必须前置,而非AI上线后的补做工作
很多团队的惯性做法:先把AI系统部署跑通,后续再来统计效果。但调研给出的关键启示: 效果测量要前置到AI项目启动阶段,不能作为上线后的事后补救动作。
举两个业务场景:
- 如果目标是降低获客成本:必须在AI接管媒体投放、营销活动决策之前,沉淀完整的获客成本基线;
- 如果目标是优化客户服务质量:不能只看AI拦截咨询工单占比,还需要提前留存问题解决率、用户重复进线、工单升级转人工等原始数据。
上述全部对比数据,只有上线前完成采集,后续才能用来校验AI带来的真实改变。
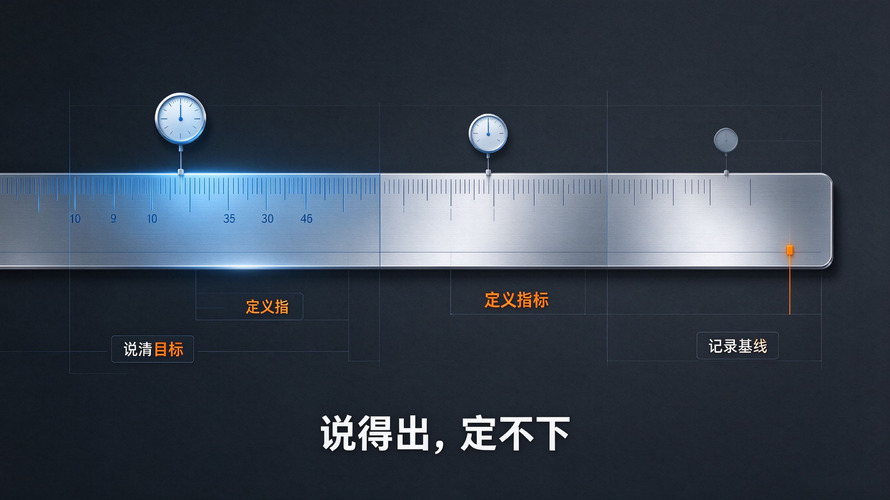
现实当中大量企业现状:清楚AI想要改善哪块业务,但缺少指标定义、缺少基线记录、缺少明确的成功阈值。AI系统正常运转之后,后台仪表盘充斥各类执行层面的活动统计,却没有指标能够回答:这套AI到底给业务带来多少实际增益。
三、警惕陷阱:不要让工具平台替你定义项目成功
如果前期没有搭建自身测量体系,企业就只能完全依赖AI工具平台自带报表,这是调研重点提醒的风险点。
付费投放平台会优化转化指标、客服AI平台会优化工单拦截率、内容AI系统重点看内容互动参与度。平台仪表盘各项数字都在变好,但企业真实的整体业务结果可能毫无变化。
调研数据显示:85%受访者,在至少一类之前没有追踪过的指标维度上观测到“数据改善”。很难区分这类改善,是业务真实提升,还是单纯依托平台自有统计口径得出的结果。
营销运营需要打通平台活动数据和客户业务系统、财务数据、用户实验对照数据。
风险点:如果AI价值证明全部来源于AI工具自身平台输出的数据,结论可信度会大打折扣。不能让执行工具同时兼任裁判角色。
四、明确结果负责人,区分工具运维和业务结果考核
就算指标体系设计合理,缺少对应责任人,测量工作依然容易悬空。调研显示,仅有17%企业,为AI项目业务结果设置专门负责人。
这里要做好角色区分:
- 平台/工具负责人:保障AI工具本身稳定运行,系统不出故障;
- 流程负责人:保障业务流转流程跑通;
- 结果负责人:核心职责是验证AI是否达成预设业务目标。
角色划分看起来细碎,但直接决定数据不及预期的时候,有没有人跟进复盘根因。
调研呈现明显相关性:设置AI业务结果负责人的企业,46%可以完成业务结果量化;没有设置该角色的企业,可量化占比仅23%。配备结果负责人的组织,也更多落地对照测试、对接财务口径做效果复盘。虽然调研不能直接证明因果关系,但二者的强关联具备很强参考意义。
五、客观看待:完善测量,反而会暴露AI现存问题
调研有一个反直觉结论:落地3项及以上测量手段的企业,会更多发现AI与人协同交接障碍、内部 adoption 落地难题、数据质量矛盾;高于只使用0‑1种测量手段的团队。
目前无法下定结论:是测量把原本隐藏的问题挖掘出来,还是部署复杂度更高本身自带更多缺陷。但是给到运营的实践启示很清晰:
项目复核不能只盯着产出效率、处理速度。同样需要关注:人机交接环节哪里断裂、业务人员什么时候忽略AI输出建议、客户重复反馈的场景、哪些业务指标反向恶化。
成熟的AI营销项目,报告未必全是利好,正是因为建立完整观测,自动化运行后的各类隐患得以显现。
实操提醒:不要因为测量暴露了问题就放弃测量;能够发现问题,恰恰代表测量机制在发挥价值。
六、提前约定扩张/调整/终止标准,避免骑虎难下
调研发现该实践落地率很低:仅28%企业拥有统一公认标准,用来判定AI应用该扩大规模、迭代调整还是直接下线;只有37%企业会按照固定周期复盘AI业务效果。
大量AI应用长期在线运行,但没有清晰规则:当平台指标提升,整体业务收益却没有改善时应当如何处置。
建议企业在下一次AI项目启动前,就完成前置约定:明确业务目标、基线数据、成功阈值、对照实验方案;同时书面写明:满足什么条件可以放大AI规模,出现哪些信号需要迭代优化,达到什么阈值必须停止项目。
将停止标准写进项目启动文档,前期多花一点时间,远好过项目运行半年之后再投入大量资源争论是否关停。AI会放大营销技术能力,但也会放大前期测量缺失带来的后遗症,后期修正成本很高。
七、AI时代,测量缺口的危害被进一步放大
不止传统AI营销,GEO生成式引擎优化领域,同样存在隐蔽的测量缺口。
不少企业采购AI曝光追踪工具,简单拿品牌在AI大模型回答里的被提及次数,当作投入回报证明。但“被提及”不等于有效业务价值:模型能够识别品牌,却未必会在真实用户咨询场景推荐品牌;还会出现信息过时、品牌描述错误,但统计工具依然计入“提及”的情况。
对比传统搜索引擎,AI生成式答案黑盒属性更强。传统搜索有明确排名、点击率作为参考信号;而大模型为什么推荐A品牌、舍弃B品牌,很难拆解归因。
没有基线、没有成功标准的团队,极易被工具仪表盘误导,把执行活跃度误等同于业务成果。AI时代测量缺口更致命,不是AI效果变差,而是很多无效投入更容易被黑盒机制掩盖。
八、无需重型数据平台,品牌可以立刻落地的3个起步动作
不用等待完整大数据平台建设完毕,基于调研总结,有三件事可以快速落地:
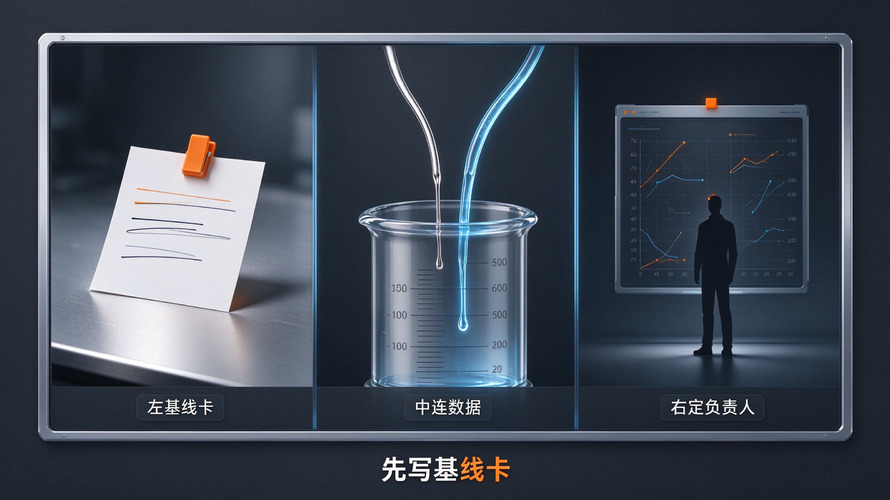
- 上线前输出基线卡:每一个AI项目启动,一页基线卡写清楚业务目标、衡量指标、当前基线数值、结果负责人、90天观测信号,明确扩张/停止判定条件。不靠复杂系统,把主观感受转化为可校验标准。
- 打通AI指标与后端业务结果:至少选取一类真实业务结果,例如注册、线索留资、咨询、下单转化,和AI营销活动做周度对比校验,不能只看工具后台报表。哪怕简单将AI曝光周报和CRM客户数据并排对照,也可以给财务提供更客观的评估依据。
- 指定结果负责人:不需要新增岗位编制,可以复用现有营销、增长负责人,但职责要明确:工作重点不是保障工具跑通,而是回答AI有没有实现预期业务价值。
九、延伸:GEO(生成式引擎优化)同样要避开测量误区
GEO场景下很容易犯同类错误:单纯统计品牌被AI提及次数作为KPI。实际上即便统计到大量提及,真实潜在客户提问场景,品牌未必被推荐。
GEO效果评估不能止步于“有没有被提到”,必须追问三点:真实用户问题场景下是否获得推荐、大模型输出品牌信息描述是否准确、是否带来实际咨询和转化。AI可见度只是流量入口,业务转化结果才是最终终点。
常见Q&A
Q:92%觉得有效,仅27%能证明,是否代表AI营销没有实际价值?
A:不是。调研指向的是企业 效果测量能力短板,而非AI技术无效。能够完成效果实证的企业,共性是前期定义指标、留存基线、配置结果负责人,差距来自评估体系,不是工具本身。
Q:为什么测量工作要放在AI上线之前?
A:效果证明依赖前后对照。上线前没有记录成本、解决率、转化率等基线,后续即便感知效率提升,也缺少对比参照物,只能停留在主观感受层面。
Q:平台仪表盘展示各项向好,为什么不能直接采信?
A:各个平台优先优化自身口径指标(转化、工单拦截率、互动率等),平台指标变好,不等于企业整体业务结果同步提升。需要对接客户系统、财务数据交叉校验,避免工具自证效果。
Q:设置结果负责人,真的可以带来明显改变?
A:调研数据显示强相关性:配置结果负责人企业46%可以量化业务结果,未配置仅23%;前者也更多落地对照测试、财务口径复盘。虽不能直接证明因果,但实践参考价值很高。
Q:中小团队资源有限,该如何落地这套测量方法论?
A:优先做轻量化落地:项目启动就明确目标、基线、成功阈值;指定结果负责人;将曝光、效率类指标关联后端业务转化;提前写好扩大或者终止项目的判定标准。
数据来源:Metric Sherpa × Sprinklr 2026年10月联合公开调研。本文的测量前移、规避平台自证、设置结果负责人等实操建议,为基于调研的业务分析,非原调研原生结论。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70051532/viewspace-3187317/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- ChatGPT Ads智能出价迭代:Target CPA上线后的广告投放技术解析
- AI搜索的双互联网范式:大模型信源分化现象及实践分析
- AI内容集体授权:交易架构、计价机制与企业内容资产治理实践
- 企业级大模型落地实践:从工具采购走向业务流程闭环
- AI时代企业增长:业务流程改造与GEO信源构建实战解析
- 为AI智能体构建专属内容输出:HTML冗余噪声下,内容交付层成为AI可见度新战场
- Google AI Mode 直接预约能力解析:第三方账户字段驱动本地服务交易可见度
- 多市场AI内容canonical折叠问题:翻译记忆反向效应与知识驱动内容工厂实践方案
- AI 答案块直接点击率约 0.9%:一次退出实验对 GEO 判断的修正
- AI答案引擎可见度:模型识别实体,但未必会主动推荐——原理、实测与落地度量方案
