推理成本直降78%、API费用降低97% , aiXcoder开源aiXcompact-4B上下文压缩模型
11月11日,硅心科技(aiXcoder)正式开源aiXcompact-4B 上下文压缩专用小 模型 ,支持 单张 A100-40GB显卡私有化部署。
aiXcompact-4B 面向 编程智能体 的 长程复杂 研发 场景 , 聚焦 上下文持续膨胀带来的高额 Token 消耗 与 模型推理质量下降的工程痛点 , 通过结构化压缩 精简 历史上下文、保留关键任务信息, 大幅降低每轮 Agent 推理的 Token 消耗 ,以更低成本支撑复杂研发任务高效 、 稳定推进。
开源地址: https://github.com/aixcoder-plugin/aiXcompact-4B
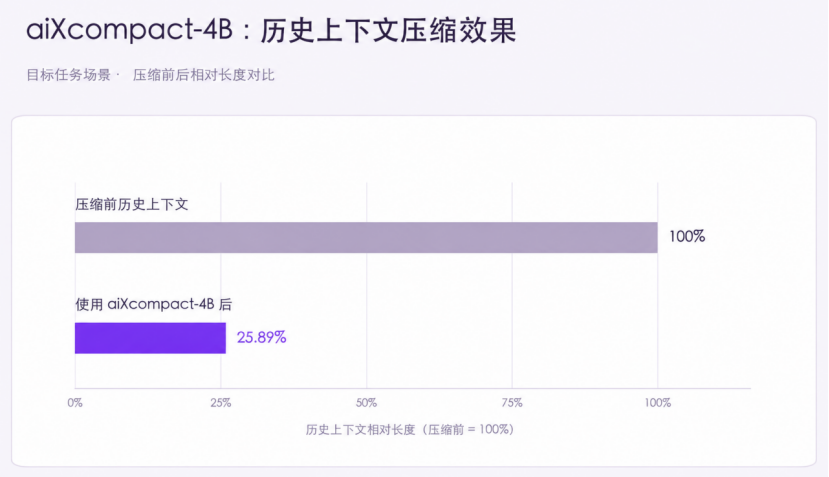
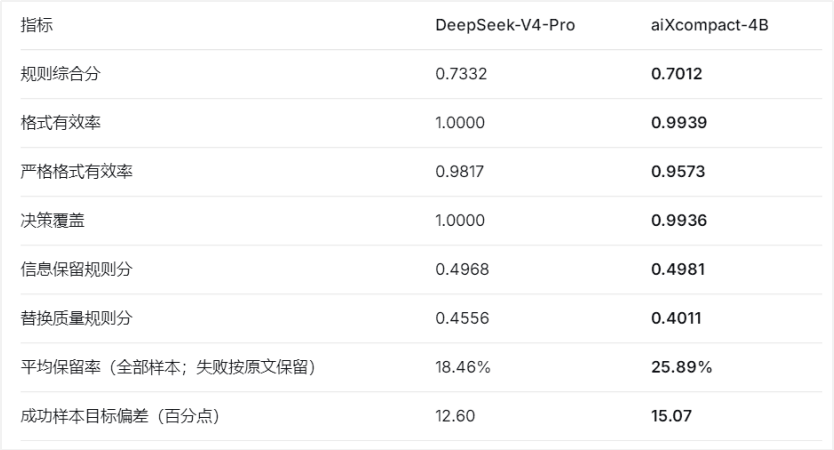
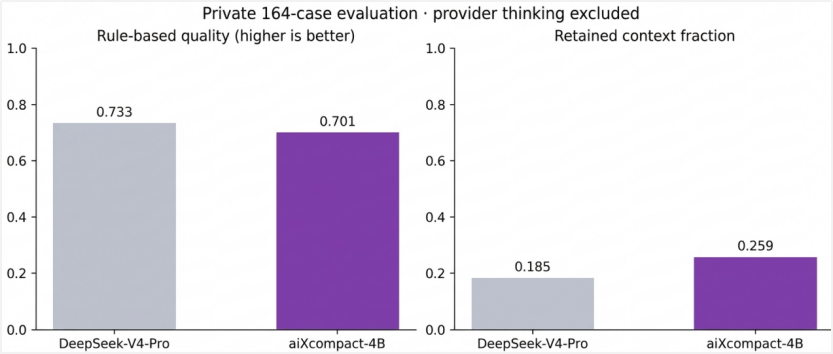
在目标任务场景下, aiXcompact-4B可将历史上下文平均压缩至原长度的 25.89% 。相较于 Claude Code、OpenCode等主流Agent Harness直接调用通用大模型进行上下文压缩的方式,aiXcompact-4B能够 在降低 Token开销、提升压缩效率的同时,兼顾压缩质量与后续任务的执行效果 。
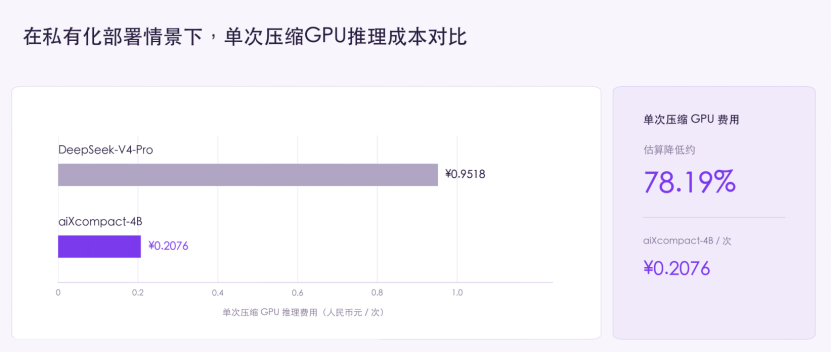
在 Terminal-Bench基准测试集上,将aiXcompact-4B接入OpenCode 测试 上下文压缩任务效果显示, aiXcompact-4B相对于DeepSeek-V4-Pro整体任务完成准确率并未下降。 私有化部署情景下, 在 针对特定任务 的 Benchmark 上,相对于 DeepSeek-V4-Pro,aiXcompact-4B单次GPU推理成本直降78%。
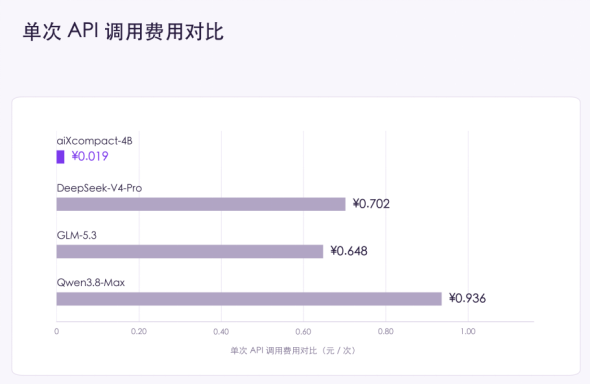
采用 API调用方式,根据 公开 API费用代理估算,aiXcompact-4B单次上下文压缩请求的Token费用为0.019元。相对DeepSeek-V4-Pro、GLM-5.3和Qwen3.8-Max的参考费用,分别降低97.30%、97.08%和97.98% 。 aiXcompact-4B以单次API 调用费用降低 9 7 %的成本优势, 为高频上下文压缩提供了更轻量化且更经济的选择。
一、复杂AI研发任务需要持续管理上下文,控制Agent运行成本
在企业级研发场景中, Agent往往要执行跨多文件、多环节的复杂迭代任务。 以给现有系统增加用户注册功能为例, Agent需要先了解项目结构,查找已有的用户管理和鉴权逻辑,再修改多个相关文件、运行测试,并根据错误日志反复调整。
多轮交互过程中,文件读取、工具调用、执行日志不断累积,造成上下文 持续 膨胀, 最直接的代价就是Token总量暴涨,拉高每一轮推理时延与算力 成本 。 同时,重要工程 约束、有效决策和 大量 过程 信息 混杂在一起, 容 易 导致 智能体遗忘早期需求、丢失关键报错信息 、 长任务推理质量下滑 等问题 。 即便使用更大 上下文 窗口的大模型,也难以完全规避长上下文性能断崖退化问题 。
因此编程 Agent 需要 动态治理历史上下文:过滤无效信息、保留关键业务约束与任务进度,在有限 Token预算内保障任务持续推进 。 aiXcompact - 4B正是面向该场景打造的专项 小 模型 , 通过 减少 Agent 多轮执行中的重复 Token消耗 , 在 控制 Agent运行成本 的同时, 让有限的上下文 窗口 承载更多有效信息 , 使 Token预算集中服务于 核心 任务的推进。
二、aiXcompact-4B结构化压缩决策,显著降低Token消耗
AI研发任务中的上下文具有明确的角色和结构,包括用户提出需求、Agent分析问题、调用工具、工具返回文件内容、检索结果或执行日志。
有效的压缩需要理解这些信息之间的关系,并判断它们对后续任务是否仍有价值。 aiXcompact-4B创新采用结构化判别机制,针对AI任务历史轨迹中的各项内容生成结构化决策,主要包含三类处理逻辑:
l 保留:对于核心需求、关键约束等重要原始信息, aiXcompact-4B选择完整保留 。
例如,开发者明确要求兼容现有接口、不引入新的外部依赖,或已确认沿用某个鉴权组件,这些内容会直接影响后续代码实现,不适合随意删减。保留原始消息,有助于避免关键限定条件在改写过程中被弱化,让后续工作有明确依据。
l 精简工具结果:保留调用关系,缩短冗长输出。
文件读取、代码搜索和测试运行往往返回大量上下文,其中可能只有部分信息与下一步工作直接相关。 aiXcompact-4B会保留工具调用,用压缩后的简洁文本替换长篇大论的原始输出。既有效 减少 了 每轮 Agent 调用的输入 Token ,又保留了任务下一步所需的关键线索。
l 删除:对于重复记录、已失去后续参考价值的中间输出, aiXcompact-4B会选择删除,直接削减整体Token占用 。
删除操作会配套校验动作,确保被删内容里的关键业务、调试信息已经保留在任务摘要中。
以上决策都有对应的操作记录:哪些内容被保留,哪些工具输出被替换,哪些历史项被删除,便于开发者检查压缩过程。
在完成上下文信息筛选的同时, aiXcompact-4B还会生成结构化的任务摘要,记录用户意图、关键技术信息、错误与修复过程、当前工作和待办事项。经过压缩处理后输出的不是一大段无结构的总结文本,而是一套可以直接提供给Agent继续执行的消息序列,完整维持工具调用与返回结果的配对关系,保障后续任务能够无缝接续执行。
整套结构化处理 在保障任务关键信息不丢失的前提下,可将历史上下文平均压缩至原长度的 25.89%,为下一轮Agent调用腾出足量的上下文空间。随着压缩后的上下文被后续 Agent 多轮调用,冗长文件内容、重复记录与中间日志带来的重复输入开销也随之减少,有效降低整个研发任务的总 Token消耗。
三、模型蒸馏+LoRA微调技术路径,压缩表现高度接近DeepSeek-V4-Pro
在 显著 减少上下文 Token 消耗 的同时, aiXcompact-4B也注重压缩后 上下文 信息的完整性与可用性。
对此, aiXcoder构建了针对上下文压缩专项任务的评测集,结果显示,aiXcompact-4B在规则综合分、信息保留等上下文压缩关键指标上,接近总参数量为1.6万亿的DeepSeek-V4-Pro历史参考表现。
aiXcompact-4B能够以小博大,得益于其采用的“教师大模型蒸馏+4B学生模型LoRA微调+结构化压缩决策”技术路径。
aiXcompact-4B训练数据全部来源于真实研发场景下的Agent运行轨迹,经过轨迹归一化、过滤筛选和压缩触发点采样,由教师模型生成参考压缩决策,再经过样本校验与筛选,用于学生模型的专项训练。模型由此学习如何结合AI研发进度处理历史上下文,以及如何在任务摘要中保留后续工作依据。
这种方式的价值在于,将一项高频、面向特定任务场景的处理能力的工作,从通用大模型的任务中拆分出来,用一种成本更低、更快的方式,转化为可以由专用模型独立承担的能力。
四、构建小模型矩阵,推进大小模型协同
aiXcompact-4B并非aiXcoder推出的专用小模型。aiXcoder持续践行“场景定义模型”理念,面向不同领域的业务场景与具体任务需求,构建专业化模型矩阵。在软件研发领域,aiXcoder已推出面向代码生成与补全 的 aiXcoder-7B、面向代码变更应用的aiXapply-4B,以及面向Token消耗优化的aiXpruner-4B 等模型。此外,aiXcoder即将推出面向Agent决策环节的
aiXdecision模型,专注于智能体执行过程中的判断与决策支持,进一步拓展专用模型的应用边界 。
此次开源 aiXcompact-4B,则将 小 模型矩阵进一步拓展至 Agent上下文管理环节,体现了aiXcoder从具体场景和任务需求出发定义模型能力,通过大小模型协同支撑不同领域复杂任务的技术路线。
aiXcompact-4B开源地址:https://github.com/aixcoder-plugin/aiXcompact-4B,欢迎下载体验,在真实Agent场景下开展验证。aiXcoder期待与社区、各行业一起,探索大小模型架构在企业级AI研发私有化和领域化落地的更多可能。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70051527/viewspace-3188783/ ,如需转载,请注明出处,否则将追究法律责任。

