智能人岗匹配引擎的设计与工程实践
一、匹配算法的技术路线选择
招聘场景的智能匹配与其他推荐场景有一个本质区别:它需要“双向满意”。求职者想找到合适的工作,企业想找到合适的人,两个方向的匹配逻辑并不完全对称。当前工程实践中较为成熟的方案是 混合推荐模型 :基于内容的推荐处理技能标签与岗位要求的文本相似度匹配,协同过滤利用用户行为数据发现潜在的匹配关系,两者通过动态加权融合输出最终推荐结果。

在学术研究层面,基于知识感知的在线职位推荐模型通过简历融合技术,将知识感知离线模型与基于内容的在线模型相结合,有效解决了职位冷启动和长尾问题 。大语言模型与图神经网络结合的信号集成系统也在大型招聘平台中得到验证 。
二、从算法到工程的落地要点
算法原型到生产系统之间存在显著的工程鸿沟。首先是 冷启动问题 :新注册的求职者没有行为数据,协同过滤无法发挥作用,此时需要依赖内容特征进行匹配,对求职者的技能标签、期望岗位、工作经历进行结构化提取,作为协同过滤的兜底策略。
其次是 权重设计 。在岗位匹配中,“Python”作为核心技能标签的权重应当显著高于“办公软件”这类通用标签。工程实践中可以通过TF-IDF的IDF部分自动赋予稀有技能更高的权重,同时结合业务规则对特定技能标签进行人工加权调整。
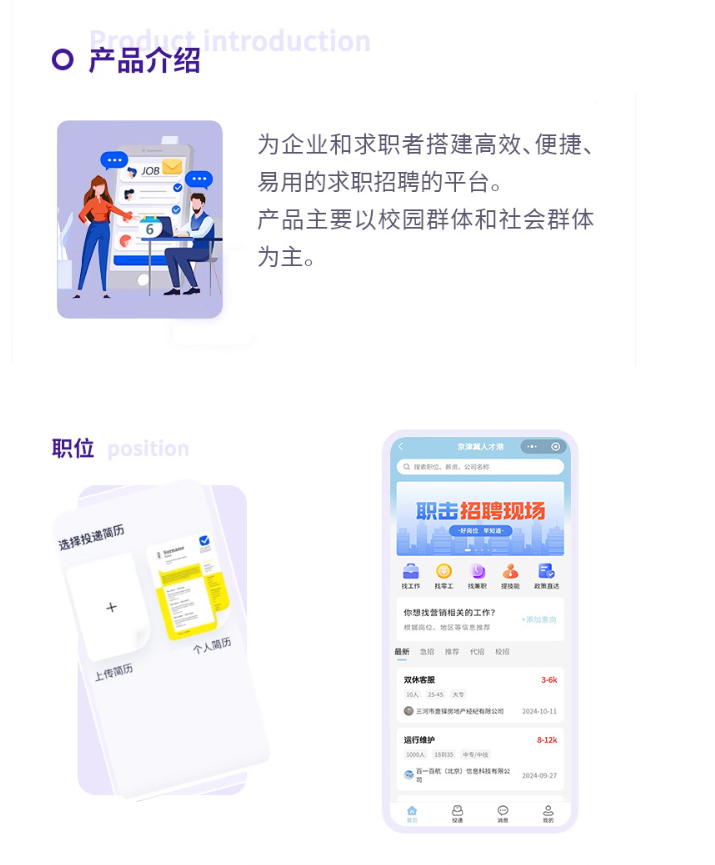
第三是 性能与规模的平衡 。当平台岗位数达到十万级、简历数达到百万级时,全量相似度计算的成本急剧上升。可行的优化路径包括:对岗位和简历进行粗筛(基于地理位置、行业类别、薪资范围等硬性条件快速缩小候选集),再对候选集做精细的向量相似度计算;引入向量数据库加速近邻搜索。
三、匹配效果的评价体系
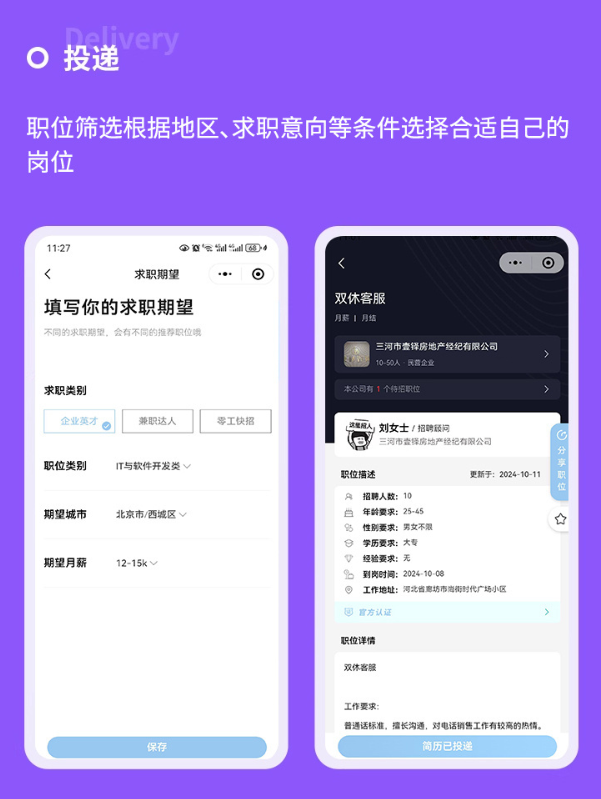
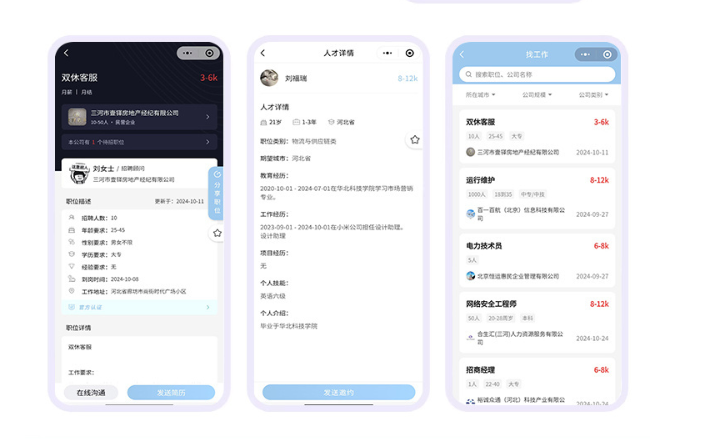
匹配算法的效果不能只看点击率。招聘场景的核心指标是“有效匹配”——投递后进入面试环节的比例、面试后录用的比例。这就要求系统不仅记录用户是否点击了推荐岗位,还要追踪投递状态机中从“投递”到“录用”的全链路转化数据,用这些数据反馈优化匹配模型的权重参数。这是一个需要持续迭代的过程,而非一次性的算法部署。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70051484/viewspace-3184731/ ,如需转载,请注明出处,否则将追究法律责任。

