一张表能顶十张表?Greenplum 分区表才是隐藏的“性能开关”
01 / 一句话讲清楚
分区表 就是把一张大表,按某个规则(比如日期、地区)切成若干张小表。
查询时,Greenplum 只扫描相关的小表,其他分区直接跳过。
📌 这就是 分区剪裁 ,效果堪比给大表装上了“智能筛选器”。同样扫描10万行,不分区可能要扫1亿行。
02 / 什么时候该分区?
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
DROP PARTITION
|
|
|
|
|
📌 分区不是银弹, 查询条件必须包含分区键 才能享受剪裁收益。
03 / 分区表长什么样?

04 / 创建分区表的三种方式
方式一:按范围分区(最常用)
方式二:按列表分区
方式三:多级分区
05 / 分区表操作(增删改查)
添加新分区
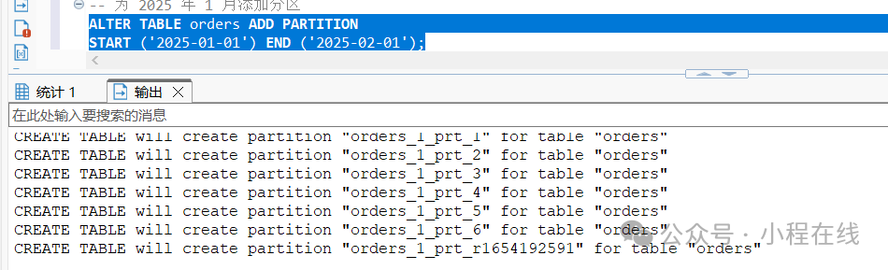
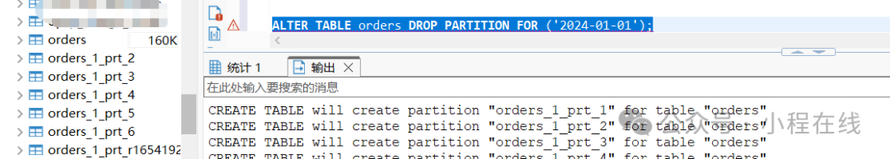
删除旧分区(秒删数据)
清空分区数据
拆分分区(细粒度)
-- 把一个月分区拆成上旬、中旬、下旬
ALTER TABLE orders SPLIT PARTITION FOR ('2024-01-01')
AT ('2024-01-11', '2024-01-21')
INTO (PARTITION jan_early, PARTITION jan_mid, PARTITION jan_late);
06 / 如何确认分区剪裁生效?
-- 查看执行计划,看是否只扫描了目标分区
EXPLAIN SELECT * FROM orders WHERE order_date = '2024-01-15';
07 / 分区表的注意事项
问题一:分区键必须出现在 WHERE 中
问题二:分区数量不是越多越好
-
分区数 × Segment 数 = 可能的内存开销
-
建议:单表分区数 不超过 1000
-
常用范围: 100-300 个分区
问题三:默认分区可能导致误扫描
📌 建议:如果历史数据不会查,就不要设默认分区;或者定期清理默认分区。
08 / 分区表 vs 其他优化手段
| 优化手段 | 适用场景 | 剪裁粒度 | 管理复杂度 |
|---|---|---|---|
| 分区表 | 按时间/枚举查询,数据可物理切分 | 分区级别 | 中等 |
| 索引 | 高选择性条件 | 行级别 | 低 |
| 分布键 | JOIN/聚合优化 | Segment 级别 | 低 |
| 列存 | 只查部分列 | 列级别 | 低 |
📌 分区表和索引 可以一起用 。先通过分区减少扫描范围,再通过索引精确定位。
写在最后
分区表是 Greenplum 大表优化的 第一板斧 。
| 你的需求 | 怎么做 |
|---|---|
| 表太大,查询越来越慢 | 按时间分区 |
| 需要定期删除历史数据 |
按时间分区 +
DROP PARTITION |
| 经常按地区/类型查询 | 按列表分区 |
| 分区后还想更快 | 加索引 |
| 快速导入当月数据 | 交换分区 |
一张能自动“跳过”无关数据的分区表,比十张普通表加起来还聪明。
END
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70051362/viewspace-3185447/ ,如需转载,请注明出处,否则将追究法律责任。

